Wiki 知识库

全部文档 / 标签: 显存优化

8 篇
清除

一个人十天写出的引擎,让 12GB 显卡跑起 1250 亿参数模型

个人开发者用十天时间(代码大部分由 AI 编写)打造了推理引擎 Strata,能让 12GB 显存的普通电脑运行 1250 亿参数的 Qwen 3.8 Flash Next 模型。文章剖析其六倍速度宣传实为不同量化版本对比,同版本实际是两到四倍;真正亮点是 prompt 读取速度达每秒 1500 token。核心技术是围绕 MoE 架构的专家缓存,命中率约 72%,代价是输出可能偏离原模型结果。文章还对比了买内存自建与云端 API 的成本账,并预判通用引擎 llama.cpp 将在几个月内补齐缓存能力。

技术 › LLM Saito 2026-10-218.8 KB 1.5K 4 84

8G显存也能跑:Qwen-Image-2.1-Turbo 去审查版本地部署 8 步出图(附 ComfyUI 工作流)

文章介绍了 HuggingFace 上 AtomicChat 发布的 Qwen-Image-2.1-Turbo GGUF 量化版及去审查文本编码器。作者澄清该编码器仅移除拒绝倾向,对画图内容几乎无影响,其真正价值在于提供低显存无损量化方案。文章详细记录在 RTX 5060(8G 显存)真机上使用 ComfyUI 部署的完整流程:4 个模型文件的下载与存放、11 节点工作流配置,以及 5 个实测踩坑与解法(工作流 JSON 参数顺序、去噪器/编码器混淆、GGUF 架构识别错误、mmproj 缺失、latent 连接问题)。实测首次出图约 2 分钟,之后每次约 1 分钟,并附 4 组提示词与量化选型表。

技术 › 工具与效率 启明破晓 2026-10-1217.4 KB 45.4K 293 92

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍了如何借助Strata框架和Agent自动化流程,在12GB消费级显卡上部署125B参数的MoE模型Qwen3.8-Flash-Next。文章解释了MoE稀疏激活(每token仅激活6B)与Strata让GPU、CPU、RAM、SSD协同工作的原理,对比了不同量化方案(UD-IQ4_XS与UD-Q4_K_XL)在专家缓存命中率上的速度差异。作者全程使用蚂蚁的Ling-3.1-flash Agent完成从读文档、检查硬件、安装、排错到测速验收的部署流程,并成功将本地模型接入pi。该方法可复用于部署Ling、GLM、Kimi、DeepSeek等其他本地模型。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 159.4K 454 79

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 79

Qwen-Image 2.1 本地部署实战:从此生图自由

本文详细介绍了 Qwen-Image 2.1 图像生成模型的三种本地部署路线:ComfyUI、Unsloth Desktop 和官方 Diffusers。作者首先解释了不同后端权重的差异,指出 DiT、文字编码器和 VAE 三件套需分别下载且不能混用。文章给出了 Windows RTX 5080 与 MacBook Pro M2 Max 两套平台的实测数据:5080 上 1MP 文生图约13秒,M2 Max 单张约10分钟。同时涵盖模型目录结构、extra_model_paths 配置、图像编辑模板用法、常见问题排查及 Qwen Research License 商用限制提醒,是一份可复现的完整部署教程。

技术 › 工具与效率 Fini.Yang 2026-09-279.9 KB 239.9K 599 88

显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

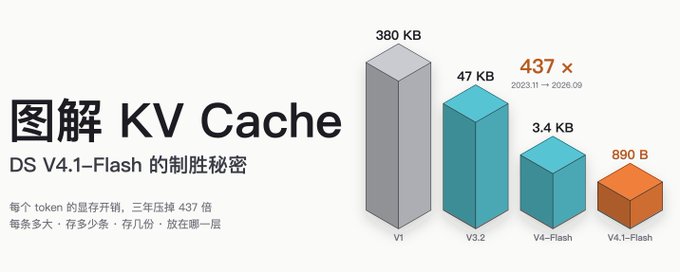
图解 KV Cache——DS V4.1-Flash的制胜秘密

本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

12G 显存,够吗?——消费级 GPU 上做 LLM 算法研究的完整路线

本文探讨了在只有 12G 显存的消费级 GPU 上进行大语言模型(LLM)算法研究的可行路线。文章指出资源限制本身可以成为研究的起点,并重新定位了研究方向为对小模型的训练算法与适配方法做贡献。文章详细计算了 12G 显存的实际边界,提出了三条可行路线(训练算法优化、结构改动、RL/推理),并介绍了如何利用 HuggingFace 生态(包括官方 Model Trainer Skill)来搭建实验环境、选择模型以及设计严格的三层验证实验(机制验证、扩展验证、现实落地)。

技术 › LLM AI最严厉的父亲 2026-04-0131.8 KB 39.4K 165 91