Wiki 知识库

全部文档 / 标签: Self-Attention

2 篇
清除

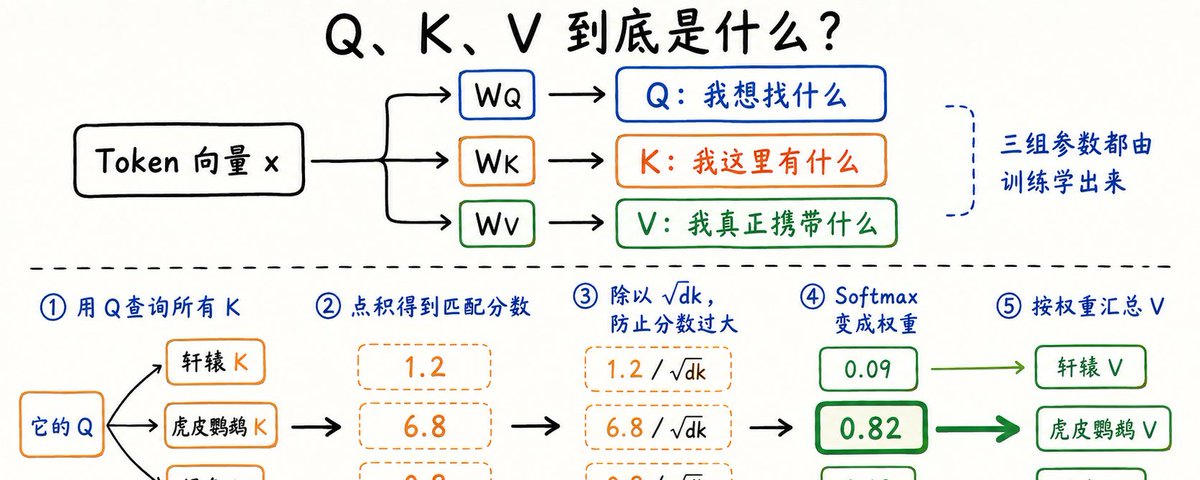
一口气搞懂 Transformer:注意力、QKV、残差连接全讲透

本文是 Transformer 架构的科普长文,作者轩辕之风回顾了从 N-gram、词向量、RNN 到 LSTM 的语言模型发展历程,指出 LSTM 串行计算和远距离信息传递的两大痛点。随后详细讲解注意力机制的核心思想,深入解释 Query、Key、Value 三者的作用与计算方式(点积、Softmax、缩放因子),以及多头注意力如何从多个角度捕捉指代、语法等不同关系。文章还介绍了位置编码解决并行计算丢失顺序信息的问题,并通过'苹果'的例子说明 Attention 负责信息收集、FFN 负责特征消化组合的分工。
技术 › LLM 轩辕之风 2026-09-0228.7 KB 31.7K 354 72

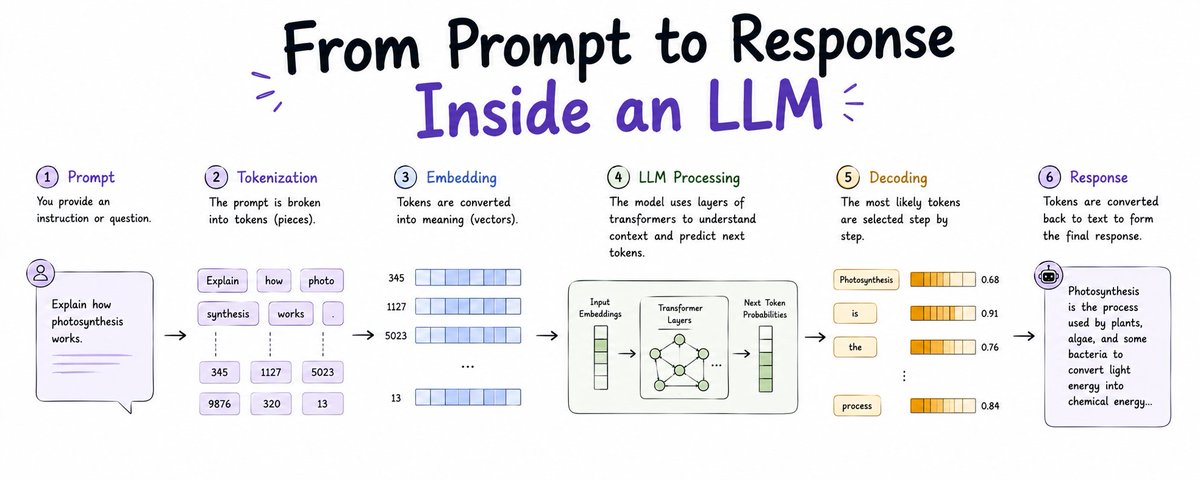
From Prompt to Response Inside an LLM: A Visual Step-by-Step Journey With Code

本文通过代码示例和可视化图表,深入剖析了大型语言模型(LLM)从接收提示到生成响应的完整内部流程。内容涵盖分词(Tokenization)、嵌入与位置编码(Embeddings and Positional Encoding)、自注意力机制(Self-Attention)等核心环节,并提供了使用tiktoken和HuggingFace库的实用代码,帮助读者理解模型如何处理文本、构建上下文并生成输出。文章旨在打破“Transformer魔法”的黑箱,为技术爱好者和开发者提供直观、可操作的LLM内部工作原理指南。

技术 › LLM Vikas gupta 2026-08-1519.6 KB 13.6K 14 77