Wiki 知识库

全部文档 / 标签: 位置编码

3 篇
清除

把Transformer底裤扒光,从Transformer到大模型

本文从零开始,深入浅出地讲解了Transformer的原理及其如何演变为大语言模型。文章首先介绍大模型的目标是预测下一个词,然后详细解释了如何将文字转换为数字,包括Token、Token ID、Embedding Matrix等概念。接着,重点剖析了Transformer的核心——注意力机制(Q、K、V)、多头注意力、位置编码、FFN以及残差连接等组件,最后概述了模型的训练过程。全文无需前置知识,适合初学者理解大模型的基础架构。

技术 › LLM 南晚Nanwan 2026-09-0944.4 KB 52.9K 157 70

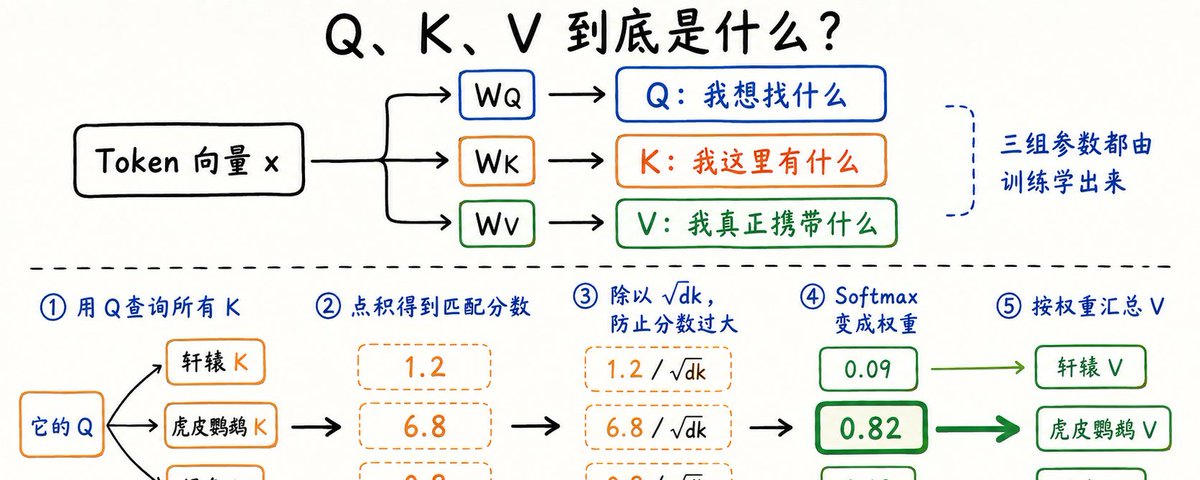
一口气搞懂 Transformer:注意力、QKV、残差连接全讲透

本文是 Transformer 架构的科普长文,作者轩辕之风回顾了从 N-gram、词向量、RNN 到 LSTM 的语言模型发展历程,指出 LSTM 串行计算和远距离信息传递的两大痛点。随后详细讲解注意力机制的核心思想,深入解释 Query、Key、Value 三者的作用与计算方式(点积、Softmax、缩放因子),以及多头注意力如何从多个角度捕捉指代、语法等不同关系。文章还介绍了位置编码解决并行计算丢失顺序信息的问题,并通过'苹果'的例子说明 Attention 负责信息收集、FFN 负责特征消化组合的分工。

技术 › LLM 轩辕之风 2026-09-0228.7 KB 31.7K 354 72

一文科普 主流 LLM 注意力机制

本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88