Wiki 知识库

全部文档 / 标签: prompt caching

8 篇
清除

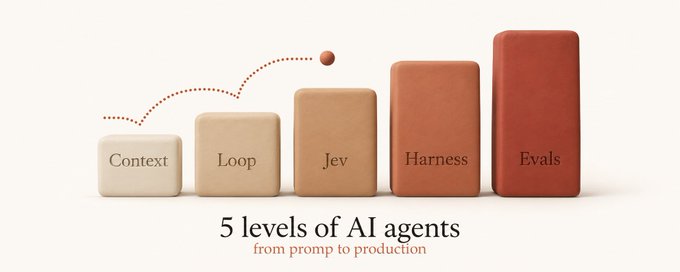
The 5 levels of AI agents: From a single prompt to a production agent

文章系统讲解了构建生产级 AI Agent 的五个层次:上下文工程、循环工程、Jev 工程、Harness 工程和评估工程,并以新员工类比逐一解释。核心内容包括:上下文窗口管理(稳定内容前置、利用 prompt caching、工具过多时改用搜索、用子代理减少主上下文占用);循环与工作流的区别(能否预先写清步骤),强调循环需要明确目标、外部检查器等四要素。每个层次都配有构建方法与面向初学者的捷径方案(通过 Viktor 这类 AI 员工工具实现)。目标是让小团队用可靠的 Agent 承担重复性工作,实现不增人力的规模扩张。
技术 › Agent Yarchi 2026-10-2622.2 KB 636.5K 411 80

Reducing cost and improving performance with Claude Platform

本文介绍如何通过三项优化在不牺牲性能的前提下降低 Claude 应用的成本:最大化 prompt cache 命中率、清理迁移到前沿模型后的提示词反模式、以及按任务校准 effort 设置。文章详细讲解了 prompt cache 的工作机制(KV 缓存、字节级前缀匹配、TTL 限制),给出监控缓存命中率、延迟加载少用工具、以消息形式更新系统提示、预加热缓存等实践技巧;同时列举了验证仪式、过度强调、过时示例、矛盾规则等反模式及其修复方法,并介绍了 claude-api skill 中的 prompt-audit 命令帮助自动检测问题。

技术 › Claude ClaudeDevs 2026-09-0921.3 KB 571.4K 4K 91

Organizing Context in a Multi-Agent Harness

本文介绍 LangChain Deep Agents 中的多智能体上下文管理机制。大多数 harness 支持子代理功能,监督者代理委派任务给子代理以实现并行推理和上下文隔离,但隔离的子代理可能重复收集监督者已有的上下文。为此 Deep Agents 引入上下文模式(context modes):isolated(隔离模式)子代理以全新上下文启动,仅接收任务描述;fork(分叉模式)子代理继承监督者的完整对话历史,借助 prompt caching 更快更省。文章给出选择原则:worker 类代理(延续监督者已完成诊断的工作)适合 fork 模式,verifier 类代理(独立评审代码)适合 isolated 模式以避免锚定偏差,researcher 类代理处理独立问题时用 isolated 更利于并行。上下文模式与工具、中间件一样,是特化子代理的重要手段。

技术 › Agent LangChain OSS 2026-09-0911.5 KB 106.7K 265 79

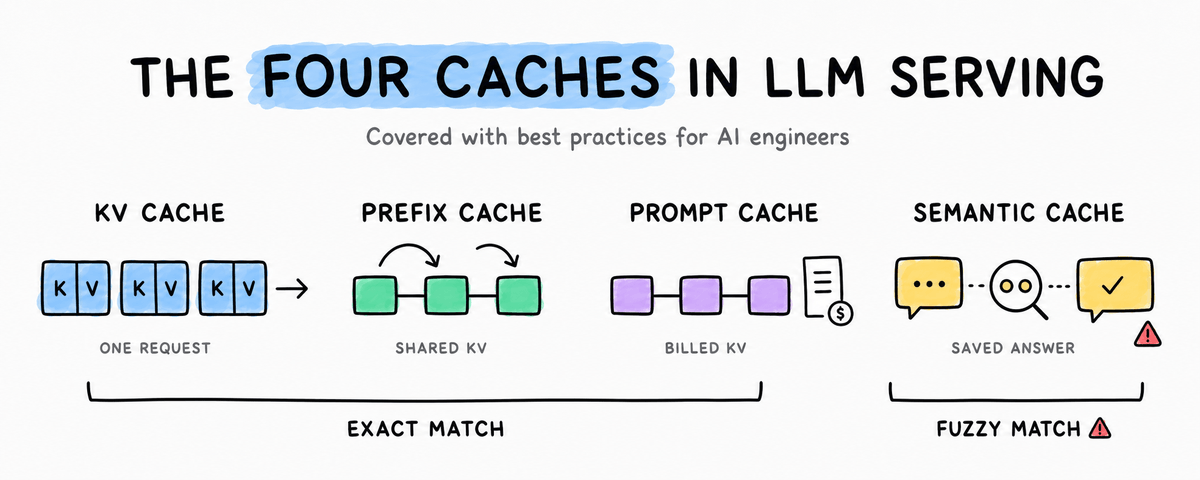
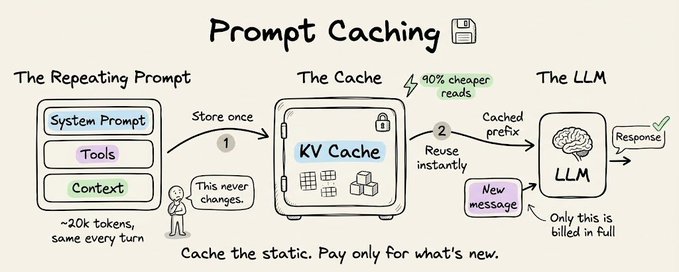
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

你不知道的 Agent:原理、架构与工程实践

本文深入剖析了 Agent 系统的工程实现,强调 Harness(测试与约束基础设施)比模型能力更关键。文章详细阐述了 Agent Loop 的稳定性、上下文分层管理以避免 Context Rot、工具设计的 ACI 原则、记忆系统的多维度分类,以及基于失败案例的评测体系。最后通过 OpenClaw 案例,展示了如何利用 Prompt Caching 和按需加载 Skills 来优化系统架构。

技术 › Agent 阿 阿里云开发者 2026-05-0260.8 KB 87

LLM 中的 Prompt Caching 技术详解:以 Claude 为例的高效缓存策略

本文深入探讨了 LLM 中的 Prompt Caching 技术,解释了其背后的 KV Cache 机制及静态/动态上下文分离原理。文章通过 Claude Code 的案例分析,展示了如何通过保持 92% 的缓存命中率来将计算成本降低 81%,并总结了哈希敏感性和工程化落地的关键约束。

技术 › LLM Avi Chawla 2026-04-2021.1 KB 755.1K 1K 87

LLM 提示词缓存原理与实战应用

文章深入探讨了LLM中的提示词缓存技术。通过区分静态前缀(如系统指令)和动态后缀(如用户消息),利用KV Cache机制避免重复计算,大幅降低长上下文任务的成本。文章以Claude Code为例,展示了如何通过保持92%的缓存命中率将成本降低81%。同时,强调了Hash缓存的脆弱性,任何微小的前缀变动都会导致缓存失效,并给出了在开发Agent时维持缓存热度的具体工程建议。

技术 › LLM Avi Chawla 2026-04-1620.9 KB 87

你不知道的 Claude Code:架构、治理与工程实践

文章基于作者半年的深度使用经验,详细剖析了 Claude Code 的六层架构体系。内容涵盖底层运作原理、上下文工程与治理成本、Skills 与 Hooks 的设计模式、Subagents 的隔离策略以及 Prompt Caching 的核心影响。文章指出 Claude Code 的核心是代理循环过程,并提供了针对工具设计、反模式规避及成本优化的实战指南。

技术 › Claude Code Tw93 2026-03-1325.3 KB 3.2M 8.9K 93