Wiki 知识库

全部文档 / 标签: 缓存优化

6 篇
清除

DeepSeek Harness vs ZCode:Token 消耗能差 10 倍的设计题

本文通过阅读 DeepSeek Harness (DSH) 0.1.7-alpha.1 源码,对比其与 ZCode 执行框架的设计差异。DSH 采用只追加的流水账机制保证可审计性,对缓存前缀极致优化以降低成本,通过三层递进方式管理上下文防止信息丢失,并内置防重复调用守卫、程序化工具调用(PTC)和超时转后台等机制。作者指出这些优势主要体现在长会话、大输出和批量工具调用场景,Token 消耗可差一个数量级;但普通短任务成败仍主要由模型智力决定,两者差距接近于零。

技术 › Harness Engineering 周尔复 2026-09-226.2 KB 7.2K 5 80

实测MiMo-V2.6:小米347万美元训出的开源模型深度评测

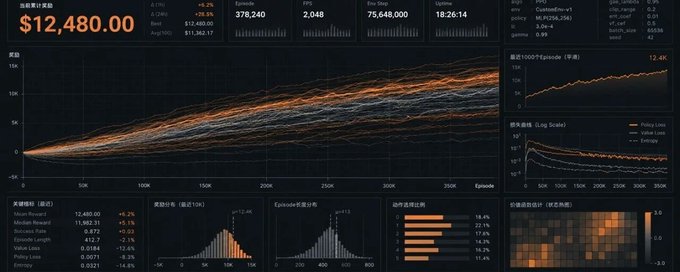
作者实测小米直播后训练的MiMo-V2.6模型。小米以直播方式公开后训练全过程,Flash和Pro合计花费347万美元,Pro在Artificial Analysis智能指数榜登上开源模型第一(46分)。作者通过五个真实任务测试:three.js程序化3D建模太和殿、高端旅行社官网前端审美、修复开源仓库真实bug、办公数据处理与核对、以及对发布仅七天的Jev模型做长程研究与幻觉控制。结果显示模型在agentic编程、审美、错误处理和事实核查上表现出色,且缓存命中率达95.7%、成本低廉,作者认为智能正走向普惠,计划将常用开源API迁移到MiMo-V2.6。

技术 › LLM 花叔 2026-09-2211.3 KB 14.5K 9 78

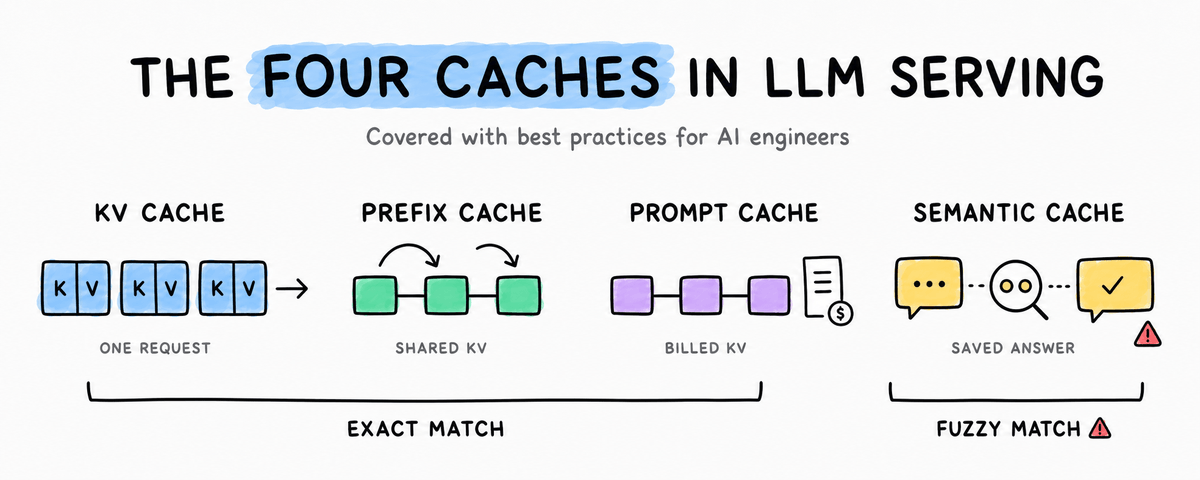
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

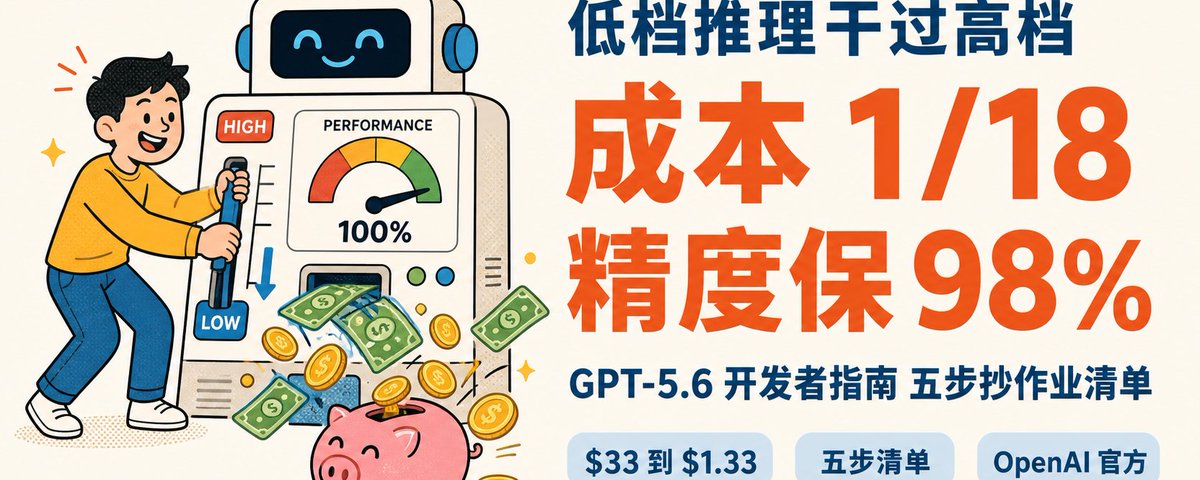
低档推理干过高档、成本 1 18 精度保 98%:GPT-5.6 开发者指南里的五步抄作业清单

OpenAI 发布 GPT-5.6 开发者指南,通过多个案例展示 agent 成本优化的巨大潜力。指南指出,通过降低推理档位、分层使用模型、利用推理持久化与压缩、Programmatic Tool Calling 及缓存优化等策略,可在保持甚至提升性能的同时大幅降低成本。文章提供了五步实操清单,帮助开发者有效控制 API 成本,并强调架构优化比单纯追求更强模型更具经济价值。

技术 › LLM Jason Zhu 2026-08-156.6 KB 1.5K 2 83

Hermes Agent 的记忆系统设计分析

文章深入分析了开源 Hermes Agent 的记忆系统架构。与 OpenClaw 不同,Hermes 不依赖单一记忆,而是采用了四层架构:极简的 Prompt 冻结记忆(MEMORY.md/USER.md)、基于 SQLite 的会话搜索、程序化技能以及可选的 Honcho 层。其核心设计理念是保持 Prompt 稳定以利用缓存,并将历史细节剥离至外部工具按需检索。

技术 › Hermes Manthan Gupta 2026-04-3032.2 KB 535.7K 943 74

驾驭 Claude 的智能 | 构建应用的 3 个关键模式

本文探讨了如何随着 Claude 能力的进化,调整构建 AI 应用的策略。文章提出了三个核心模式:善用 Claude 已知的通用工具(如 bash 和文本编辑器),赋予其自主编排和上下文管理能力,以及谨慎设定框架边界以平衡安全与效率。文章强调了减少外部框架对模型能力的过度干预,让 Claude 自主决定工具调用与数据处理,从而提升应用的性能和成本效益。

技术 › Agent 宝玉 (译) / Lance Martin 2026-04-0321.0 KB 41.8K 264 90