Wiki 知识库

全部文档 / 作者: Avi Chawla / 标签: DeepSeek

3 篇
清除

Build your own Jev (100% local):用开源 LLM 构建本地决策引擎

文章介绍如何将开源 LLM 变成快速、本地的决策引擎,而无需重新训练。核心思想是:当应用已知所有可能的答案时,不必让模型生成文本或 JSON,而是通过 next-token scoring 一次性为每个候选答案返回分数和概率分布。作者讲解了固定答案打分与结构化输出的区别、LLM 第一个输出 token 的生成原理,并使用 SGLang 的 /v1/score 接口,结合 Qwen 和 DeepSeek 模型进行实测,与普通文本生成进行了基准对比。文中还提到概率的含义与校准问题。

技术 › LLM Avi Chawla 2026-09-2022.3 KB 1.1M 3.1K 76

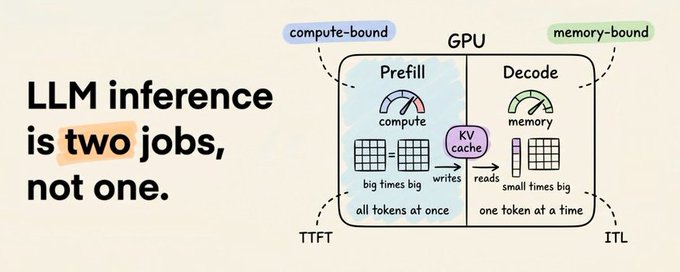
LLM 推理原理详解:从 Prefill 到 Decode

本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。

技术 › LLM Avi Chawla 2026-06-2923.7 KB 320.3K 776

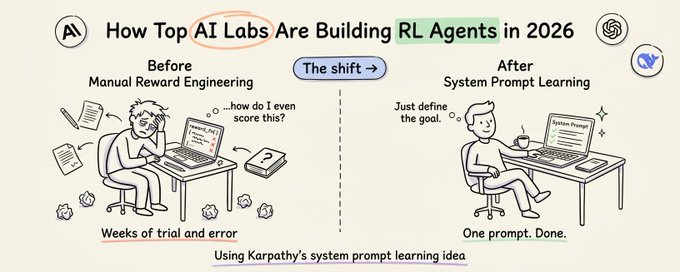
顶级AI实验室如何构建RL智能体:从RLHF到RULER的演进

文章探讨了 Anthropic、OpenAI 和 DeepSeek 等顶尖 AI 实验室在 2026 年关于强化学习(RL)的趋同思路,即使用系统提示作为奖励函数。内容详细梳理了 RL 在 LLM 中的应用历程,从 RLHF 到 RULER(Karpathy 提出的系统提示学习概念)的演变。重点介绍了 DeepSeek R1 利用可验证奖励(RLVR)突破传统瓶颈的机制,通过规则编译器直接提供信号,并结合 GRPO 算法移除了复杂的 Critic 和奖励模型,实现了从 15.6% 到 77.9% 的 AIME 数学成绩飞跃。

技术 › LLM Avi Chawla 2026-04-2863.5 KB 857.5K 502 74