Wiki 知识库

全部文档 / 标签: RL

12 篇
清除

斯坦福机器人学免费课程:6个月成为机器人学习工程师的学习路径

作者整理了一份利用斯坦福免费公开课程资源、历时6个月成为机器人学习工程师的自学路径。斯坦福将大量机器人学课程发布在YouTube上,讲师包括NVIDIA自动驾驶研究高级总监、Physical Intelligence联合创始人及Tesla Optimus AI负责人。该路径包含7门课程共119讲、约95小时视频、2本免费教材、6个可在家用笔记本上完成的练习项目,以及可选的122美元机械臂。学习顺序遵循斯坦福正式课程体系:先数学基础(线性代数),再机器人物理结构、感知、规划,最后是学习方法,避免了自学时无序观看导致的低效问题。

技术 › 编程语言 Martin 2026-09-2633.6 KB 190.3K 650 82

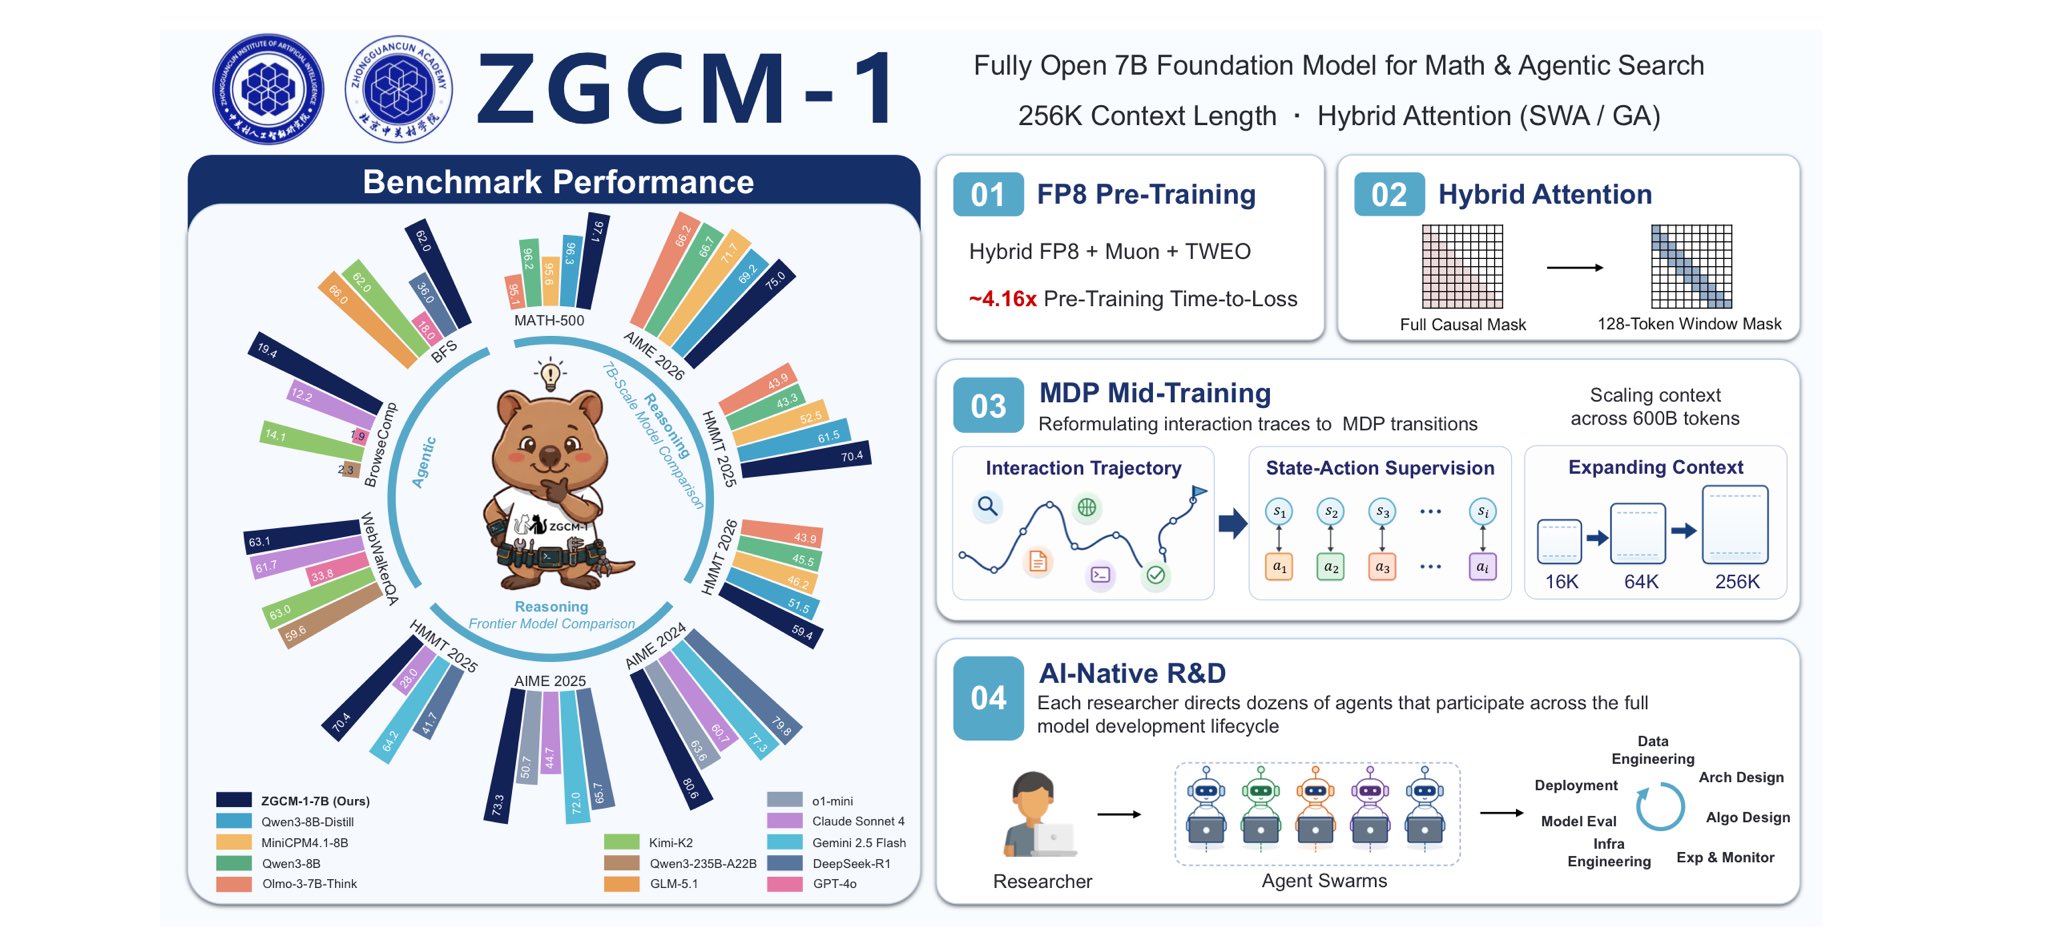
中关村学院 3 个月从零训练 7B SOTA 模型的启示

作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。

技术 › LLM Bojie Li (@bojie_li) 2026-09-262.6 KB 63

MiMo-V2.6 复盘:Agent RL 的规模化之路

文章解读小米罗福莉关于 MiMo-V2.6 的 RL 复盘,探讨 RL 能否像预训练一样规模化。MiMo-V2.6 单次更新抽取 1568 个任务、每任务 16 条 rollout,一个 Step 生成约 2.5 万条 Agent trajectory。文章指出 Agent RL Scale 的三大难点:需要 7000 多个 RL Task Environment 供模型进入;将 Harness 混入训练实现跨 Harness 迁移能力(You Only RL Once);以及需要强大的 Grader 评估轨迹质量并对抗 Reward Hacking。作者认为未来模型公司的核心能力是建造 Experience Factory,让模型通过大量真实经历实现下一轮 Scaling。

技术 › LLM sleepy.md (@sleepy0x13) 2026-09-225.5 KB 75

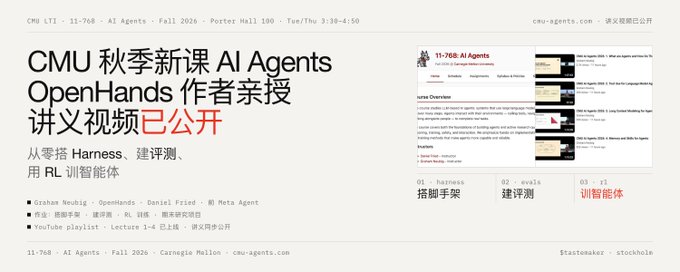
CMU 秋季新课 AI Agents:OpenHands 作者亲授,从零搭 Harness、建评测、用 RL 训智能体

CMU LTI 2026 年秋季新开研究生课程 11-768: AI Agents,由 OpenHands 核心开发者 Graham Neubig 与 Daniel Fried 共同讲授。课程以"搭 harness→建评测→RL 训练→做研究"流水线为主线,涵盖工具调用、上下文管理、技能与记忆、规划、安全、框架实践等模块,密集邀请一线学者客座授课。作业要求学生在开源 LLM 之上从零实现 ReAct Agent、设计评测框架并完成 SFT/RL 训练,工程细节对标生产级 Agent 系统。期末研究项目占 50% 成绩。PPT、视频与作业仓库全部公开,是目前系统学习 LLM Agent 建造、评测与训练最完整的公开课程。

技术 › Agent meng shao 2026-09-0911.6 KB 94.6K 569 86

GLM 5.3: Scaling with Post-training, Intuitively Explained

文章解析了 GLM-5.3 如何在不重新预训练的情况下,仅通过规模化后训练(RL)超越 GLM-5.2,印证了 Sutton 的苦涩教训。重点包括:一是面向真实专家工作的环境设计,用研究代理生成长时程任务,配合严格的验证器三重检查防止 reward hacking;二是沿用 GLM-5.2 的 MoE 架构(744B 总参、~40B 激活),采用 MLA 压缩 KV cache、DeepSeek 稀疏注意力降低长上下文成本、MTP 投机解码平均每次接受约 4.5 个 token,以及 IndexShare 在相邻层共享索引实现 2.9 倍 FLOPs 节省;三是 SAO 算法与 slime 基础设施,将低廉的 rollout 转化为稳定的大规模后训练。

技术 › LLM Alex Ker 2026-08-2913.2 KB 103.9K 410 77

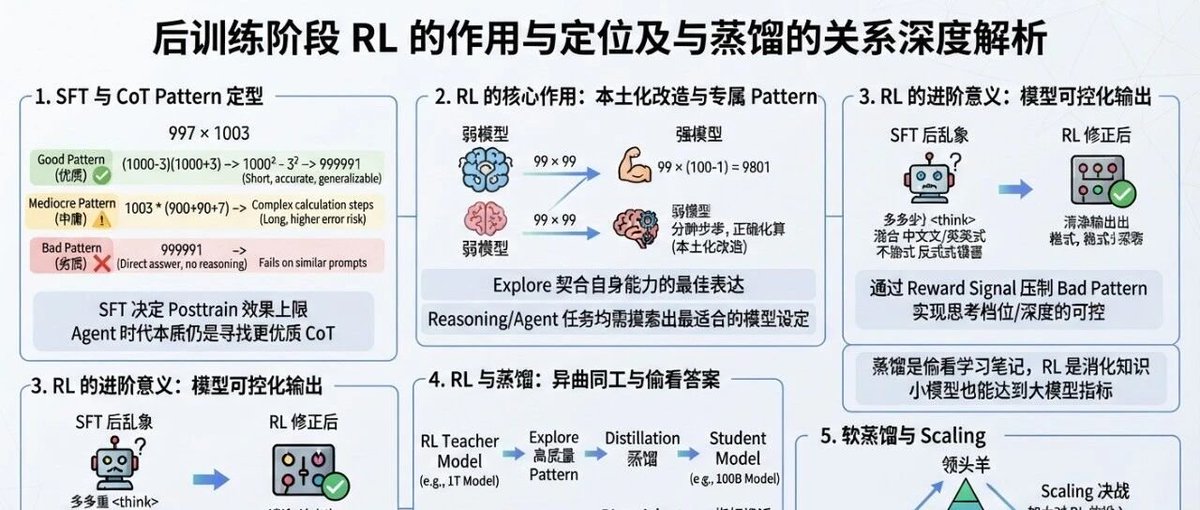
从 RL 到蒸馏,再到软蒸馏:Why RL Matters?

本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。

技术 › LLM ybq 2026-08-1611.6 KB 5.2K 43 73

如何教授 AI 模型

文章通过人类学习的类比,通俗易懂地解释了 AI 模型如何学习新技能和行为。它涵盖了从预训练、监督微调到强化学习的三个阶段,以及通过基准测试评估模型和通过模型规范对齐模型行为的重要性,最后指出了当前模型在持续学习方面的局限性。

技术 › LLM Lee Robinson 2026-07-248.2 KB 218.8K 2K

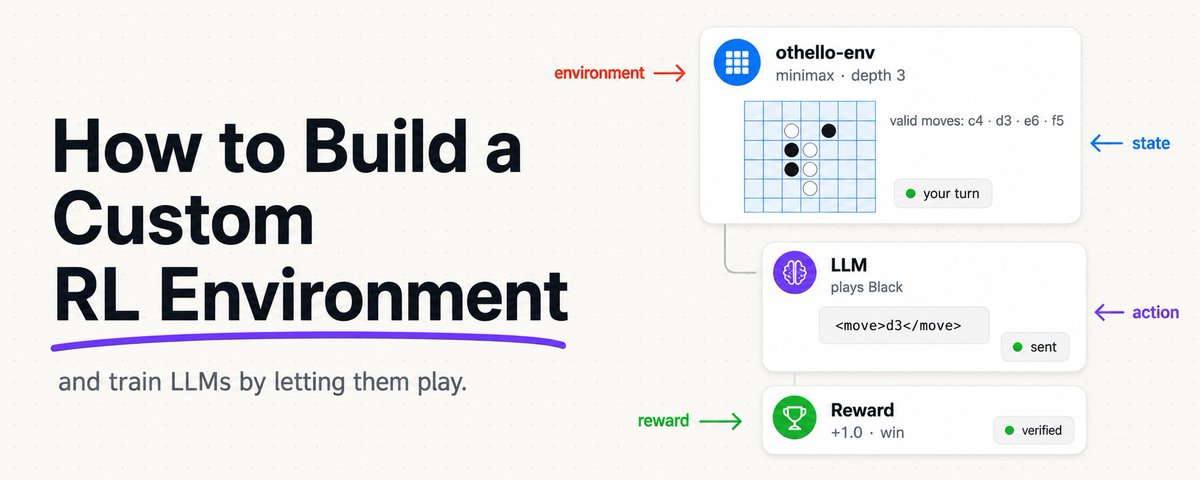
如何从头构建一个 RL 环境:以 Othello 游戏为例

本文介绍了如何使用 Prime Intellect 的 Verifiers 框架从零开始构建一个用于强化学习(RL)的 Othello(黑白棋)游戏环境。文章解释了 RL 循环的基本组成部分(状态、动作、奖励、环境),并利用 GRPO 算法替代传统的人工偏好模型。文中详细展示了技术栈、游戏循环逻辑以及内置的 Minimax 对手引擎代码,旨在帮助开发者理解并掌握构建模型无关的 RL 环境的核心方法。

技术 › Agent Akshay 2026-07-0730.5 KB 61.5K 178

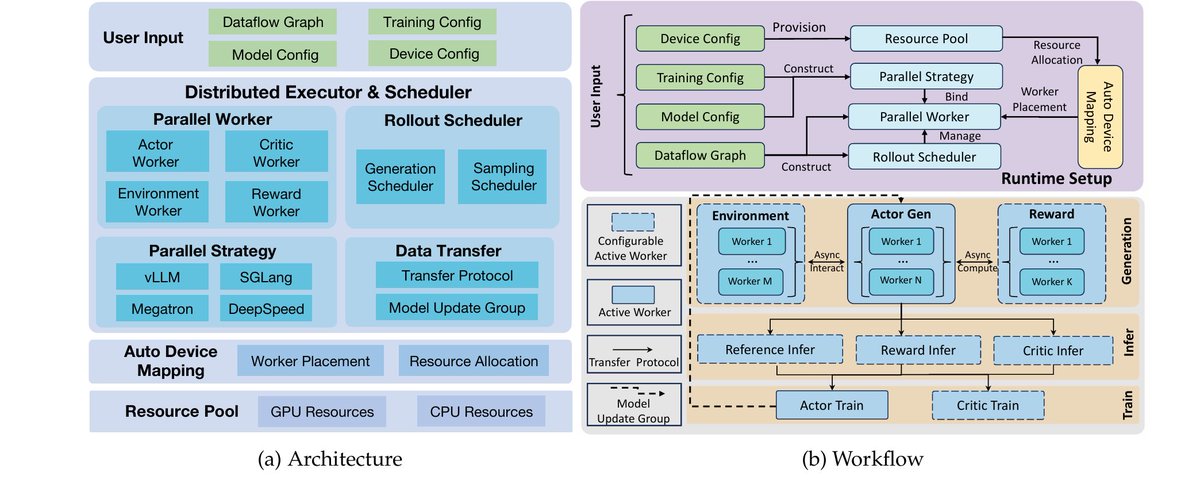
2026年强化学习面试题库:算法与基础设施

本文汇总了35道2026年强化学习(RL)领域的面试核心问题。内容涵盖算法与基础设施两大方向,既包括PPO、GRPO等训练机制的原理探讨,也涉及分布式推理、显存优化等工程落地细节。作者强调现代RL岗位需要具备全栈理解能力,建议面试者不仅要熟记问题,更需深究背后的技术逻辑。

技术 › LLM Xiuyu Li 2026-06-085.6 KB 381.8K 2K

打造公司大脑的一年经验总结

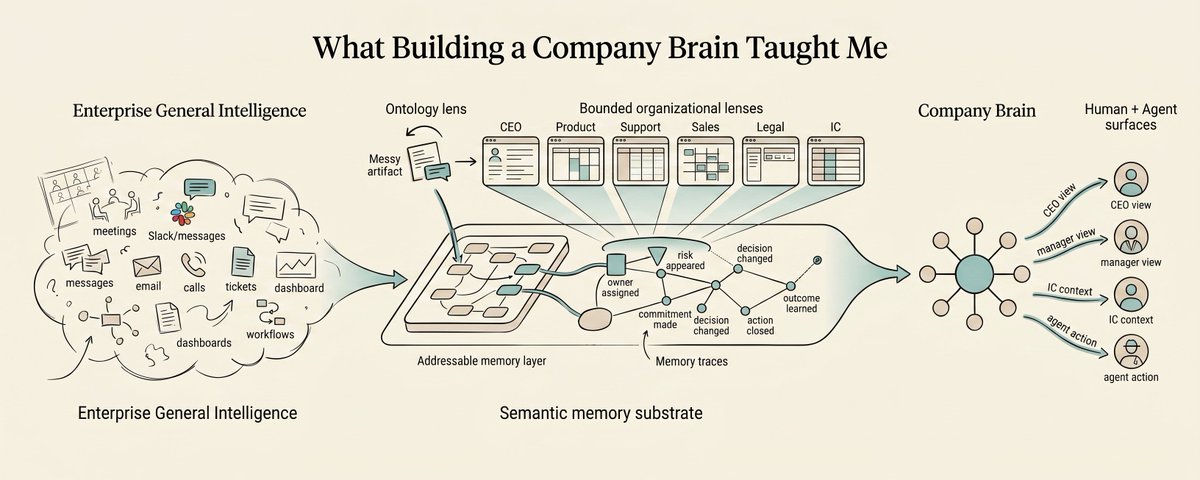
本文分享了作者构建“公司大脑”系统的经验。核心观点包括:企业智能将从单纯的知识库转向基于本体的记忆系统;公司记忆应自发于日常工作流而非简单的转录;系统需支持基于角色的多种本体视角,以解决不同部门对同一信息不同理解的问题;最终目标是建立企业的世界模型,通过强化学习机制,降低信息传递延迟,实现上下文实时感知与智能响应。

技术 › Agent Ashwin Gopinath 2026-05-0727.6 KB 64.5K 504 81

SFT、RL 与 On-Policy 蒸馏:原理与差异

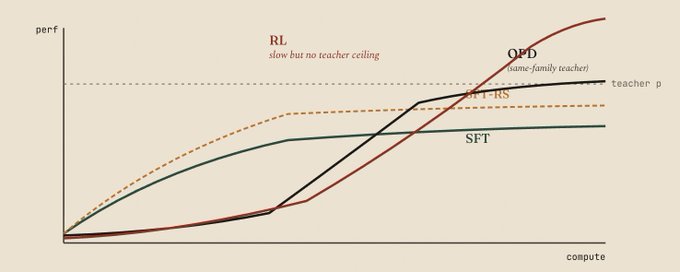
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。

技术 › LLM will brown 2026-05-0150.2 KB 72

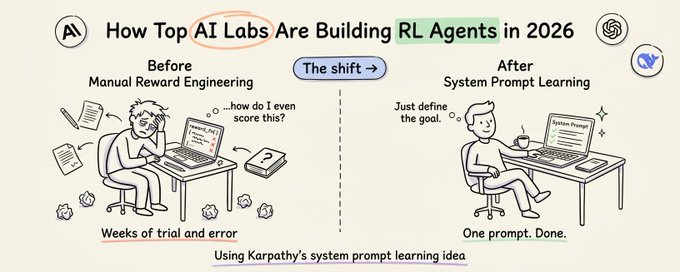
顶级AI实验室如何构建RL智能体:从RLHF到RULER的演进

文章探讨了 Anthropic、OpenAI 和 DeepSeek 等顶尖 AI 实验室在 2026 年关于强化学习(RL)的趋同思路,即使用系统提示作为奖励函数。内容详细梳理了 RL 在 LLM 中的应用历程,从 RLHF 到 RULER(Karpathy 提出的系统提示学习概念)的演变。重点介绍了 DeepSeek R1 利用可验证奖励(RLVR)突破传统瓶颈的机制,通过规则编译器直接提供信号,并结合 GRPO 算法移除了复杂的 Critic 和奖励模型,实现了从 15.6% 到 77.9% 的 AIME 数学成绩飞跃。

技术 › LLM Avi Chawla 2026-04-2863.5 KB 857.5K 502 74