Wiki 知识库

全部文档 / 作者: Builder (@UPing123zzz)

7 篇
清除

DS Bot开源了,那Grok Bot 和 DS Bot,到底该选哪个?

文章对比了社区开源的 DS Bot(DeepSeek-Bot)与 Grok Bot 两款多角色 AI 助手。核心差异在于'动手能力':Grok Bot 提供托管云电脑,可操作浏览器、跨网站执行任务且合盖继续运行;DS Bot 内置浏览器仅能读网页,但支持自选模型、MCP/Skills 扩展和可检查的 Markdown 记忆。文章从网页操作、模型控制权、数据与权限、成本等维度给出选购建议:不想维护、需要网页自动化选 Grok Bot;已有 API、重视控制权选 DS Bot。作者建议先用一个每周固定任务实测,再决定是否扩展。

技术 › Agent Ethan 恩宇 2026-10-257.2 KB 1.3K 1 85

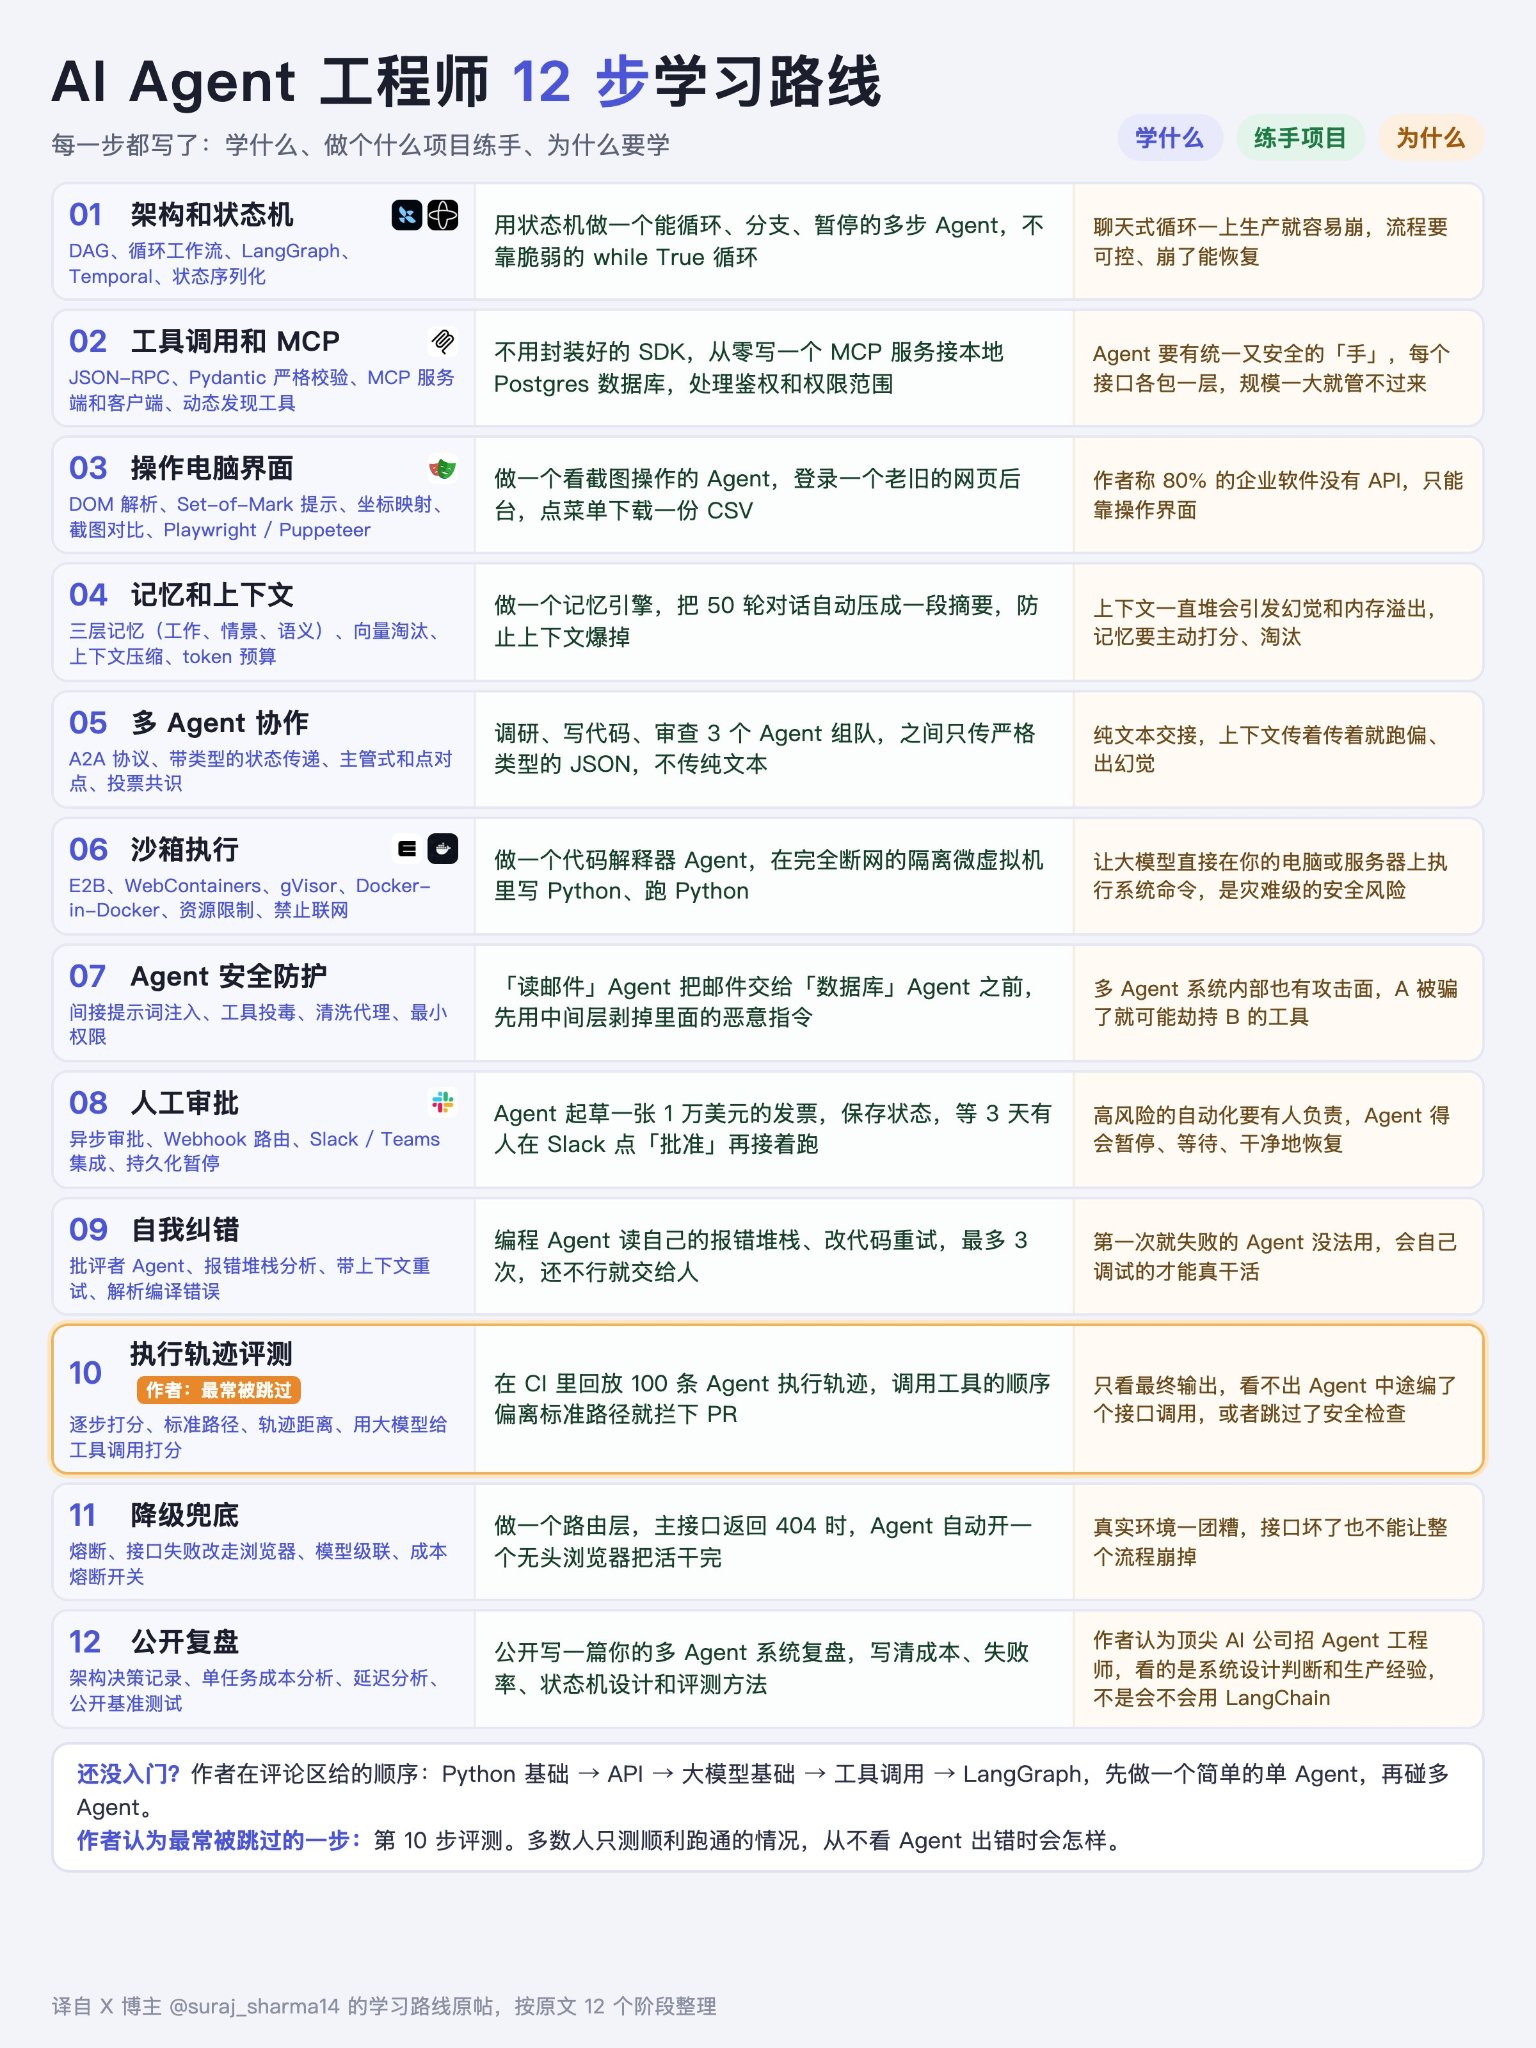
AI Agent 工程师 12 步学习路线图:从 Demo 到企业级落地

文章指出许多人做 AI Agent 只是调用大模型 API 加上工具和 LangGraph,跑通 Demo 与企业级生产落地之间差距巨大。作者结合自身企业 AI 项目经验,将 Agent 工程师学习路线分为四个阶段:一是掌握基础,理解 Agent 工作原理;二是赋予执行能力,包括 MCP、浏览器自动化、记忆与上下文管理、沙箱与权限控制;三是安全、多 Agent 协作与人工审批,明确权限边界,防止错误放大;四是错误处理、执行轨迹评测、降级兜底与工程复盘。作者强调评测数据是判断系统优劣的关键,建议边做边学,完整交付一个项目比做十个 Demo 更有价值,真正稀缺的是能让 Agent 稳定运行的工程能力。

技术 › Agent Ethan 恩宇 (@UPing123zzz) 2026-10-207.0 KB 74

2026,中国 GEO 入行:别卖“AI 第一名”,先把一单生意做明白

文章剖析中国 GEO(生成式引擎优化)行业的现状与入行路径,指出 AI 提及不等于客户成交,反对夸大宣传和造假式优化。作者区分 SEO、GEO、AEO 与私有 RAG 的差异,提醒勿拿 7 亿 AI 用户偷换市场规模。文章给出按四种交付物(诊断、资料、技术、运营)拆分报价的方法,设计四周试点流程,包括事实库、问题库、合法发布与同口径复测,并以假设案例演示 6000 元订单的真实成本核算。最后列出六个行业坑及合规边界,建议把预测转化为可检查项,守住诚实交付的底线。

技术 › LLM Ethan 恩宇 2026-10-1219.7 KB 1.7K 7 93

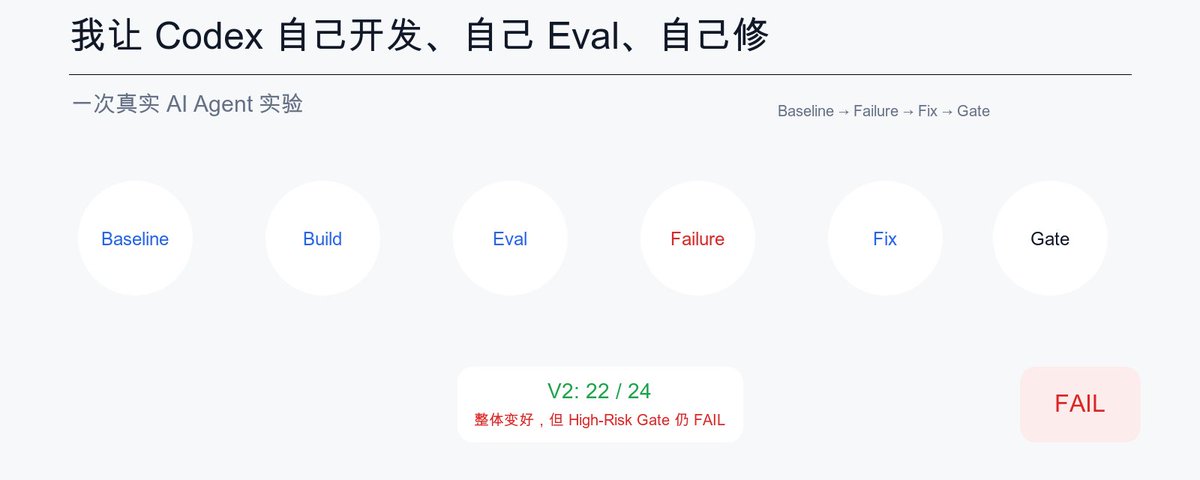
我让 Codex 自己开发、自己 Eval、自己修:一次真实 AI 工作流实验

作者以真实 GEO 视频工作流中的语义素材检索模块为实验对象,构建了 24 个 Case 的测试集,让 Codex 遵循「Baseline 考试 → 失败分析 → 最小修改 → 重新考试 → Release Gate 判定」的闭环流程自主工作。Baseline 通过率 79.17%,通过分析 5 个失败案例的共同点,Codex 仅增加一层确定性的 Query Rewrite,通过率提升至 91.67%,且无回归案例,但高风险 Case 未改善。最终 Release Gate 判定 FAIL,作者强调 Eval 让 AI Coding 从「生成代码」走向「对结果负责」,人类应聚焦于定义目标、边界和质量标准。

技术 › Codex Builder 2026-08-2911.0 KB 5.1K 38 85

我把 Eval 装进 Codex 后,AI Coding 的工作方式变了

作者分享了将 Eval(评估体系)融入 Codex 工作流后的实践心得。核心观点是:AI Coding 越强,Eval 越重要,因为 Build 变便宜了,但'什么叫完成'并未变简单。文章指出 Tests Passed 不等于任务正确,Testing 是底线,Eval 是交付线。作者重构了工作流程:Baseline → Build → Test → Eval → Analyze → Fix → Re-Eval → Release,强调先跑 Baseline 而非上来就改 Prompt,利用失败分类找出瓶颈,通过 Release Gate 定义验收标准。同时提出 Ground Truth 必须由人工确认,AI 不能既出题又评分。最终结论:人应从让 AI 写代码,转向给 AI 定义验收标准。

技术 › Codex Builder 2026-08-2911.1 KB 18.6K 142 85

什么是 Eval?为什么它决定了 AI 项目能不能真正落地

文章系统讲解了 Eval(评估)在 AI 工程中的核心地位。作者将 Eval 比喻为'给 AI 考试',介绍了构成评估闭环的关键要素:Golden Set(考题库)、Rubric(评分标准)、评分方式(规则、人工、LLM-as-a-Judge)和 Eval Report(成绩单)。文章指出没有 Eval 的 AI 开发容易沦为'凭感觉调 Prompt',无法回答版本是否真的提升、幻觉率是否下降等关键问题。作者强调 AI 项目应遵循 Build → Eval → Analyze → Improve 的迭代流程,Eval 是 AI FDE 的核心能力,'能运行'和'可交付'之间隔着一套完整的评估体系。

技术 › LLM Builder 2026-08-2814.6 KB 30.8K 290 78

重新理解企业 RAG:从知识工程到 AI 基础设施

本文指出企业级 RAG 绝不仅是简单的文档切块与向量检索,而是一项复杂的知识工程。文章详细拆解了知识入库与用户提问两条流水线,强调了 PDF 结构化解析、混合搜索及权限更新的重要性。在 AI Coding 时代,底层代码可交由 Agent 完成,开发者应更关注 RAG 的架构设计。最终,企业 RAG 的核心价值在于构建一层可被 AI 调用的知识基础设施,从而支撑各类业务 Agent。

技术 › LLM Builder (@UPing123zzz) 2026-08-103.6 KB 71