Wiki 知识库

全部文档 / 标签: 成本对比

8 篇
清除

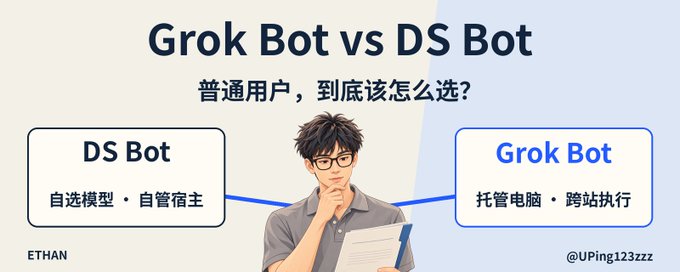
DS Bot开源了,那Grok Bot 和 DS Bot,到底该选哪个?

文章对比了社区开源的 DS Bot(DeepSeek-Bot)与 Grok Bot 两款多角色 AI 助手。核心差异在于'动手能力':Grok Bot 提供托管云电脑,可操作浏览器、跨网站执行任务且合盖继续运行;DS Bot 内置浏览器仅能读网页,但支持自选模型、MCP/Skills 扩展和可检查的 Markdown 记忆。文章从网页操作、模型控制权、数据与权限、成本等维度给出选购建议:不想维护、需要网页自动化选 Grok Bot;已有 API、重视控制权选 DS Bot。作者建议先用一个每周固定任务实测,再决定是否扩展。

技术 › Agent Ethan 恩宇 2026-10-257.2 KB 1.3K 1 85

How To Use Decision Models for Evals

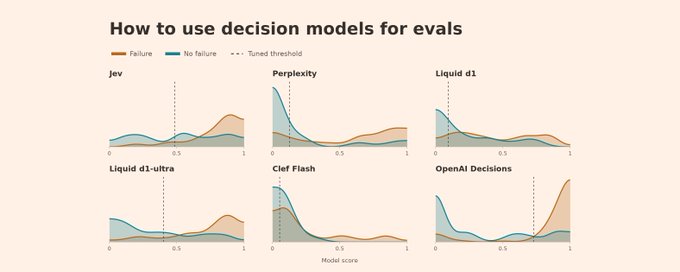
文章介绍了决策模型(如 TypeSafe 的 Jev、Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef、OpenAI 的 Decisions API)作为 LLM judge 的低成本替代方案在自动化评估中的应用。作者基于 100 条公寓租赁 Agent 的对话轨迹,测试各模型识别失败案例的性能与成本,并重点讲解决策阈值的调优:默认阈值 0.50 未必适合具体任务,需根据精确率与召回率的业务权衡(如 F1 优化或最低 80% 双重要求)来选择阈值。文章还提供了用编码 Agent 进行阈值调优的示例提示词,并讨论了校准与分数解释等实用方法。

技术 › LLM Hamel Husain 2026-10-2117.5 KB 318.2K 2.3K 84

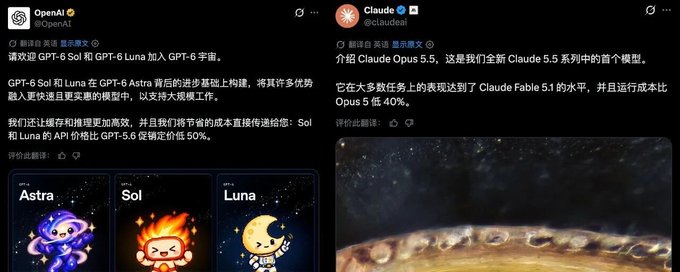
当AI模型开始拼每项工作的成本:OpenAI 和 Anthropic 新模型同日降价对比

2026年9月23日,Anthropic发布Claude Opus 5.5,OpenAI随后推出GPT-6 Sol和Luna,三家新模型共同卖点是降价:Opus 5.5单价降20%,Sol和Luna较前代降约50%。文章结合Artificial Analysis独立评测指出,标价之外,实际成本还受输出token数、缓存、effort和重试影响,三款模型能力分属不同档位,不能直接对比。作者建议以固定材料、工具链和验收标准的真实任务实测交付质量与单任务成本,用通过验收的单任务成本作为选型指标。文章还讨论了Dario Amodei《We Must Pace the Frontier》放缓主张与Opus 5.5发布是否矛盾的问题。

技术 › LLM 造物有心 2026-09-239.1 KB 2.5K 15 80

一夜三连发,Claude Opus 5.5、GPT-6 Sol和Luna全部都来了

Anthropic与OpenAI同日发布多款新模型:Claude Opus 5.5、GPT-6 Sol和Luna。作者详细评测了各模型的定位与表现:Opus 5.5作为Claude系列性价比模型,Coding能力达到SOTA,成本下降40%,速度提升30%,但Token消耗大;GPT-6 Sol和Luna主打降本,价格比上代便宜50%甚至低于Deepseek,Token效率出色、幻觉率大幅降低,但审美与细节能力有明显降级。作者指出两家公司差异化路线:Anthropic专注Coding通往AGI,OpenAI专注全面Agent能力,并给出不同场景下的模型选择建议。

技术 › LLM 数字生命卡兹克 2026-09-2316.6 KB 43.1K 126 77

Jev 模型实测:新闻分类任务上的速度、质量与价格三赢

作者分享了使用新模型 Jev 对《人民日报》新闻进行湖北相关元素分类的实测体验。此前该项目一直使用 Gemini Flash Lite 系列,积累约 2.4 万条数据。通过 OpenRouter 上线 Jev 后用相同提示词对比测试:速度上单篇耗时从 3 秒降至 0.35 秒,提升近 10 倍;质量上与 Flash Lite 仅 15% 判断不一致,且差异多源于人名知识库差异,实际正确率约 95%;价格上处理 5 千条数据 30M Token 仅花费 1 美元。作者认为 Jev 代表的分类器大模型在分类场景下实现了速度/质量/价格的不可能三角,极具前景,并计划连夜用于优化生产项目。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-195.0 KB 75

DeepSeek V4.1 Flash 正式发布,全面超越自家 Pro 模型?实战测评

DeepSeek 发布 552B 参数的开源 MoE 模型 V4.1 Flash,原生支持多模态视觉理解,官方称其性能、费用、速度全面超越 V4 Pro,V4 Pro 将于 9 月 14 日下线。作者通过两个实战项目(3D 程序化城市生成器、基于 draw.io 的 AI 智能绘图工具)横向对比 V4.1 Flash、V4 Pro 和 GLM-5.3-Flash。结果显示 V4.1 Flash 完成度最高,输出速度达 287 TOK/s,成本仅约 5 元/项目,多模态能力让前端开发质量明显提升,最终结论是梁神回归,可重新推荐为日常 AI 编程模型。

技术 › LLM 程序员鱼皮 2026-09-1012.8 KB 4.8K 12 73

Codex 实测一个月:替代 Claude Code 的高性价比工作流

作者经过一个月实测,发现 Codex 在常规自动化任务上仅需 Claude Code (CC) 十分之一的花费($15 vs $155),且通过并行工作流效率提升显著。文章对比了两者优劣:Codex 依托 GPT-5.5 速度快、生态开源、中转稳定,但安全审核严格;CC 擅长复杂重构和逆向工程。作者还分享了权限配置、Superpowers 技能安装及多任务并行等实战技巧。

技术 › 工具与效率 百 百年 AI×出海 2026-05-0211.0 KB 90

OpenClaw vs Hermes:AI 领域最激烈的竞赛与深度对比

文章详细对比了 2026 年 GitHub 上最热门的两个个人 AI Agent 项目:OpenClaw 和 Hermes。OpenClaw 拥有成熟的技能生态、极致的模型灵活性及强大的多代理架构,适合追求掌控和定制的开发者;而 Hermes 由 Nous Research 开发,具备“自学习”机制、极低的 Token 成本及开箱即用的体验,更适合追求效率和稳定性的用户。这并非好坏之争,类似 Windows 与 Mac 的哲学差异。

技术 › Agent jordy 2026-04-2423.7 KB 70.6K 377 79