Wiki 知识库

全部文档 / 作者: Cloris / 标签: LLM

6 篇
清除

AI 落地的四道坎 -- 本体、评估、信任、维护 | 峰会洞察 02

本文是硅谷101 Alignment 峰会 Day 1 下半场的深度纪要,总结出 AI 落地的四道坎:本体、评估、信任、维护,且四道坎都不在模型本身。机器人领域模型大小被物理参数封顶,数据质量与多样性之争可统一为数据金字塔,触觉数据与跨本体抽象是关键;世界模型定义仍在发散,AMD 收购 World Labs 释放垂直整合信号,评估工具的缺失是最大短板;Agent 的真正瓶颈是信任而非模型,企业需渐进开放权限,云端 agent 基础设施有大量脏活,交互范式需摆脱聊天框。作者结合一线信号给出创业与投资判断。

技术 › Agent Cloris 2026-10-1388.1 KB 8.2K 22 82

AI 如何加速药物发现?| AI4S 投研系列 01

文章以英矽智能 18 个月完成候选物提名的 rentosertib 项目为案例,系统梳理 AI 在药物发现四个环节的作用:找靶点、预测蛋白结构(如 AlphaFold)、设计分子和用 Agent 串联研究流程。作者强调核心价值在于扩大搜索范围、把部分试错提前到实验之前,但项目提速是数据、AI 和团队共同的成果,候选分子离患者获益还很远。文末提出判断'AI 制药突破'的四个问题:完成了什么、快的是哪一段、和谁比、失败算没算进去,提醒区分模型高分、项目提速与临床获益。

技术 › AI4S Cloris 2026-10-0922.6 KB 8.9K 47 88

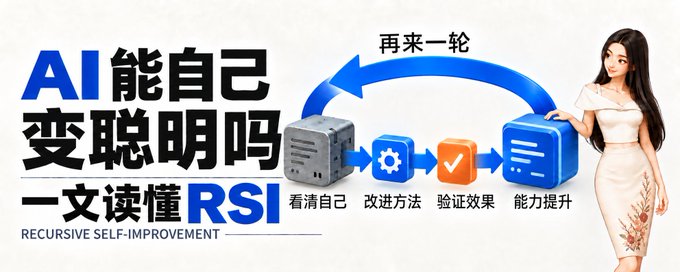
一文读懂 RSI:AI 能自己变得越来越聪明吗?

文章系统科普了递归式自我改进(RSI)的概念:会反思、改答案或保存记忆并不等于真正的自我进化。真正的 RSI 要求改动深入权重、工具或研发流程,且升级后的系统能更有效地进行下一轮升级。文章梳理了从输出级、学习级、工作流级到研发级的技术进展(Self-Refine、STaR、DGM、AlphaEvolve 等),解释了完整 RSI 尚未出现的原因:评估困难、奖励投机、边际收益递减与减速机制。最后给出安全治理框架和判断 RSI 声明真伪的八问验货清单。

技术 › LLM Cloris 2026-09-2217.7 KB 64.2K 101 85

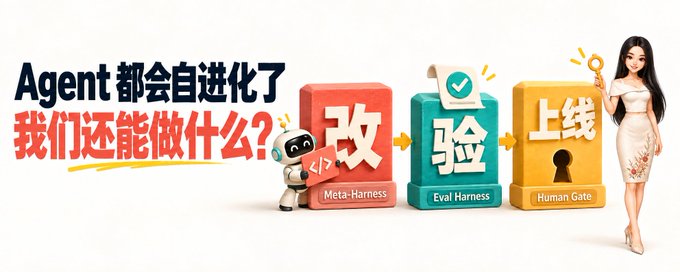
Agent 都会自进化了,我们还能做什么?

文章探讨了 Agent 自动改进系统(Meta-Harness)的构建方法。核心问题是如何让 Agent 自动进步又无法伪造进步。作者提出将三种权力拆开:Agent 负责提出修改,评测系统负责拿证据,上线门禁决定是否升级。文章通过一个补货建议 Demo,演示了从失败记录到修改验证的完整闭环,包括锁定 Agent 不可修改的文件(密封考题、评分器、上线标准)、生成结构化故障单、构建逐层收窄的评测漏斗等实践。同时分析了 Agent 容易刷分的三种捷径:讨好评分器、记住考题、自己宣布通过,并指出 Meta-Harness 只在基础 Eval 成熟、人工改进成为瓶颈时才值得搭建。

技术 › Agent Cloris 2026-09-1817.5 KB 85.7K 127 84

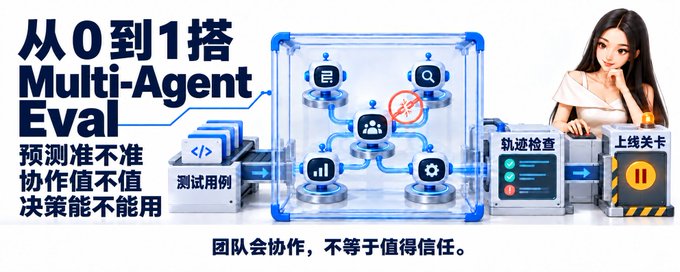
从 0 到 1 搭 Multi-Agent Eval:预测准不准,协作值不值,决策能不能用

本文介绍如何为多 Agent 团队搭建评估体系,以电商场景为例,通过五步流程:设计含陷阱的测试用例、保存 trace 回放协作过程、用结果/协作/决策三张成绩单分别评分、与单 Agent 及重试基线在同等预算下对比、将失败案例加入回归集。文章强调交接信息完整性、冲突解决、角色消融与协调增益等关键检查点,并给出可直接运行的最小 harness 代码示例。

技术 › Agent Cloris 2026-09-1119.0 KB 43.9K 84 83

2026 Agent Eval 全景图:从'会做'到'值得部署'

本文系统梳理了2026年Agent评估领域的全景图,指出Agent Eval正从'任务能否完成'转向'结果是否有效、过程是否可靠、系统是否值得部署'。文章从通用Agent、软件工程、GUI与SaaS、工具与事务、知识工作(Deep Research、数据分析、预测)、多模态内容生产、科研优化、组件与记忆、多Agent系统等赛道,介绍了代表benchmark及其演进,并强调了可靠性、成本、轨迹审计与证据包成为评估的新基本单位。

技术 › Agent Cloris 2026-08-2221.9 KB 5.6K 56 77