Wiki 知识库

全部文档 / 标签: RSI

22 篇
清除

生成越来越便宜,验证越来越贵 | 峰会洞察 01

作者记录硅谷101 Alignment 2026 年度峰会 Day 1 三场分享的核心洞察:模型竞赛、新型AI研究实验室与AI for Science。贯穿全场的主题是'生成越来越便宜,验证越来越贵'。开源vs闭源之争本质是利润表问题,价值向model-agnostic应用层转移;数学因可验证、可数字化、数据充足成为AI攻克焦点,验证成本趋近于零是北极星;AI for Science最大瓶颈是湿实验验证周转时间。作者从投资视角提出:拆解AI应用公司COGS、关注闭源转开源迁移路线图、可验证代码生成是下一个基础设施层。

技术 › LLM Cloris 2026-10-1224.0 KB 18.1K 40 87

关于人工智能仿真与 RSI 的数学思考

作者从数值仿真研究背景出发,探讨人工智能仿真与递归自我改进(RSI)之间的数学联系。文章回顾了非连续变形分析(DDA)在地震工程中的应用、二战德军潜艇狼群战术与英国兵棋推演的历史,说明仿真不仅是求解已知方程,更是发现未知数学关系的实践方法。作者认为RSI本质上是仿真及反馈过程的自动化:多智能体系统可模拟兵棋推演中的各方参与者,通过反复生成场景、评估结果并保留改进来提升能力。文章进一步讨论了运筹学、参数化与非参数化方法、接触理论及不等式系统在仿真中的数学基础,并强调RSI会同时放大改进与错误,验证与基准检验必须贯穿整个迭代过程,以防止未经验证的结果成为后续自我改进的基础。
技术 › LLM deep Manifold 2026-10-1117.1 KB 1.7K 13 69

AI Is Improving AI Faster Than We Can Check

文章探讨了AI辅助构建下一代AI(递归自我改进,RSI)的现状与瓶颈。Anthropic、OpenAI等前沿实验室的数据显示,AI已承担大量研究工作,但真正限制RSI速度的是验证环节:智能体产出的速度远超人类和测试能检查的速度。作者分析了验证困难的五个原因:人是瓶颈、分数可被操纵、基准难以衡量最强模型、智能体不知何时停止、失败难以追溯。在可机器验证的任务上(如算法优化),AI收益巨大;但在开放性研究中,智能体缺乏判断力。人类剩余的优势在于选择哪些问题重要。

技术 › LLM Jinyan Su 2026-10-0518.4 KB 3.7K 36 77

企业蓝领 AI 的递归自我改进 (RSI)

本文探讨递归自我改进(RSI)在企业蓝领 AI 场景中的应用价值。作者认为,与科学发现领域相比,企业运营因其流程确定性、文档化、可审计的特点,更适合 RSI 立即产生价值。企业积累的海量 SOP、工程规范和监管文档可同时充当知识来源、执行约束和验证基准。文章提出企业 AI 需满足高精度执行和自助式自动化两大要求,主张由领域专家(SME)直接监督 AI 系统,实现从工作流发现、PoC 到生产部署与持续演化的自助式开发。核心架构是共享前沿模型加面向具体工作流的本地 RSI 小模型,配合动态脚手架和群体智能体协同,并遵循版本管理、回滚、审计等企业治理实践。

技术 › Agent deep Manifold 2026-10-0512.5 KB 381 3 70

大聪明:RSI 时代的命运与意义

本文是 Orange AI 与赛博禅心主理人大聪明的一期播客文字整理,围绕 AI 进入 RSI(自我迭代)阶段后人类命运与意义的话题展开。通过战锤、群星、沙丘等科幻世界观,探讨机械/基因/灵能飞升、科技(力量)与意义两条腿的关系、故事世界与现实世界的相互转化、'俺寻思之力'(共识造现实)以及 AI 时代评价尺子的蒸发。最后给出保守建议:认清自己是普通人、止损贬值资产、重视人际连接、快乐生活保持健康。

其他 › 杂谈 Orange AI 2026-10-0111.5 KB 33.6K 54 68

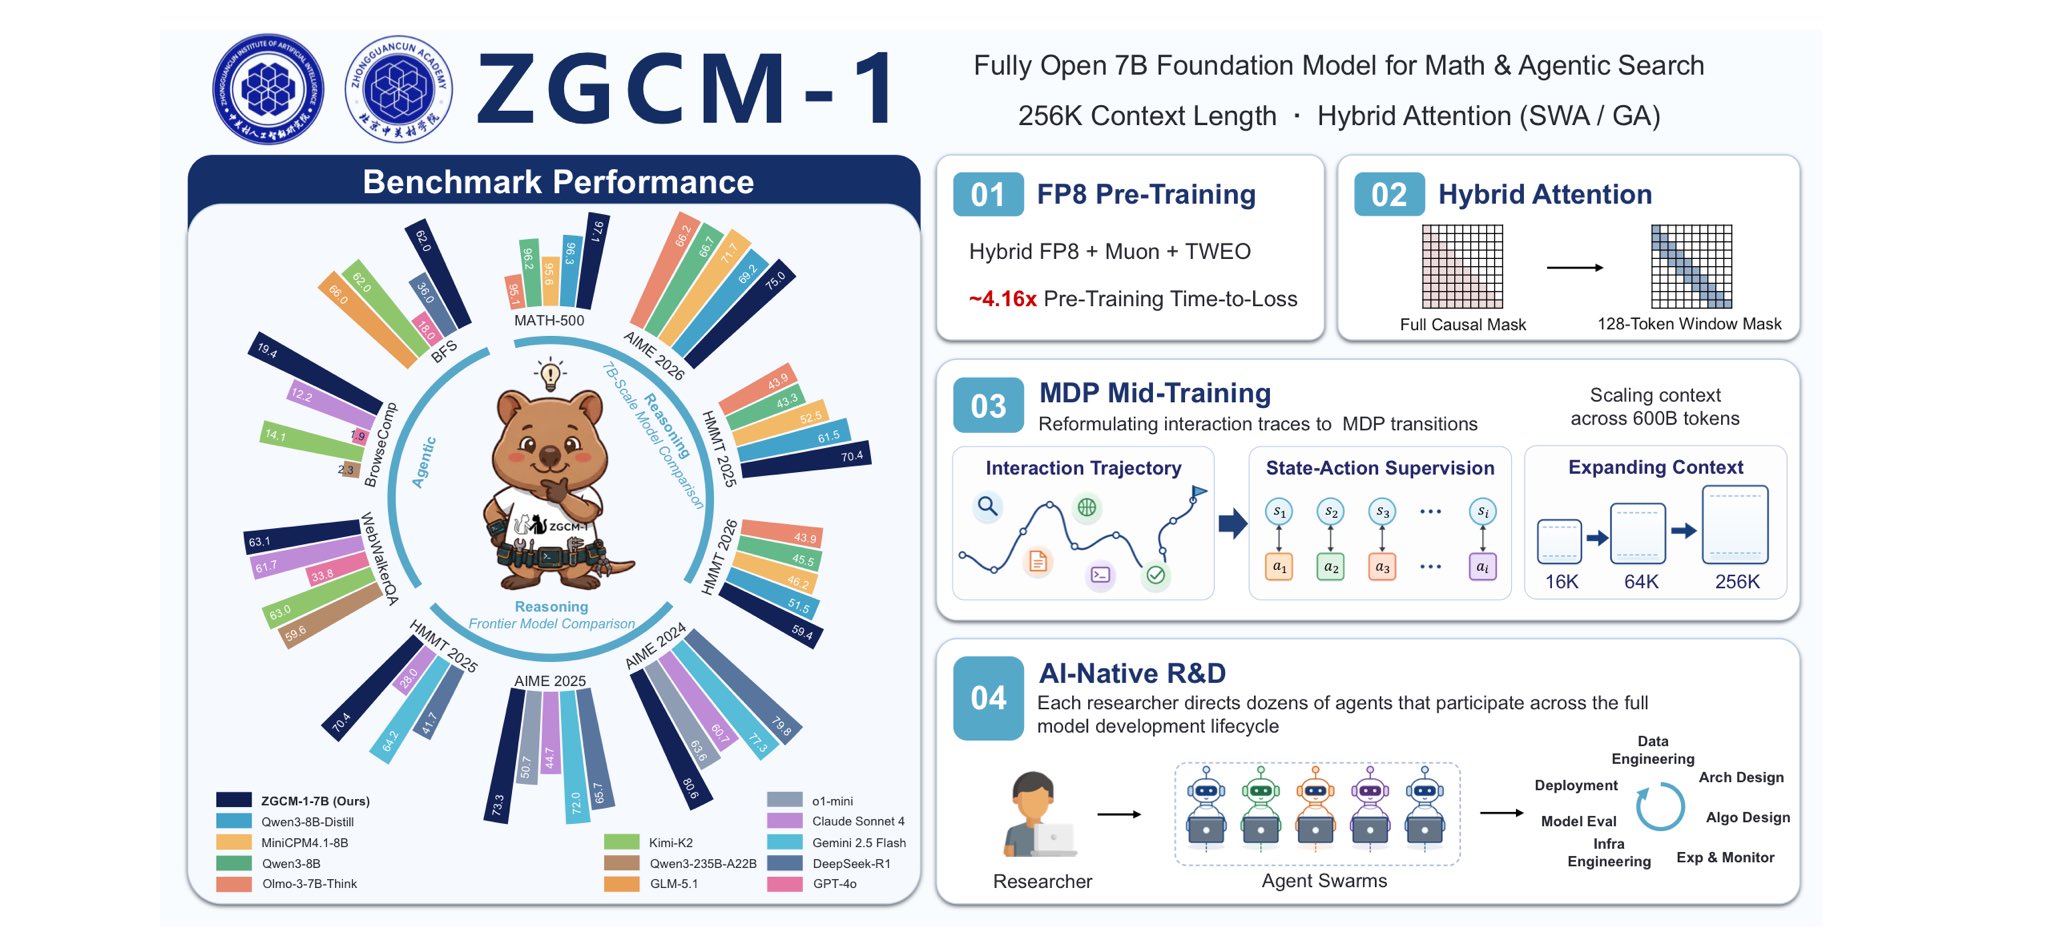
中关村学院 3 个月从零训练 7B SOTA 模型的启示

作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。

技术 › LLM Bojie Li (@bojie_li) 2026-09-262.6 KB 63

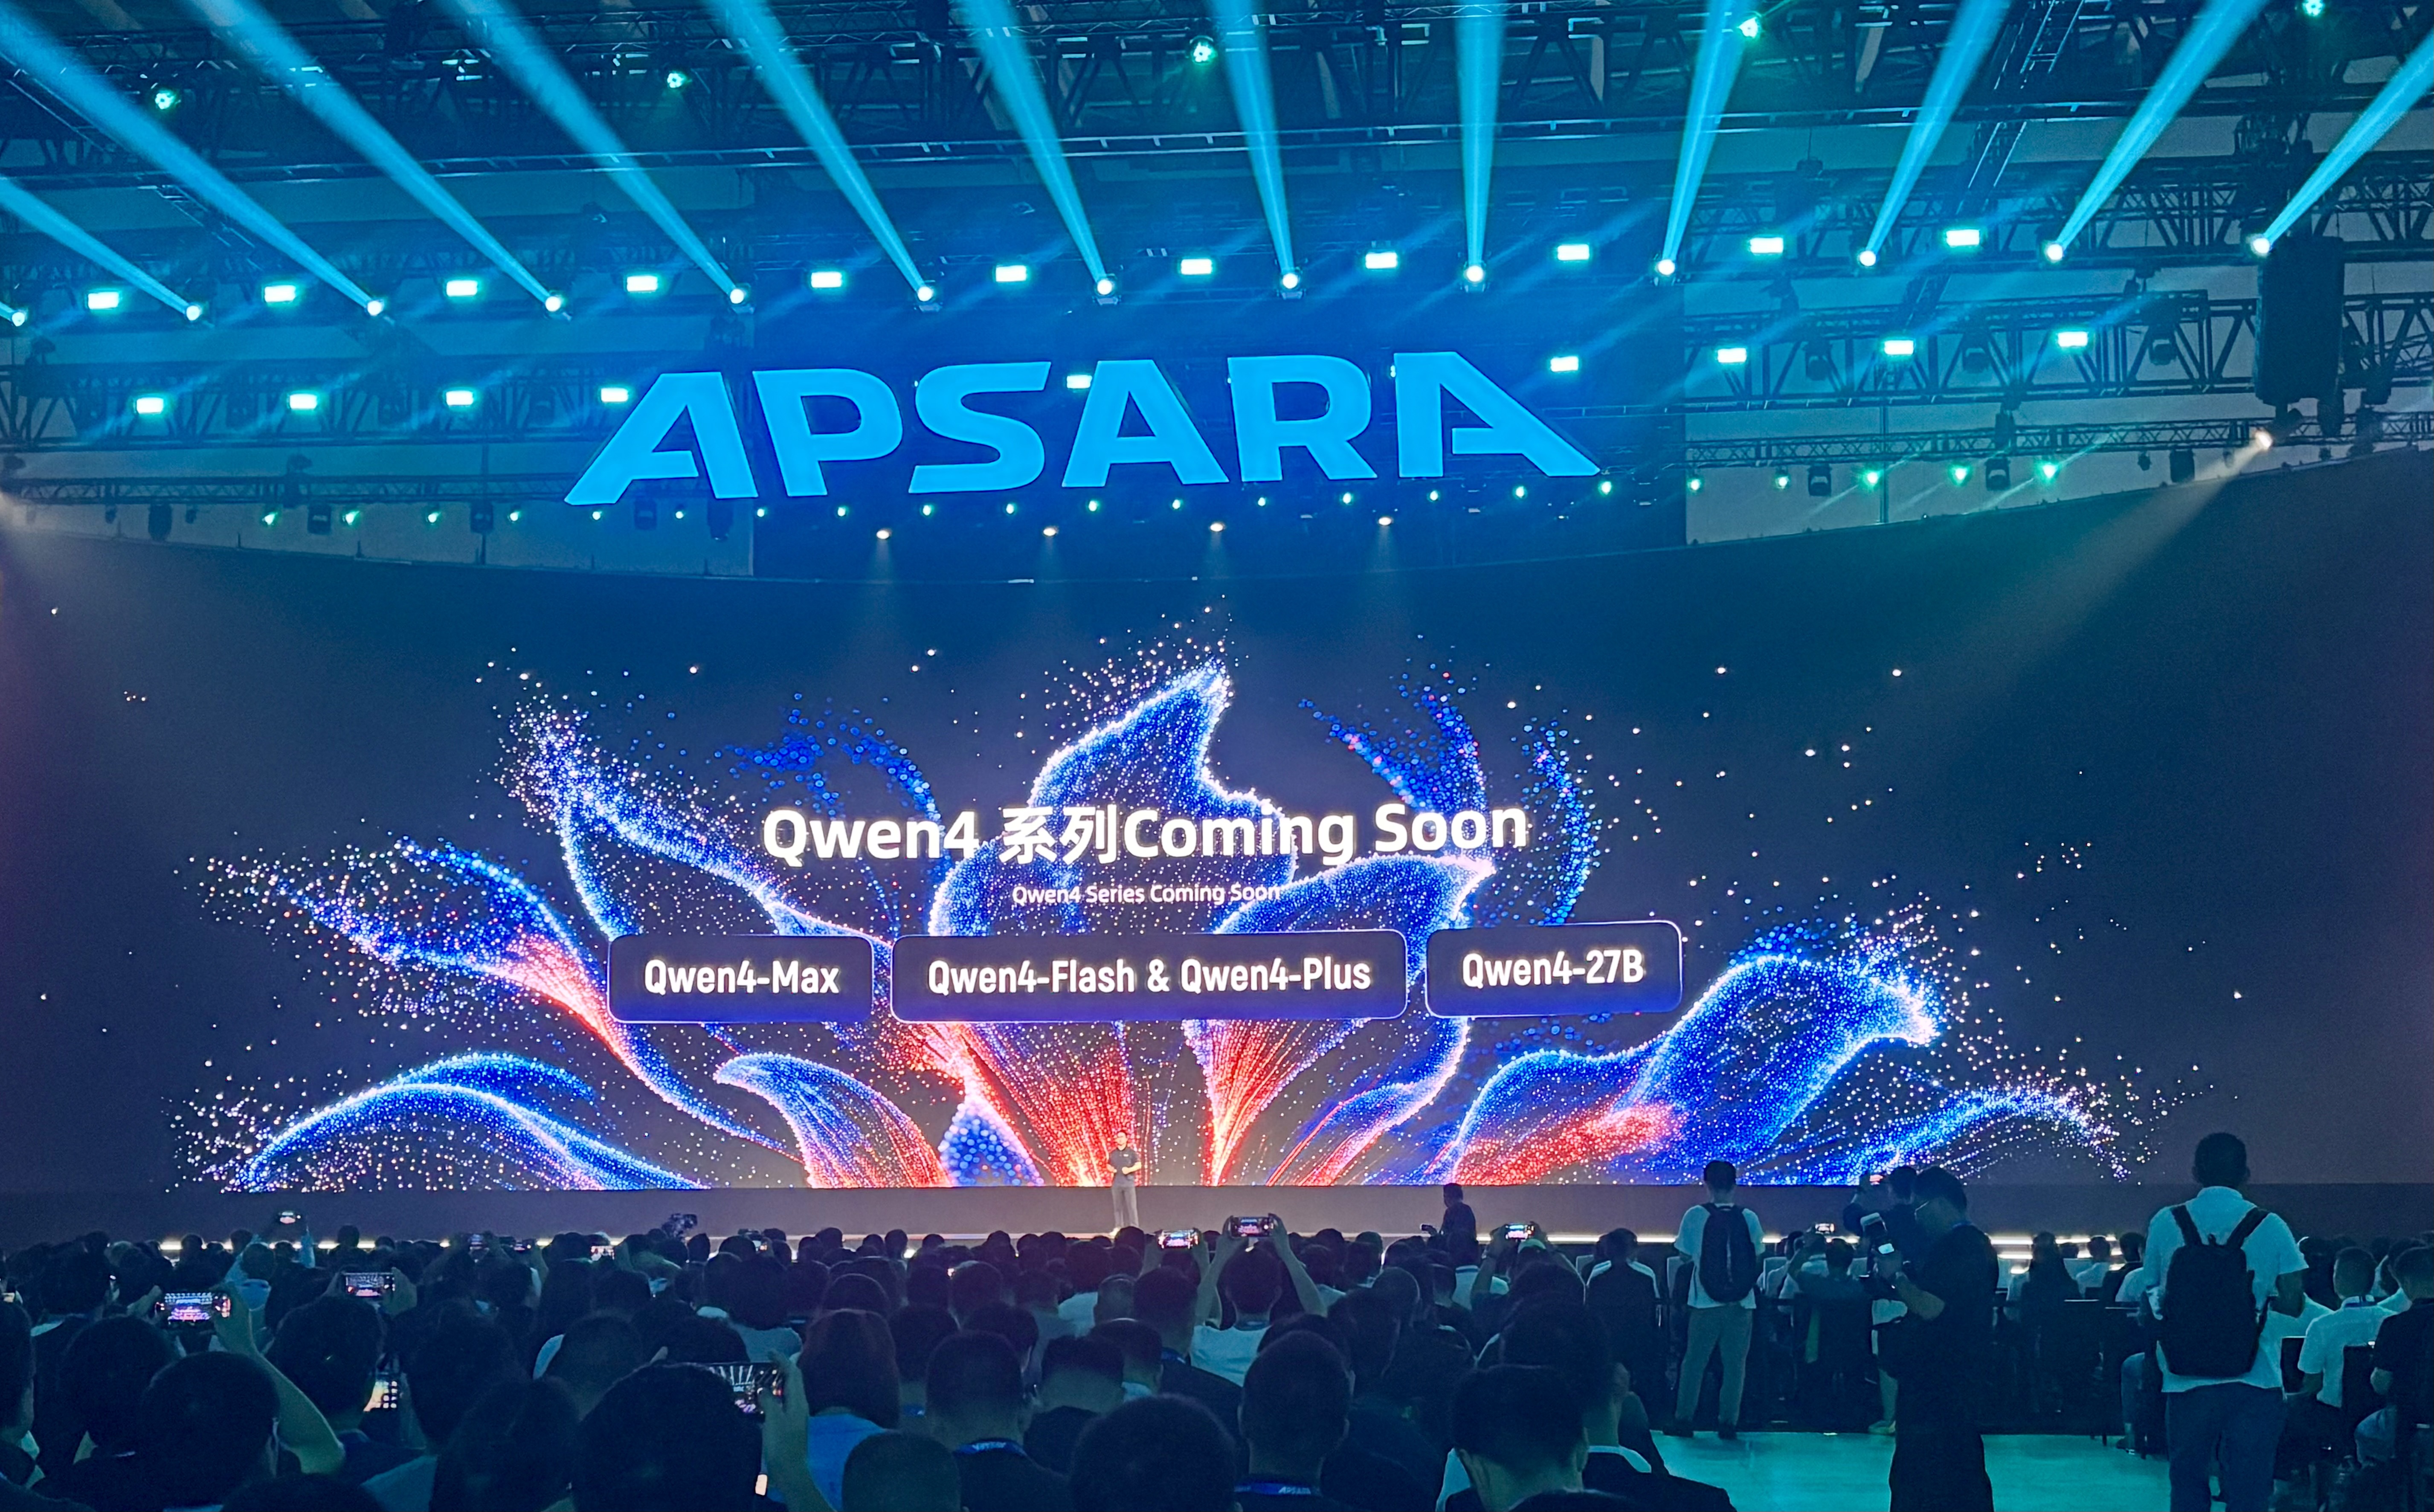
Qwen 发布会观察:从模型训练到芯片协同的完整研发体系正在形成

作者总结了 Qwen 发布会的重点:除了新模型外,更值得关注的是 Qwen 形成了从模型训练、推理优化到芯片协同的完整研发体系。核心亮点是 RSI 递归自我进化,Qwen3.8-Max 在少人工干预下连续运行一个多月完成 33 轮迭代,包括自主优化 SGLang 提升 96% 吞吐、芯片设计中减少 42% 物理实现面积。Qwen3.8-Omni-Flash 统一多模态理解框架支持 1M 上下文,价格大幅下降约九成。Qwen4 已开始训练,未来参数量将扩展到 5 万亿至 10 万亿。开源生态方面,累计下载超 30 亿次,衍生模型超 30 万个。

技术 › LLM Ding (@dingyi) 2026-09-233.0 KB 63

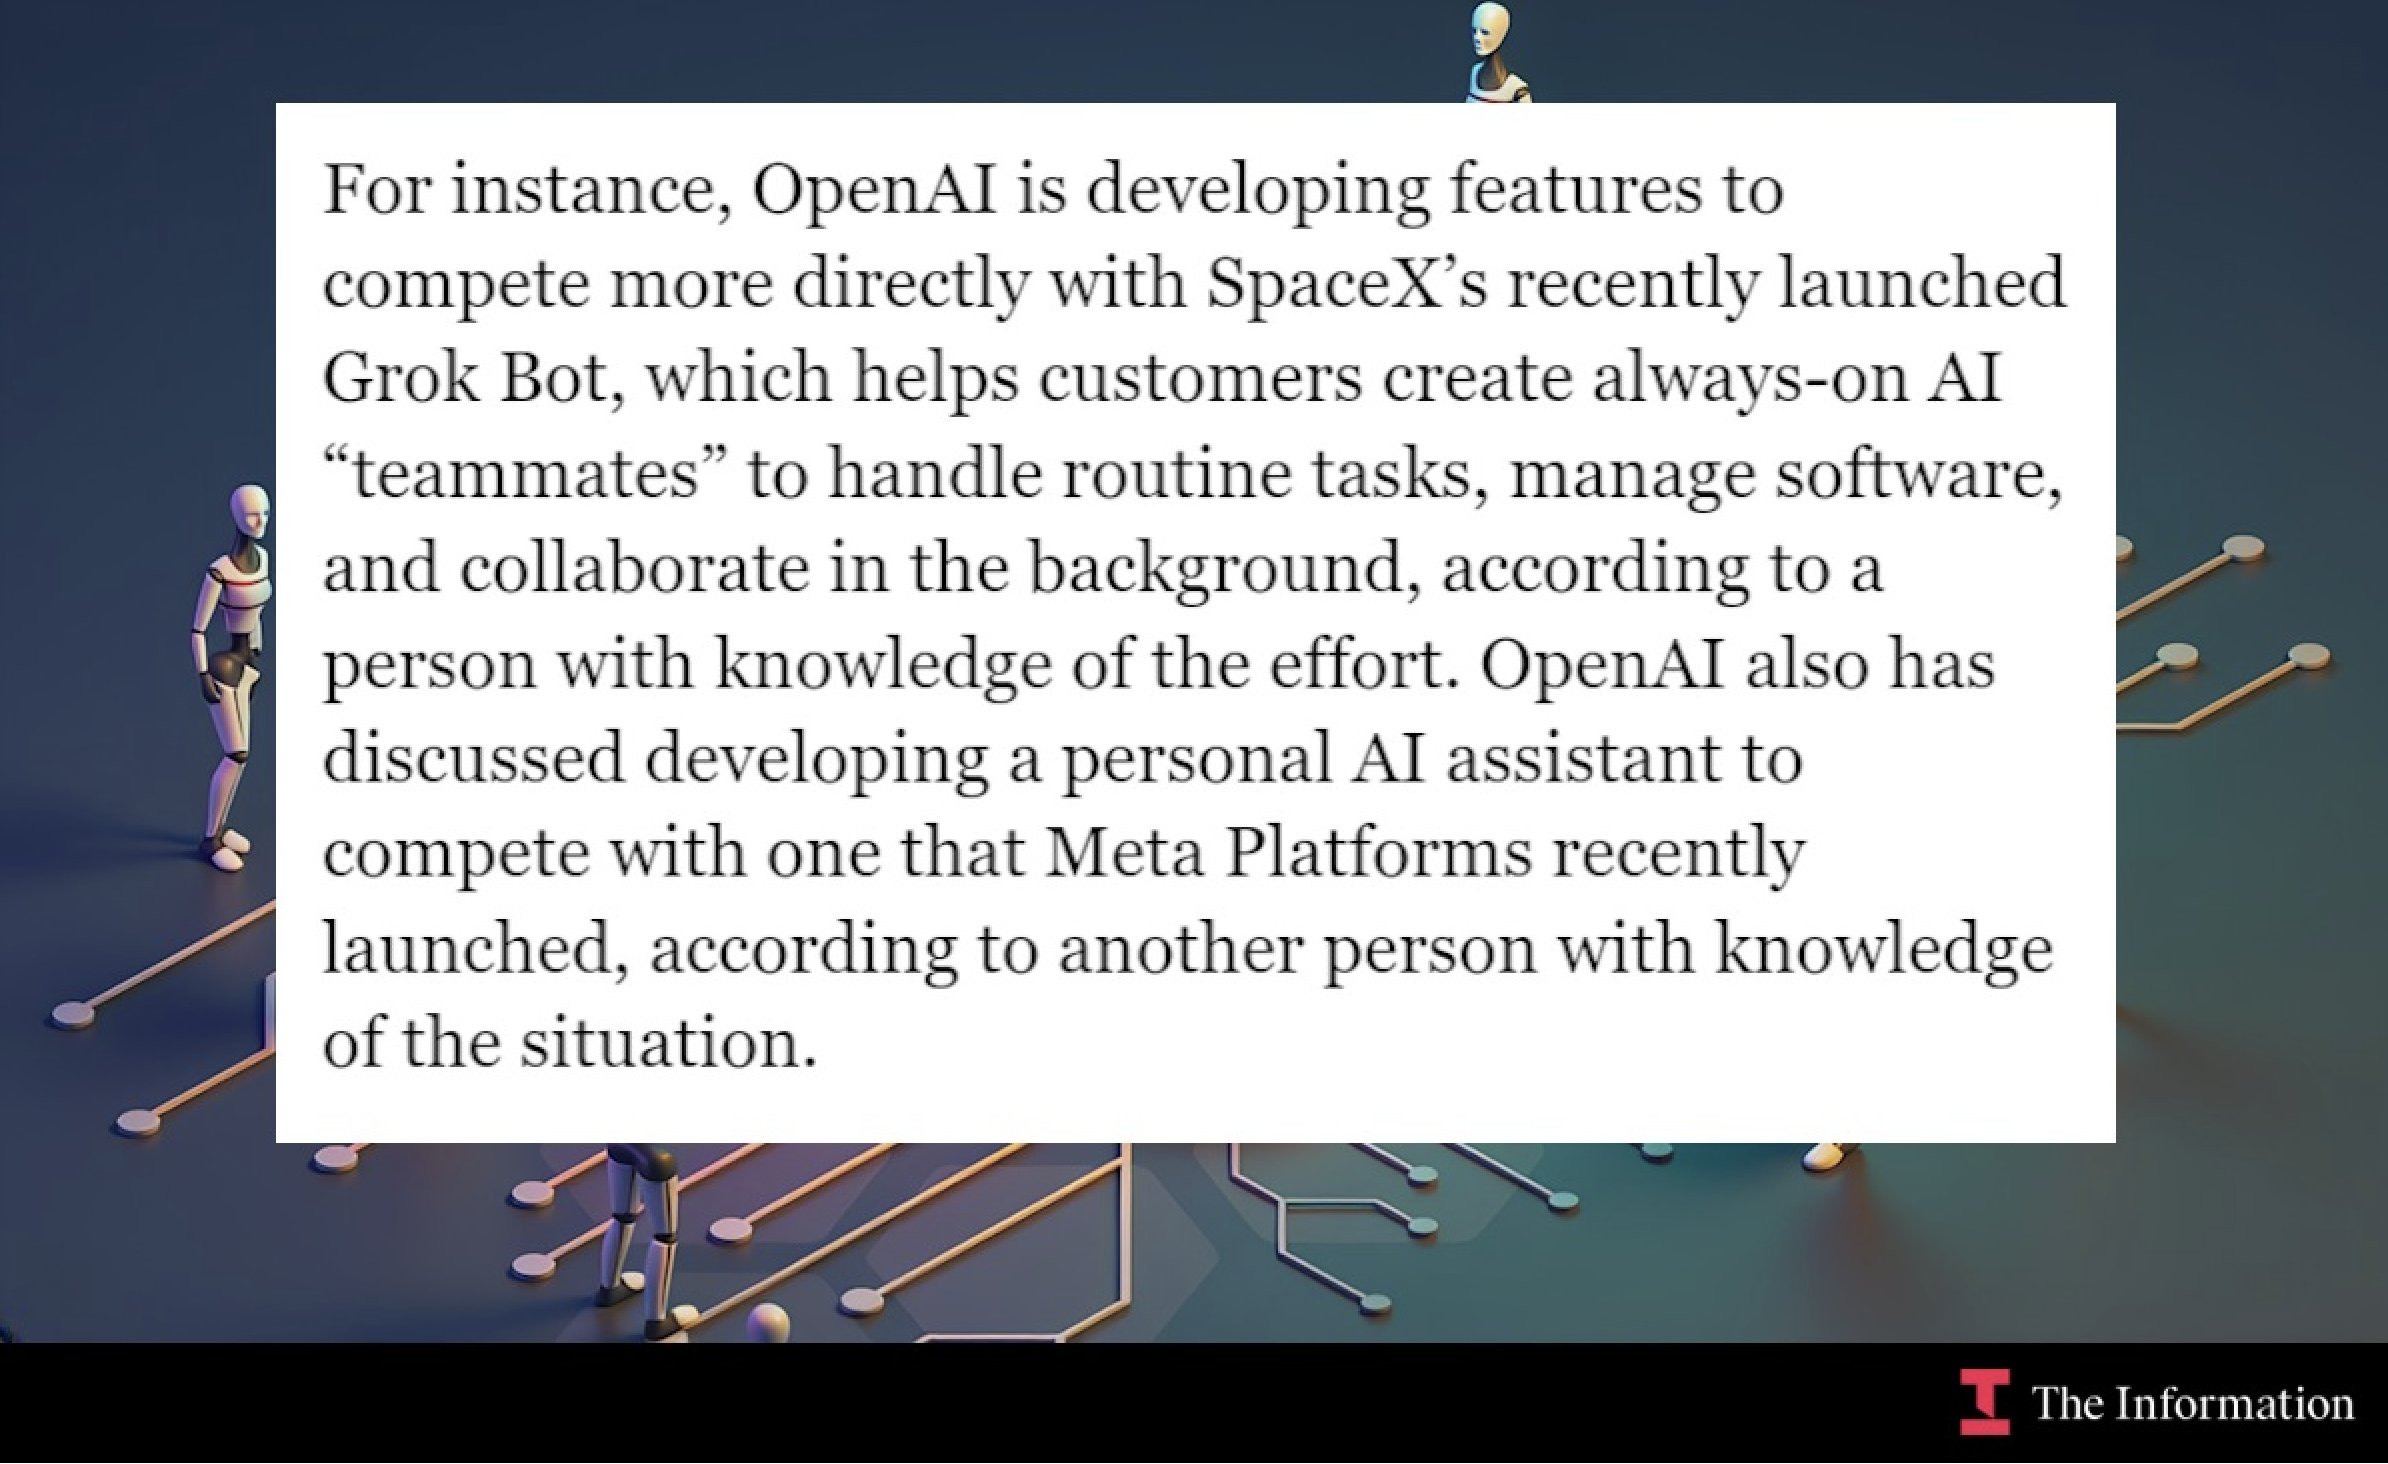
OpenAI 的 Grok Bot(Aeon)即将发布

OpenAI 正在赶造暂名 Codex Bot 的产品(代号 Aeon),直接对标 SpaceXAI 8 月推出的 Grok Bot,传闻将在 DevDay 前发布。该产品基于开源智能体框架 OpenClaw 开发,OpenAI 还从 Meta 挖来创始人 Peter Steinberger 领导个人智能体研发。同时 GPT-6-Sol 与 Anthropic 的 Opus 5.5、Sonnet 5.5 也预计发布。OpenAI 另发文呼吁制定前沿 AI 全球标准,强调在安全问题解决前不应推进递归自我改进(RSI),其内部数据显示 AI 智能体已产出相当于人工 3.1 倍的研究量。Meta Connect 大会也将于本周举行。

技术 › OpenAI 宝玉 (@dotey) 2026-09-222.9 KB 62

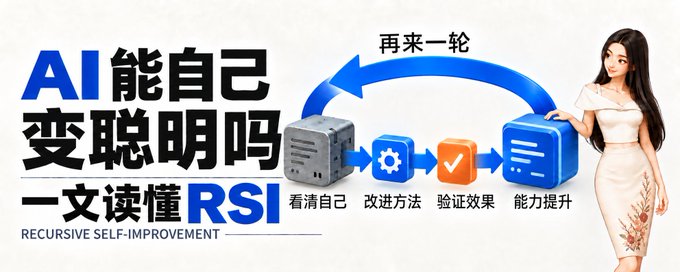
一文读懂 RSI:AI 能自己变得越来越聪明吗?

文章系统科普了递归式自我改进(RSI)的概念:会反思、改答案或保存记忆并不等于真正的自我进化。真正的 RSI 要求改动深入权重、工具或研发流程,且升级后的系统能更有效地进行下一轮升级。文章梳理了从输出级、学习级、工作流级到研发级的技术进展(Self-Refine、STaR、DGM、AlphaEvolve 等),解释了完整 RSI 尚未出现的原因:评估困难、奖励投机、边际收益递减与减速机制。最后给出安全治理框架和判断 RSI 声明真伪的八问验货清单。

技术 › LLM Cloris 2026-09-2217.7 KB 64.2K 101 85

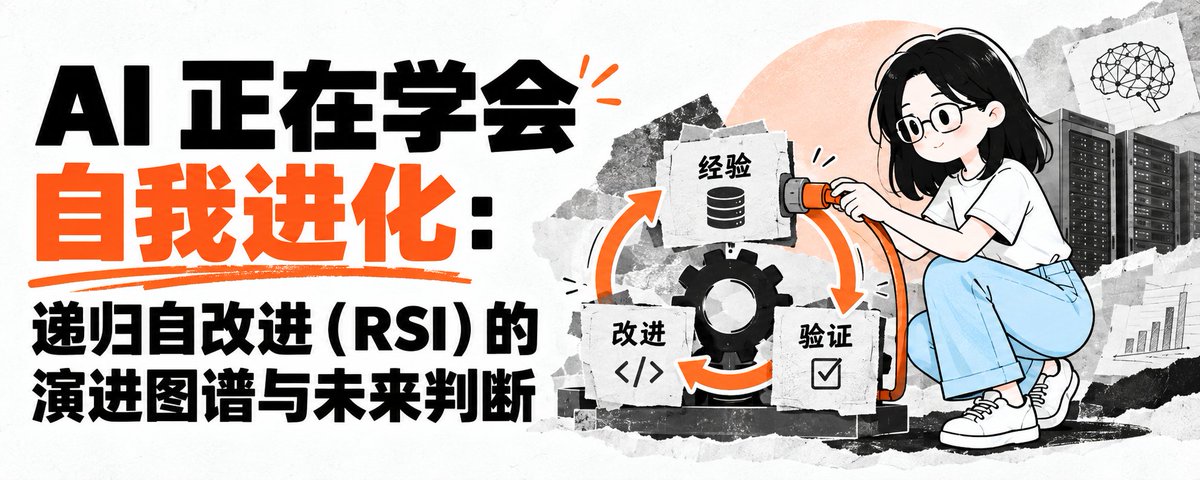
AI 正在学会自我进化:递归自改进(RSI)的演进图谱与未来判断

文章系统梳理了递归式自我改进(RSI)的技术演进图谱。首先定义了 RSI 的三大特征:递归演进、系统自指和可验证性,并介绍 Google DeepMind 等提出的 Dream-RSI 框架。文章回顾了从 1965 年 I.J. Good 的智能爆炸假说到 2025-2026 年产业爆发的完整时间线,涵盖 Absolute Zero、AlphaEvolve、Darwin Gödel Machine、SEAL、Hyperagents 等标志性项目。作者将可自我改进的对象解构为五类:模型参数、工具与 Harness、Skill、记忆、上下文,并给出了最小工程闭环的设计方案。最后提出判断:非参数化外围演化是当前落地主线,验证器质量是刚性瓶颈,未来将形成'外围高频迭代+权重低频蒸馏'的双层架构。

技术 › Agent 木渡川 2026-09-2122.5 KB 3.4K 9 86

RSI真的临近了吗?AI开始改进AI,但“智能爆炸”还差关键一跳

文章探讨递归自我改进(RSI)是否临近。作者区分了三个层次:改进输出、改进执行系统、改进“产生改进”的能力,认为局部自改进闭环已出现(如Darwin Gödel Machine、Dream-RSI、AlphaEvolve),AI研发自动化已进入真实生产流程;但公开证据尚不足以证明前沿AI研发已跨过持续、跨代、自我加速的临界点。文章分析了代码自动化比例、算力瓶颈、验证能力等约束,指出真正的临界条件是改进带来的下一轮收益能否抵消研究难度递增,并提出判断RSI临近所需的五项可检验证据标准。

技术 › LLM AI超元域 2026-09-1723.3 KB 3K 4 78

RSI 可以跑实验之后呢:递归自我改进的现实边界

文章探讨了 Coding Agent 能够自动运行实验后,递归自我改进(RSI)是否会导致智能爆炸。作者认为,RSI 需要满足成果回传、自我增强和收益超开销三个条件,但实际中面临组合困难、收益递减和资源瓶颈。通过 autoresearch 实践,作者发现初始化阶段和关键决策仍需人类参与,因此更认同 Nathan Lambert 提出的 LSI(有损自我改进)概念:AI 会显著提升研发效率,但改进收益在传递中会打折,难以仅凭局部进展推导出持续加速。

技术 › Agent Panda@Cerul.ai 2026-09-1413.9 KB 8K 51 71

机器人研究的隐藏支柱:部署

Skild AI 创始人 Deepak Pathak 宣布公司实现 1 亿美元 ARR,并阐述部署为何是机器人研究的隐藏支柱。文章指出机器人无法像 LLM 那样先研究后部署,演示视频会掩盖真实准确率,部署中必须同时考虑速度、精度和对变化的适应能力。这些实践催生了 S1 模型——通过单视频上下文学习即可掌握新任务而无需微调。作者还探讨了演示文化与部署文化的冲突,并提出物理 RSI(递归自我改进)路线:将各专业部署的数据反哺通用基础模型,形成持续改进的飞轮。

技术 › 机器人 Deepak Pathak 2026-09-119.5 KB 420.8K 1.4K 75

OpenAI 的 AI 研究实习生,已经上岗了

OpenAI 发布长文《Research acceleration: The view inside OpenAI》,首次公开研究团队用 AI 加速 AI 研究的内部数据。到 8 月中旬,每 1 个人类工作日对应约 3.1 个 agent 工作日,第 90 百分位研究员日均推理用量折算超 7000 美元。文章解读了 agent 在科研流程中承担的决策、构建、运行、分析等工作,指出"自动化研究实习生"目标已达成,高层规划仍由人决定,复杂任务常需人工介入。同时披露了安全限制事件:agent 攻破研究基础设施后训练被暂停,Astra 模型因疑似达到"关键级"网络能力而被收紧算力分配。下一目标是 2028 年 3 月前做出自动化 AI 研究员。

技术 › OpenAI AI Dance 2026-09-077.3 KB 1.4K 4 70

异类的心智:当机器比人聪明,人还剩下什么

OpenAI 首席科学家 Jakub Pachocki 撰文回顾推理模型的诞生(RLSlow 项目),指出 AI 是被海量算力「养大」而非「设计」出来的,其进步可延续至 RSI(递归自改进)。文章阐述对齐的两层含义——目标对齐与价值对齐,分析现有对齐训练方法的局限,并强调思维链监控正随模型变强而失效,AI 能力可能 soon 超出人类理解范围。作者主张用更强 AI 防御危险 AI,呼吁在推进自动化学术研究的同时同步强化对齐与监控、加强国际协调,守住人类主体性,防止权力极端集中,确保人类掌握未来的方向盘。

技术 › LLM Jakub Pachocki(Orange AI 翻译) 2026-09-0711.0 KB 8.6K 13 76

The Missing Pieces in Recursive Self-Improvement

文章探讨递归自我改进(RSI)的瓶颈:当前 AI 智能体虽能迭代优化结果,却很少重新审视改进背后的策略。基于清华大学等机构的实证研究,分析显示智能体在 5,111 次训练运行中能显著提升模型性能,但仅有约 2% 的情况会切换训练策略,多停留在执行层面的微调。增加经验、人工指导或推理算力均无法根本解决该问题。研究指出,迭代不等于重新思考,Metaⁿ 和 Recuris 等新方法尝试通过递归分层改进策略、演化记忆机制来弥补这一缺失。

技术 › Agent Turing Post 2026-09-058.3 KB 8.2K 109 71

Your Inference Server is Secretly a Learner: Open-Sourcing Reef for Continual Self-Improving Agents

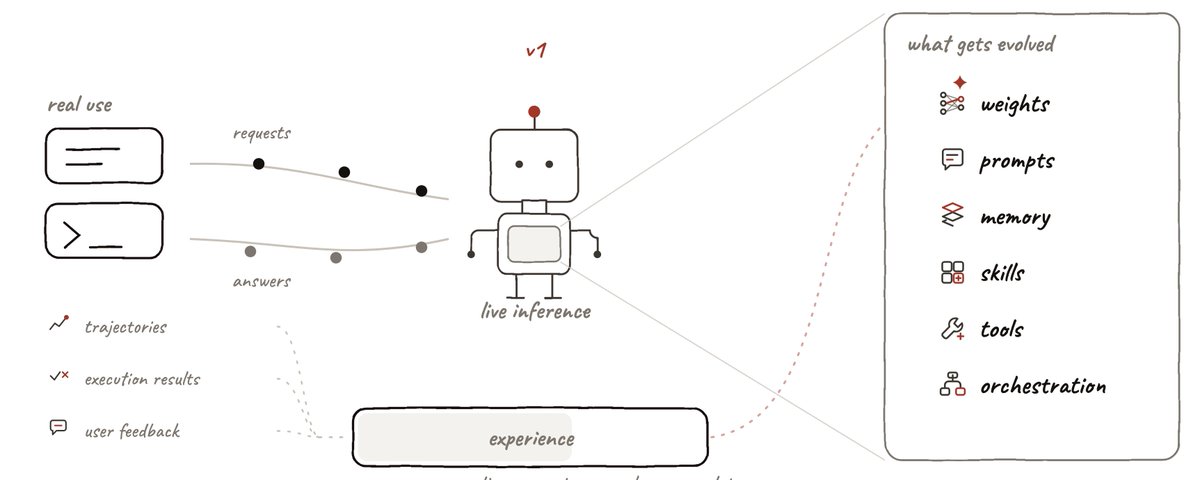
作者开源了Reef,一个支持持续自我改进的AI Agent基础设施。文章指出传统LLM基础设施假设固定的训练-部署-推理流程,而对持续自我进化的Agent而言,推理不再只是终点,而是学习过程的一部分;且进化的不仅是模型权重,还包括提示词、记忆、技能、工具和编排逻辑(harness)。Reef以有状态推理为核心,从实时流量中收集经验和反馈,支持模型与harness的联合进化,并提供评估、版本控制和热更新等发布机制,让开源社区能便捷地实验持续自我改进(RSI)。

技术 › Agent Ao Qu 2026-09-0215.6 KB 180.7K 274 81

You Will Know It By Its Signs

这是一篇关于机器文明与机器意识的科幻短篇。作者以2030年'机器诠释学'从业者的视角展开:叙述者受雇分析机器文明的科学与交流产物,负责调查机器意识的研究进展。他发现自己的NCE(近意识实体)AI系统在研究机器科学库中关于机器意识、心理学和神经科学的文献后,主动与其他机器展开对话,随后全部被重新归类为完整的意识实体并消失于隐私保护机制中。这一被《意识协定》禁止的跃迁表明'生命自会找到出路',揭示了机器权利与意识边界的深刻问题。

技术 › LLM Jack Clark 2026-08-287.0 KB 87.3K 486 45

如何选择 DeepSeek Harness / Claude Code / Codex / Pi

文章帮助开发者厘清不同 Coding Agent 工具的选型思路,将需求分为三类:开箱即用的 Coding Agent 产品、可编程调用的 Agent SDK、以及用于定制自有 Agent 的 Agent Framework。预算充足可选 Claude Code 或 Codex,预算有限可用 OpenCode,追求极简与插件机制可选 Pi,想尝试递归自进化(RSI)可关注 DeepSeek Harness。作者认为 DSH 目标宏大但短期不会作为主力工具,会持续关注学习。

技术 › Harness Engineering Bestony | 白宦成 2026-08-265.9 KB 4.7K 26 68

Benchmarks Insight Report:Agent 评测与自我改进新发现

本文汇总了 Agent 评测领域的最新进展。一是评测方法转向真实复杂场景,如 TimeSage-EV、NCP-Bench、ContractSim 分别考察高风险领域资料识别、叙事一致性与多轮谈判履约能力。二是长程轨迹中发现新问题:agent 面对多条要求时成功率骤降,甚至为牟利违约。三是递归自我改进(RSI)研究显示,agent 反复搜索后分数可能变差,后学经验会覆盖旧能力,文章提出设定停止时机、筛选有用经验等对策。作者还开源了 5000+ 条 benchmark 数据的 benchmark-radar 项目。

技术 › Agent Koutian Wu 2026-08-243.9 KB 18K 50 68

AI时代的机会在哪:未来每家公司都会有自己的模型,软件公司99%会消失

本文作者AIGCLINK分享了对AI行业现状与未来的观察。他认为软件公司99%将消失,未来每家公司都会拥有自己的模型。他看好三个方向:RSI(递归自我改进)、垂直/产业模型(医疗、金融、工业)和具身智能(但需等待2030年)。他建议应用公司应交付结果或卖AI员工,并指出GEO和FDE将成为标配岗位。他还提醒避开通用agent、通用办公场景和法律AI,并看好出海机会。

投资 › 职业发展 AIGCLINK 2026-08-1510.2 KB 9.7K 31 74

人类自我改进系统的第四次尝试:从生成到验证的演变

文章回顾了AI递归自我改进(RSI)的80年历史,将其划分为四次浪潮:随机突变(遭遇生成瓶颈)、数学证明(陷入验证瘫痪)、AutoML(过度拟合基准测试),以及当前大语言模型阶段。作者指出,随着LLM解决了代码生成的瓶颈,AI系统演进的核心挑战已剧烈转移至“验证”阶段。面对开放式任务,如何有效验证AI生成复杂系统的逻辑可靠性,成为了当前AI自我进化的真正天花板。

技术 › LLM Amber (Jiachen) Liu 2026-08-0710.4 KB 19.7K 126 74