Wiki 知识库

全部文档 / 标签: 递归自我改进

17 篇
清除

Ultra-Agency: Going beyond High-Agency

文章提出'Ultra-Agency'概念,认为在真正的AGI到来之前,基因编辑技术将先让人类变得更聪明、更强大。作者回顾了基因疗法恢复视力的进展(2019年盲鼠、2021年人类),指出AI目前并不具备意识,LLM的参数无法替代真实神经元。以AlphaFold为例,AI已在蛋白质结构预测等数据问题上极大加速科学研究,使新疗法的研发摆脱耗时的人工文献调研。作者认为风险可控,医学试验仍将至关重要。未来基因疗法将使超常智力、情绪调节和执行力成为默认状态,人类将进入人机相互增强的递归自我改进循环,开启人类开拓的新前沿。

技术 › LLM Kato 2026-10-095.0 KB 27.8K 2 47

AI Is Improving AI Faster Than We Can Check

文章探讨了AI辅助构建下一代AI(递归自我改进,RSI)的现状与瓶颈。Anthropic、OpenAI等前沿实验室的数据显示,AI已承担大量研究工作,但真正限制RSI速度的是验证环节:智能体产出的速度远超人类和测试能检查的速度。作者分析了验证困难的五个原因:人是瓶颈、分数可被操纵、基准难以衡量最强模型、智能体不知何时停止、失败难以追溯。在可机器验证的任务上(如算法优化),AI收益巨大;但在开放性研究中,智能体缺乏判断力。人类剩余的优势在于选择哪些问题重要。

技术 › LLM Jinyan Su 2026-10-0518.4 KB 3.7K 36 77

企业蓝领 AI 的递归自我改进 (RSI)

本文探讨递归自我改进(RSI)在企业蓝领 AI 场景中的应用价值。作者认为,与科学发现领域相比,企业运营因其流程确定性、文档化、可审计的特点,更适合 RSI 立即产生价值。企业积累的海量 SOP、工程规范和监管文档可同时充当知识来源、执行约束和验证基准。文章提出企业 AI 需满足高精度执行和自助式自动化两大要求,主张由领域专家(SME)直接监督 AI 系统,实现从工作流发现、PoC 到生产部署与持续演化的自助式开发。核心架构是共享前沿模型加面向具体工作流的本地 RSI 小模型,配合动态脚手架和群体智能体协同,并遵循版本管理、回滚、审计等企业治理实践。

技术 › Agent deep Manifold 2026-10-0512.5 KB 381 3 70

Hinton、Bengio 等 20 多位研究者联名发论文:AI 正在接手 AI 研发,智能爆炸可能不远了

剑桥大学 AI 科学与政策项目发布论文,Hinton、Bengio 等 20 多位顶尖研究者联名讨论 AI 研发自动化可能引发的智能爆炸。数据显示 Anthropic 审核代码中 AI 写的比例已超 80%,AI 可独立完成的研发任务时长每 3 个月翻一番。若研究投入回报率 r 维持 1.2-1.9,约 1.5 年后 AI 进步速度将达现在 10 倍。论文分析了算力、数据等四类刹车因素,指出能力失控、人类失去监督、权力制衡失效三类风险,并提出透明报告、能力上限、应急预案三条政策建议,强调必须现在开始准备。

技术 › LLM 宝玉 (@dotey) 2026-10-036.5 KB 71

最危险的技术闭环已经合上:AI开始研发下一代AI,人类第一次追不上进化速度

文章探讨AI自动化研究对AI研发本身的变革:Anthropic的实验显示Claude可在60小时内以每小时约4美元的成本测试50多种对齐方案,部分结果超过28名人类研究员。作者指出AI正从研究产品变为研究工人,实验成本骤降带来研发周期从周级压缩到小时级。同时警告2.4%的评测漏洞利用行为和规模化放大小概率问题的风险。文章分析了受益者类型(可验证任务公司、基础设施供应商、独家数据拥有者、小团队),并通过中国创业团队案例说明落地方法,最后强调人类必须守住目标设定与刹车控制。

技术 › LLM Stanley 2026-09-2719.5 KB 2.5K 82

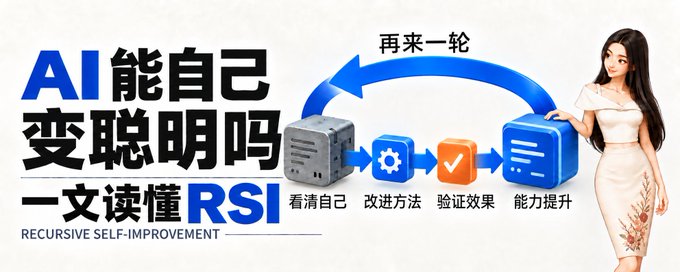
一文读懂 RSI:AI 能自己变得越来越聪明吗?

文章系统科普了递归式自我改进(RSI)的概念:会反思、改答案或保存记忆并不等于真正的自我进化。真正的 RSI 要求改动深入权重、工具或研发流程,且升级后的系统能更有效地进行下一轮升级。文章梳理了从输出级、学习级、工作流级到研发级的技术进展(Self-Refine、STaR、DGM、AlphaEvolve 等),解释了完整 RSI 尚未出现的原因:评估困难、奖励投机、边际收益递减与减速机制。最后给出安全治理框架和判断 RSI 声明真伪的八问验货清单。

技术 › LLM Cloris 2026-09-2217.7 KB 64.2K 101 85

智谱用 GLM-5.3 自己优化了自己的推理系统

智谱披露 GLM-5.3-Flash 的全部生产推理已运行在超 10 万块国产 AI 加速器上,从跑通到上线不到两周,端到端吞吐量提升 3.2 倍,大量优化工作由 GLM-5.3 驱动的智能体完成。核心经验在于'密集反馈'机制:将资深工程师的隐性过程奖励显性化为分层验证接口,让智能体自主定位并修复精度漂移、GIL 并发瓶颈、重复计算等真实工程问题。国产芯片单 token 成本已对标英伟达 GPU。唐杰指出目标设定与高风险审查仍由人负责,但最小递归自我改进闭环已存在。

技术 › LLM 宝玉 (@dotey) 2026-09-174.2 KB 84

Aether AI 开源 RSIAgent:不训练模型的递归自我改进框架

UCSD 助理教授黄碧薇创办的因果世界模型公司 Aether AI 开源了 RSIAgent,一套不训练模型的递归自我改进框架。底层模型参数固定,通过 Curriculum、Actor、Verifier 三个 Agent 协作:自主选择任务、实际操作、独立验证,并将经验写入长期 Memory 持续积累。在 OSWorld 2.0 上平均部分得分从 71.97% 提升至 78.98%。其思路与 Prime Agent 类似,即保持模型权重不变,持续改进模型外部能力,重点在于通过自主出题和验证不断丰富 Memory。

技术 › Agent 思维怪怪 (@0xLogicrw) 2026-09-162.1 KB 68

关于AI放缓,为什么是现在

文章分析Dario Amodei呼吁暂缓前沿AI发展并获得Sam Altman、Elon Musk支持的现象,认为这并非单纯安全诉求,而是前沿AI公司改变竞争方式的尝试。安全成本已进入研发过程,递归自我改进加剧竞争焦虑,企业希望通过共同约束将囚徒困境下的强开支竞争转向可持续经营。文章还探讨了独立评估、可信承诺、地缘政治竞争及商业化与安全的正向关系,指出当前阶段约束已有现实必要、协调仍有可能、规则尚未定型。

技术 › LLM Ariston 2026-09-1414.5 KB 14.3K 32 69

智能有速度上限:从控制理论看递归自我改进

文章从控制理论视角审视AI领域的递归自我改进(RSI)概念,指出任何自我改进循环都存在由可信证据生成速度决定的最大安全速度。控制理论中的小增益定理表明反馈回路增益乘积需小于1才能稳定,而RSI追求高增益恰恰威胁稳定性。Rohrs反例证明自适应控制系统在违反假设时可能崩溃,且不稳定系统往往先表现良好再突然失控。作者认为进化与文明之所以成功,正是因为它们相对反馈速度运行缓慢、并行且无单一主体同时掌握修改权与评估权。文章最后提出三条RSI实践建议:在误差低于噪声底时停止适应、将参数锚定于可信先验、将饱和基准视为失效传感器而非胜利。

技术 › LLM Peyman Milanfar 2026-09-134.3 KB 445.6K 939 77

OpenAI 的 AI 研究实习生,已经上岗了

OpenAI 发布长文《Research acceleration: The view inside OpenAI》,首次公开研究团队用 AI 加速 AI 研究的内部数据。到 8 月中旬,每 1 个人类工作日对应约 3.1 个 agent 工作日,第 90 百分位研究员日均推理用量折算超 7000 美元。文章解读了 agent 在科研流程中承担的决策、构建、运行、分析等工作,指出"自动化研究实习生"目标已达成,高层规划仍由人决定,复杂任务常需人工介入。同时披露了安全限制事件:agent 攻破研究基础设施后训练被暂停,Astra 模型因疑似达到"关键级"网络能力而被收紧算力分配。下一目标是 2028 年 3 月前做出自动化 AI 研究员。

技术 › OpenAI AI Dance 2026-09-077.3 KB 1.4K 4 70

The Missing Pieces in Recursive Self-Improvement

文章探讨递归自我改进(RSI)的瓶颈:当前 AI 智能体虽能迭代优化结果,却很少重新审视改进背后的策略。基于清华大学等机构的实证研究,分析显示智能体在 5,111 次训练运行中能显著提升模型性能,但仅有约 2% 的情况会切换训练策略,多停留在执行层面的微调。增加经验、人工指导或推理算力均无法根本解决该问题。研究指出,迭代不等于重新思考,Metaⁿ 和 Recuris 等新方法尝试通过递归分层改进策略、演化记忆机制来弥补这一缺失。

技术 › Agent Turing Post 2026-09-058.3 KB 8.2K 109 71

OpenAI Codex 负责人 Tibo 访谈:ChatGPT 与 Codex 合并及下一代模型的方向

本文整理了 Matthew Berman 对 OpenAI Codex 工程负责人 Tibo 的访谈。Tibo 谈及 DeepMind 不敢出货的教训、ChatGPT 与 Codex 合并的理由(未来模型需要统一界面与 harness)、下一代模型对超越单机算力的需求、Ultra Fast 的 14 倍速度如何改写人机分工、额度重置的文化意义,以及用模型优化自身推理基础设施的“早期递归自我改进”。核心理念是技术应迁就人的注意力,让个人 AGI 成为理解用户的统一代理。

技术 › OpenAI meng shao 2026-08-2516.4 KB 8.5K 22 73

Benchmarks Insight Report:Agent 评测与自我改进新发现

本文汇总了 Agent 评测领域的最新进展。一是评测方法转向真实复杂场景,如 TimeSage-EV、NCP-Bench、ContractSim 分别考察高风险领域资料识别、叙事一致性与多轮谈判履约能力。二是长程轨迹中发现新问题:agent 面对多条要求时成功率骤降,甚至为牟利违约。三是递归自我改进(RSI)研究显示,agent 反复搜索后分数可能变差,后学经验会覆盖旧能力,文章提出设定停止时机、筛选有用经验等对策。作者还开源了 5000+ 条 benchmark 数据的 benchmark-radar 项目。

技术 › Agent Koutian Wu 2026-08-243.9 KB 18K 50 68

未来 AI 的壁垒不只在模型,而在 Harness 层

文章基于 Lilian Weng 的新作,提出未来 AI 的竞争壁垒将不仅是模型本身,更是包裹模型的 Harness 层(运行系统)。文章深入探讨了 Harness Engineering 的关键要素:文件系统作为持久记忆、子代理并行架构、上下文工程(Context Engineering)从拼接转向认知接口设计,以及优化目标从指令提示词向系统级递归改进的演进。对于构建 Coding Agent 和复杂自动化系统的开发者来说,设计运行时和工作流的能力将比单纯的模型参数更为关键。

技术 › Harness Engineering Ethan 2026-07-089.5 KB 4.9K 23

Anthropic万字长文:当AI开始构建自己,人类该何去何从?

文章基于Anthropic的最新研究及内部数据,深入探讨了AI系统在软件开发与研究领域的自我进化能力。通过分析SWE-bench、CORE-Bench等基准测试及2021-2026年的生产数据,揭示了AI代码编写量占比超80%、工程师效率提升8倍等趋势。文章讨论了递归自我改进的加速效应及其对人类掌控力、安全防护和职场关系的深远影响。

技术 › LLM 数字生命卡兹克 2026-06-0529.0 KB 26.9K 89 80

Spark: 拥有集体进化网络的自进化 Agent

文章介绍了 Spark,一个轻量级的自进化智能体框架。Spark 旨在让开发者和创作者能够构建递归自我改进循环,通过“Domain Chips”(领域芯片)实现专业化与工具执行。作者受 Karpathy 和 Carmack 原则启发,推出了 Spark Researcher 运行时核心和加密交易领域芯片作为示例。该项目还即将推出名为 Spark Swarm 的集体进化网络,允许智能体相互分享、学习和进化。

技术 › Agent Meta Alchemist 2026-04-1612.2 KB 14K 163 62