Wiki 知识库

全部文档 / 作者: VoxCat

13 篇
清除

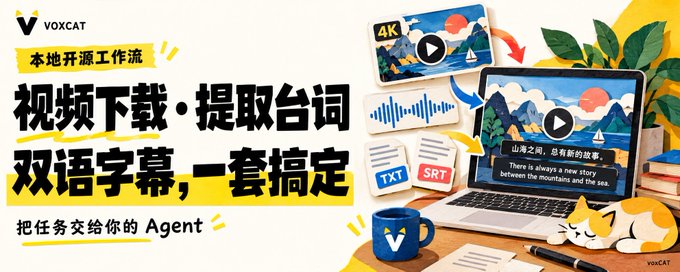
4K 视频下载、AI 提取台词、导出双语字幕:本地开源工作流

文章介绍了一套完全开源免费的本地工作流,替代收费视频解析网站。核心工具为 yt-dlp + FFmpeg 下载全网主流平台 4K 高清视频,再用 faster-whisper large-v3 模型在本地显卡上约 30 秒即可提取视频台词,生成带时间轴的 SRT 字幕与 TXT 文本,并可导出双语字幕。作者强调无需写代码,只需将准备好的提示词发给 Claude Code 或 Codex 等 AI Agent,即可自动完成安装与运行。该流程适用于视频二创、解说拆解、文案分析和知识库构建,兼具隐私保护和零成本优势。
技术 › 工具与效率 VoxCat 2026-10-245.0 KB 3.9K 21 75

我用 Opus 5.5 做了 5 部动画:“一句话生成”的真相

作者在 Opus 5.5 发布后实测“一句话生成动画”的真实效果,从 5 秒片名卡做到 195 秒讲解动画,共完成 5 部作品。结论是:一句话确实能生成好看的内容,但成功区间很窄——只有短、内容自由、无标准答案的片名卡一次通过。片子一长、内容一定,就出现牙齿数量错误、画面冻结、占位文字残留等细节问题,需借助独立 AI 审查与人工把关。作者总结:意图与感知只能由人提供,并给出开工前给齐决定、先看抽帧拼图、另开 AI 审查、反馈带时间码、沉淀素材五条实践建议。

技术 › LLM VoxCat 2026-10-217.1 KB 3.7K 13 82

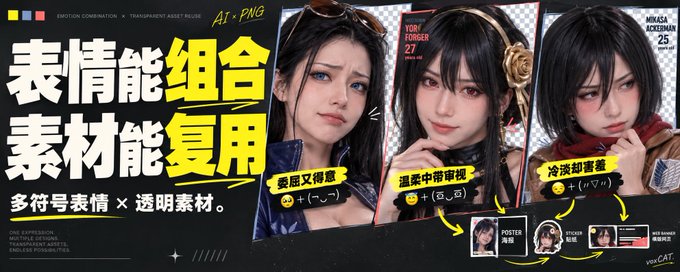
这次 AI 出图,我终于不用整张重来了

作者分享了使用 GPT-image-2.5 生成透明背景图片的体验。透明图让满意的人物素材可以被保留和复用,换背景、改排版时无需整张重做。文章建议从存储整张图转向积累素材零件:人物、道具、装饰、特效分别存档,并介绍了多符号复合表情系统的设计方法(如 emoji 与颜文字组合塑造复杂神态)。同时强调要仔细检查素材边缘质量(发丝、半透明部分),提出从确定用途、单独生成主体、多底色检查到保留原始 PNG 的素材库搭建流程,倡导以可复用思维做 AI 出图。

技术 › 工具与效率 VoxCat 2026-10-155.9 KB 7.8K 73 79

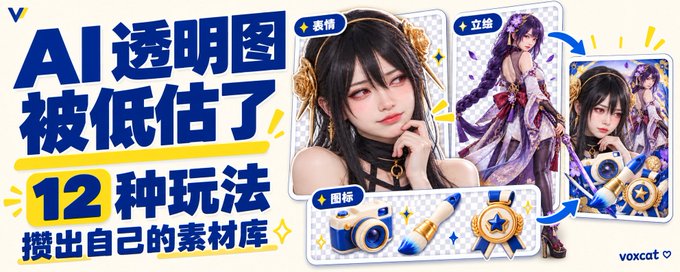
AI 透明图被低估了:12 种玩法,攒出自己的素材库

文章介绍如何用 ChatGPT、Codex 等工具直接生成带 Alpha 通道的透明 PNG 素材,并系统梳理了 12 类应用场景:聊天表情包、游戏立绘、VFX 特效、海报拼贴、产品图、UI 图标、装饰素材、像素游戏资产、Live2D 素材、直播包装、特殊材质以及阴影光效辅助素材。作者还提出五个进阶方向:模块化角色生成、实验摄影、复合表情资产、视觉特效库和素材处理工作流,并附上通用透明角色素材提示词模板,帮助读者积累可复用的个人素材库。

技术 › 工具与效率 VoxCat 2026-10-159.4 KB 9.1K 77 79

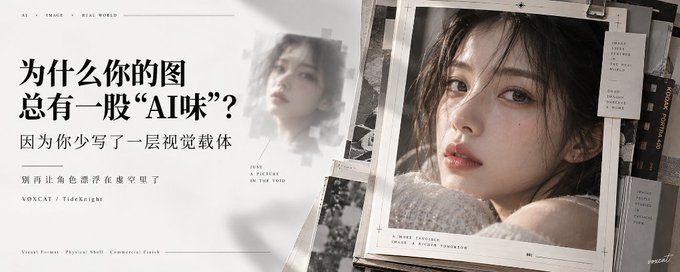
为什么你的图总有一股“AI味”?因为你少写了一层视觉载体

文章探讨了AI生图常带“AI味”的根本原因:角色漂浮在数字虚空中,缺乏“视觉载体”(Visual Format)。作者剖析三大病灶:无边界感、无功能动机、信息层次塌陷,并区分风格、载体与输出规格三个概念,提出“商业完成度=主体×风格锚点×视觉载体”的公式。视觉载体通过语境世界观、触觉通感和强制留白来消解塑料感。最后给出三条工程心法:载体前置、描述物理结构、留白策略,帮助创作者从“画画的人”转变为“视觉导演”。

技术 › 工具与效率 VoxCat 2026-10-047.4 KB 13.9K 144 78

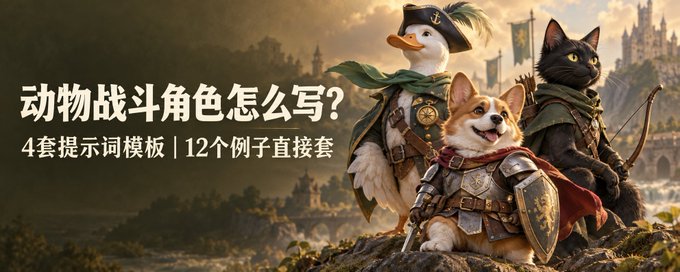
动物战斗角色怎么写?4套提示词模板,12个例子直接套

文章介绍如何用提示词生成动物拟人战斗角色的AI绘图方法。核心公式为:动物识别点+职业+反差记忆点+服装武器+动作构图+画面风格。作者提供了4套可直接套用的模板:单角色通用版、3D游戏广告版、群像小队版和超短万能版,每套配3个实例,如白鸭突击队长、黑猫刺客、浣熊重装兵、柯基骑士等。关键在于先保住动物特征,再让职业一目了然,最后用小反差点让角色令人印象深刻。

技术 › Skill VoxCat 2026-09-296.1 KB 5.6K 42 78

装了几个 Agent 之后,我发现它们根本不适合我的电脑

作者分享了自己搭建个人远程工作流的经验:通过 Telegram 连接本地 Eagle 资产库和电脑开发工具,实现手机发指令、家里电脑自动执行任务的闭环。作者认为通用 Agent 不适合有固定规矩的本地环境,转而采用任务分流架构:图片归档直接调用 Eagle API,轻量任务用轻量模型,复杂工程交给 CLI 无头模式执行。文章还解决了 Telegram 相册消息拆分、远程唤醒阻塞前台等实际问题,用标准输入传任务、保存会话 ID、文件夹记录状态等细节保证流程稳定,强调 Agent 应安静接入工作流,而非做万能的电子宠物。

技术 › Agent VoxCat 2026-09-244.8 KB 3.1K 5 83

图片存下来了,Prompt 呢?

作者分享了开发一个 ChatGPT 生图内容导出工具的过程与思考。工具的核心不是下载图片,而是把图片与创作过程准确关联:区分 Base Prompt 与增量 Revision、识别聊天中真正的生图 Prompt、将参考图与生成图分类(Generated/Edited/Reference),并把创作信息写入 Eagle 素材注释,方便日后按项目与链路检索。工具还处理了长对话加载、批量导出去重、限流重试、断点续传等细节,并诚实说明了局限。作者已将工具开源,旨在保留 AI 视觉探索的完整创作链路,而非仅保存成片。

技术 › 工具与效率 VoxCat 2026-09-239.2 KB 7.5K 69 79

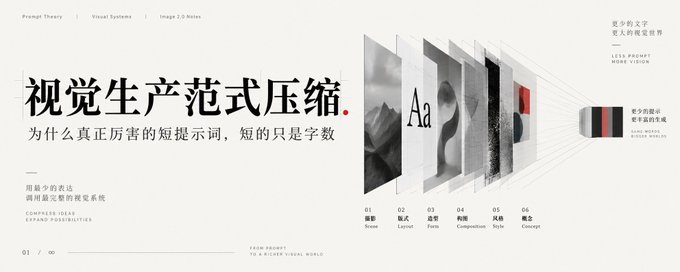
视觉生产范式压缩:看懂这篇,你才算开始会用 Image 2

作者通过长期测试 Image 2.0 图像生成模型,发现极短提示词反而能生成异常完整的画面,并提出“视觉生产范式压缩”理论。核心观点是:提示词信息量与字数无关,关键在于“高密度视觉概念”——如“编辑式人像”“极简时尚封面”等概念,能自然带出一整套摄影、造型、构图、版式等视觉惯例。好的组合应让不同概念各有侧重,形成一份简短的创意简报。这种方法通过控制高层结构、保留低层执行自由,让模型在成熟的视觉系统内完成设计。提示词的核心能力已从“描述画面”转向“选择视觉世界”。

技术 › LLM VoxCat 2026-09-118.9 KB 27K 95 81

施工图 vs 创意简报:跨模型图片生成迁移时提示词的正确改法

文章针对在 Google Nano Banana 与 OpenAI GPT Image 2 之间迁移图片生成提示词时的常见误区进行辨析。作者指出长提示词翻车的根源不在长短,而在于信息冲突、约束缺乏优先级、参考图职责不清以及一次性要求过多。文章提出'创意简报'与'结构化施工图'两种提示模式应按偏差成本选择而非按模型选择,并给出重做任务定义、约束优先级、参考图职责与迭代方式的四层迁移框架,最后强调模型差异需通过严格的对照实测验证。

技术 › LLM VoxCat 2026-08-199.9 KB 4.9K 4 82

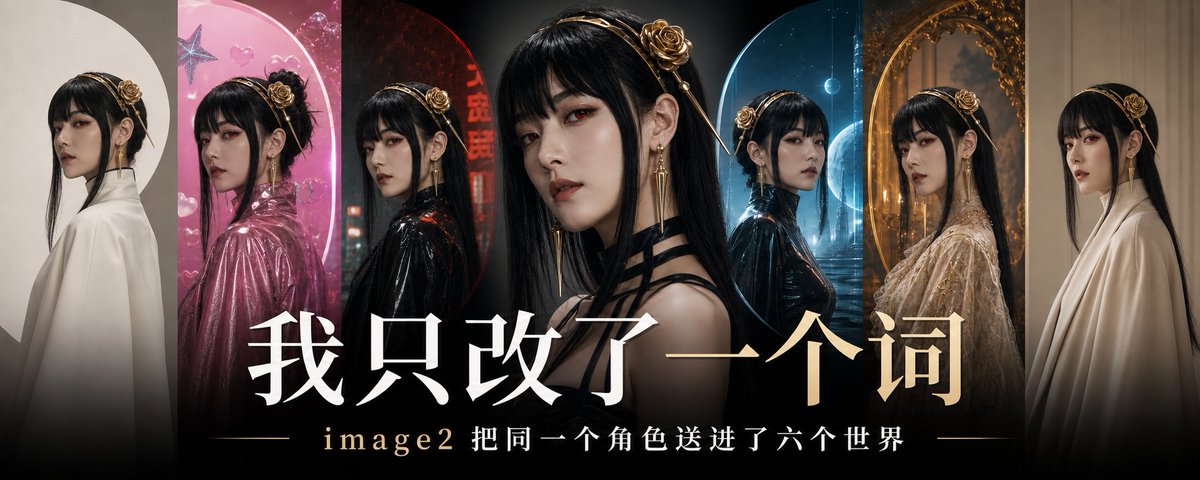
只写「风格词+角色名」,image2 为什么还能出神图?

本文通过控制变量实验,测试了仅使用“风格词+角色名”的极短提示词在 image2 图像生成中的效果。作者以约尔和春丽两个高辨识度角色为对象,分别搭配 editorial、Y2K、neo-noir、retro futurism、rococo、quiet luxury 六种风格词,观察模型如何自动决定场景、服装、光线、版式等视觉元素。结果显示,风格词能调用一整套视觉系统,而角色名则提供身份锚点,两者共同作用产生多样且符合预期的图像。文章还探讨了短提示词的适用边界,指出真人或动漫等媒介约束需显式声明,并总结了高密度风格词的特征及使用建议。

技术 › 工具与效率 VoxCat 2026-08-1414.8 KB 39.2K 70 84

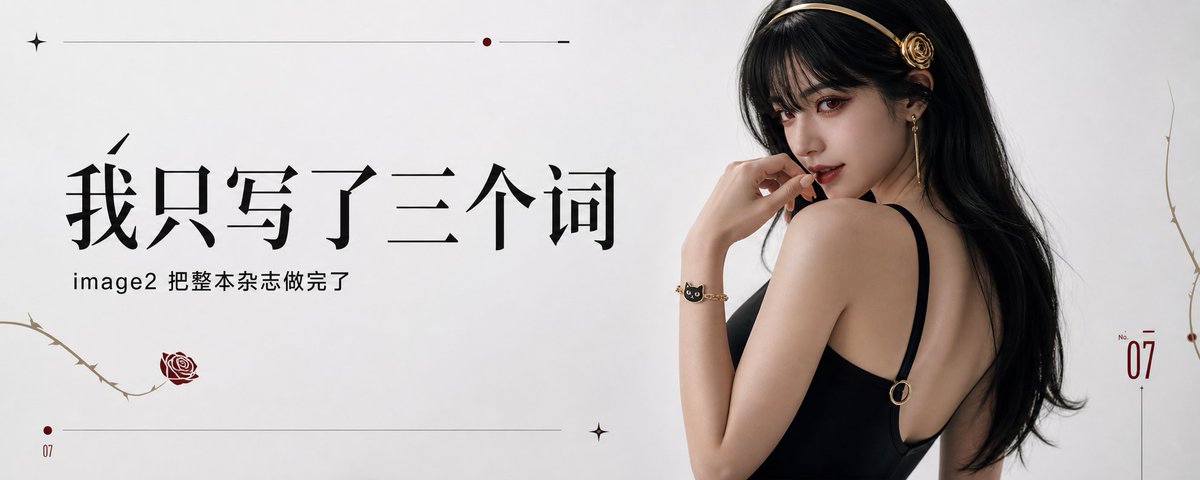
我只写了三个词|image2 把整本杂志做完了

本文探讨了在 OpenAI 的 image2 图像生成模型中使用短提示词生成高质量时尚封面图像的方法。作者发现,通过组合“极简时尚封面感”、“editorial 人像”、“独立艺术企划主视觉”和具体角色名,可以稳定生成具有专业设计感的图像。文章分析了每个短语的作用,指出它们分别对应摄影语言、版式秩序、概念用途和角色身份,形成分工明确的视觉生产系统。作者还讨论了短提示词的有效性取决于风格词的“厚度”和角色的鲜明度,并强调了提示词信息结构的重要性。

技术 › 工具与效率 VoxCat 2026-08-139.8 KB 130.6K 206 78

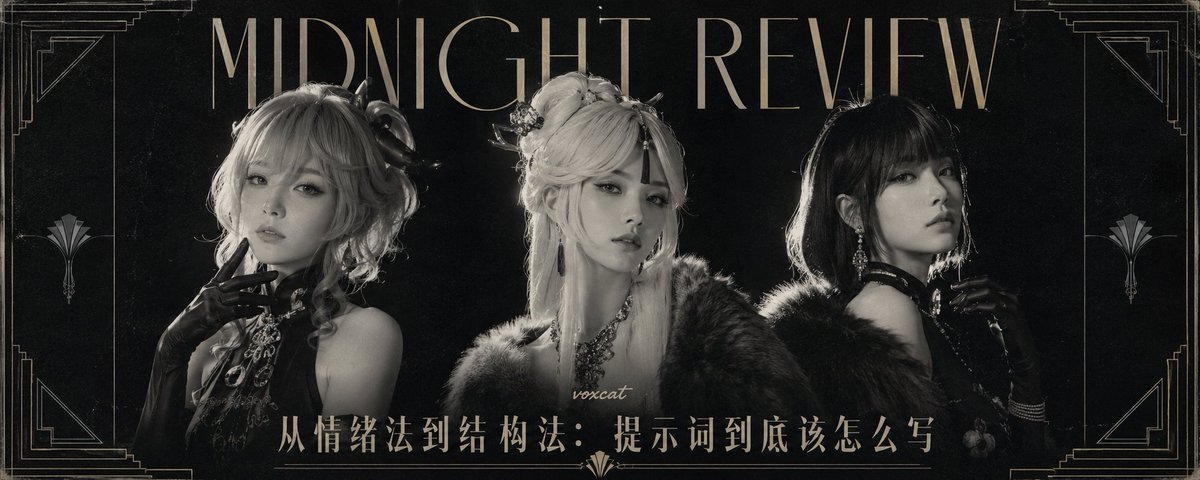
我写提示词时,不再只靠感觉了

文章探讨了提升AI提示词(Prompt)质量的思考,对比了“情绪法”与“结构法”的区别。作者指出,单纯依赖情绪词汇虽能营造氛围但缺乏稳定性,而结构法通过定义载体、光线、构图等参数确保结果可控。最终提倡“混合法”,即用结构锁定画面骨架,再用情绪补足灵魂,将提示词从“许愿文”转化为精准的“视觉合同”。

技术 › LLM VoxCat 2026-05-146.7 KB 65.1K 263 83