Wiki 知识库

全部文档 / 作者: huangserva / 标签: DeepSeek

4 篇
清除

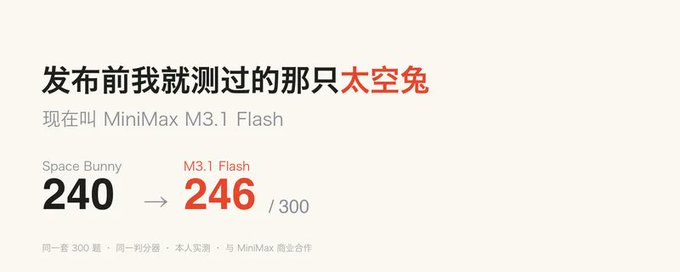
发布前我就测过的那只太空兔(Space Bunny),现在叫 MiniMax M3.1 Flash

作者在 MiniMax M3.1 Flash 还以匿名模型 Space Bunny 身份活跃时,用自己维护的 300 题封闭测试集(HumanEval+/MBPP+ 代码题与 MMLU-Pro 推理题)进行了评测,匿名期得 240 分。正式版发布后用同一套题复测得 246 分,两版表现几乎一致,主要提升在代码题。代码能力与 DeepSeek V4.1 Flash-1017 基本打平;官方数据显示其在企业流程自动化和操作电脑两项为国产第一,且成本显著低于 Claude Opus 5。短板是困难推理。整套 300 题成本仅一元出头,性价比突出。

技术 › LLM huangserva 2026-10-2410.5 KB 36K 29 81

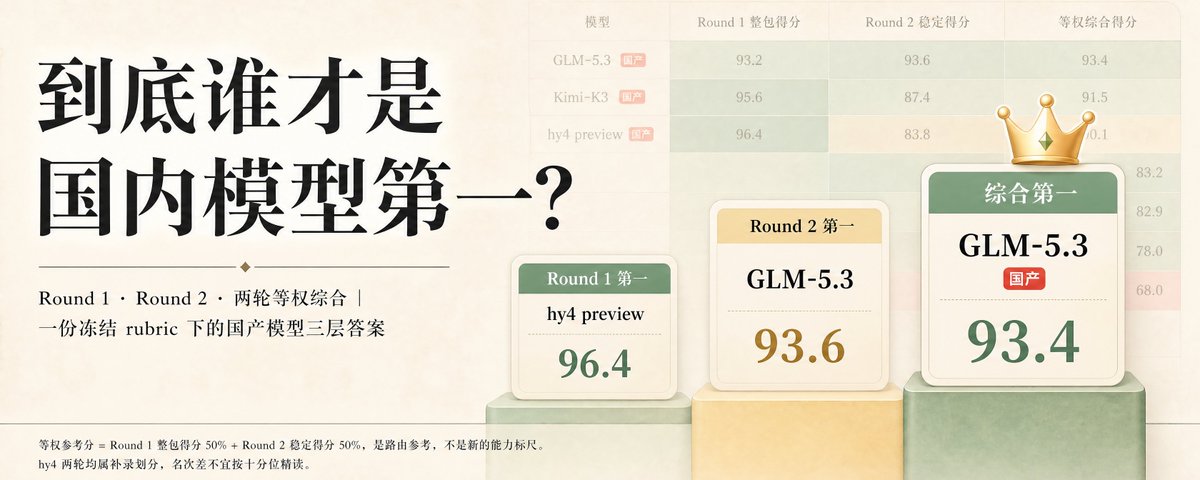
到底谁才是国内模型第一?

作者基于一份冻结 rubric 的自建评测(10 维 × 5 细项),通过 Round 1 超长整包和 Round 2 拆题稳定两轮测试对比八个大模型。Round 1 整包交付第一是 hy4 preview(96.4 分),Round 2 拆题稳定第一是 GLM-5.3(93.6 分);综合等权评分 GLM-5.3 以 93.4 分居国产第一,Kimi-K3 以 91.5 分列第二,hy4 因拆题时违反约束跌至 83.8 排第三。DeepSeek V4 Pro 与 Qwen3.8 Max 表现偏科,榜单前三均为国产模型。评测题面与方法已开源,结论是决定「第一」的不是最高一次成绩,而是每一次的稳定表现。

技术 › LLM huangserva 2026-08-2910.4 KB 228.8K 66 85

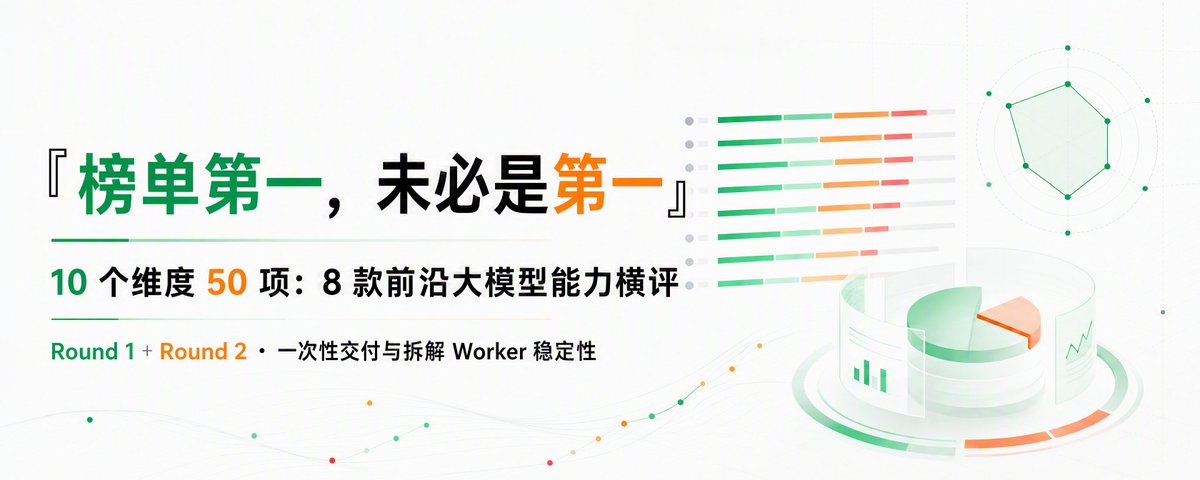
8款前沿大模型能力横评:10个维度50项测试全解读

本文对8款前沿大模型进行了为期两天的深度横评,通过10个维度、50个细项的两轮测试,对比了模型在一次性复杂任务与拆解任务稳定性上的表现。文章详细解读了测试方法、评分标准及各模型优劣势,最终得出了适用于真实工作流的参考结论。

技术 › LLM huangserva 2026-08-1729.7 KB 30.7K 43 86

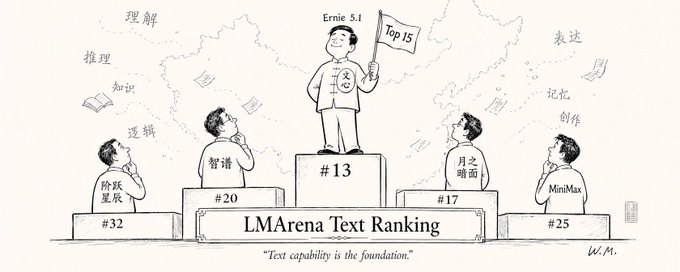
LMArena 最新排名:文心 5.1 预览版国产登顶,文本能力仍是核心

本文基于 LMArena 最新文本排行榜更新,探讨了文心 5.1 Preview 凭借 1476 分拿下国内第一、全球第 13 的成绩。作者分析了为何在 DeepSeek V4 和 GPT-5.5 主导的时代,文本能力依然是大模型代码生成与逻辑推理的“基本盘”。文章指出文心通过「多维弹性预训练」技术实现了高性价比与高性能,验证了夯实文本底座的重要性。

技术 › LLM huangserva 2026-05-015.1 KB 237.7K 78 43