Wiki 知识库

全部文档 / 标签: GLM-5.3

5 篇
清除

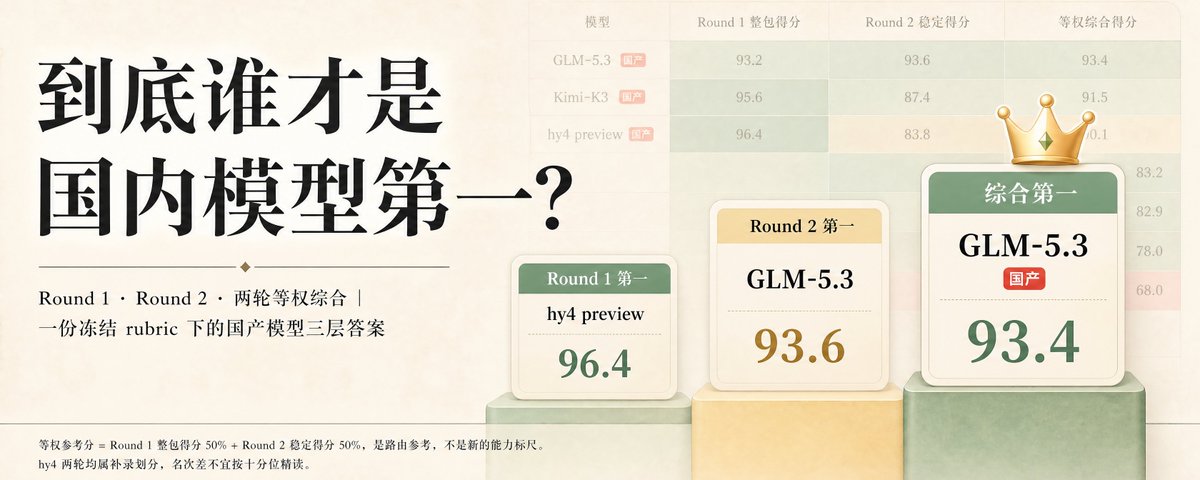
到底谁才是国内模型第一?

作者基于一份冻结 rubric 的自建评测(10 维 × 5 细项),通过 Round 1 超长整包和 Round 2 拆题稳定两轮测试对比八个大模型。Round 1 整包交付第一是 hy4 preview(96.4 分),Round 2 拆题稳定第一是 GLM-5.3(93.6 分);综合等权评分 GLM-5.3 以 93.4 分居国产第一,Kimi-K3 以 91.5 分列第二,hy4 因拆题时违反约束跌至 83.8 排第三。DeepSeek V4 Pro 与 Qwen3.8 Max 表现偏科,榜单前三均为国产模型。评测题面与方法已开源,结论是决定「第一」的不是最高一次成绩,而是每一次的稳定表现。

技术 › LLM huangserva 2026-08-2910.4 KB 228.8K 66 85

GLM 5.3: Scaling with Post-training, Intuitively Explained

文章解析了 GLM-5.3 如何在不重新预训练的情况下,仅通过规模化后训练(RL)超越 GLM-5.2,印证了 Sutton 的苦涩教训。重点包括:一是面向真实专家工作的环境设计,用研究代理生成长时程任务,配合严格的验证器三重检查防止 reward hacking;二是沿用 GLM-5.2 的 MoE 架构(744B 总参、~40B 激活),采用 MLA 压缩 KV cache、DeepSeek 稀疏注意力降低长上下文成本、MTP 投机解码平均每次接受约 4.5 个 token,以及 IndexShare 在相邻层共享索引实现 2.9 倍 FLOPs 节省;三是 SAO 算法与 slime 基础设施,将低廉的 rollout 转化为稳定的大规模后训练。

技术 › LLM Alex Ker 2026-08-2913.2 KB 103.9K 410 77

WorkBuddy首发Hy4 preview实测:对手是Kimi K3和GLM-5.3

作者实测腾讯混元Hy4 preview模型,该模型在WorkBuddy中首发并限时免费。Arena代码榜1633分,与Grok-4.6、Claude等旗舰模型处于同一区间。作者通过Three.js体素游戏、HTML PPT制作、信息真实性核实及脏数据表分析等多维度实测,对比Kimi K3、GLM-5.3和上一代Hy3。结果显示Hy4 preview不仅规格完成度高,更在数据陷阱识别上以7/7胜出,能主动指出问题本身不成立、标注已知缺陷,展现出「敢质疑数据」的审计能力,作者认为腾讯的模型能力已真正赶上头部水平。

技术 › LLM 花叔 2026-08-2814.7 KB 13.7K 30 87

V4Flash 的价格、Opus4.8 的能力:智谱 GLM-5.3 Flash(Ox Alpha)正式开源

匿名模型 Ox Alpha 揭晓为智谱 GLM-5.3 Flash,320B 参数、MIT 开源、原生多模态、1M 上下文,限时价格仅为 Opus 4.8 的 1/40。作者通过三个前端场景实测:仅凭一张图用 Three.js 复刻玻璃折射海报、看录屏视频还原 60 片玻璃螺旋彩带交互网站、将静态体素海报改造为滚动揭示的 3D 网页,均表现出顶级多模态理解与代码能力,远超同价位的 DeepSeek V4 Flash,接近 Fable 5 但便宜约百倍。作者认为其把'便宜又够用'的行业斩杀线大幅推进,让预算有限的创作者也能用上前沿智能。

技术 › LLM 歸藏(guizang.ai) 2026-08-2712.0 KB 113.6K 72 77

GLM-5.3 开放发布:通往网络防御的负责任之路

本文介绍了 Z.ai 公司发布 GLM-5.3 模型的情况,该模型在网络安全任务上表现显著提升,如漏洞发现、利用分析和多步安全任务。文章强调了负责任开放的重要性,采取分阶段发布策略,并介绍了安全评估、披露流程和防御性安全措施,旨在平衡开放与安全。

技术 › LLM Z.ai 2026-08-1411.2 KB 266.8K 1.9K 71