Kimi K3.1 Pro 实测对比 GPT-6 Astra:3D 建模能力与成本分析
本文实测对比了 Kimi K3.1 Pro 与 GPT-6 Astra 在多个 3D 任务上的表现,包括古建筑建模、机械结构、透明材质和游戏开发等。结果显示,Kimi 在精细模型构建上更优,而 GPT 在大型场景稳定性上更好。成本方面,Kimi 比 GPT 便宜约 80%,性价比突出。文章还提供了使用 Kimi 进行 3D 建模的入门指南。
本文实测对比了 Kimi K3.1 Pro 与 GPT-6 Astra 在多个 3D 任务上的表现,包括古建筑建模、机械结构、透明材质和游戏开发等。结果显示,Kimi 在精细模型构建上更优,而 GPT 在大型场景稳定性上更好。成本方面,Kimi 比 GPT 便宜约 80%,性价比突出。文章还提供了使用 Kimi 进行 3D 建模的入门指南。
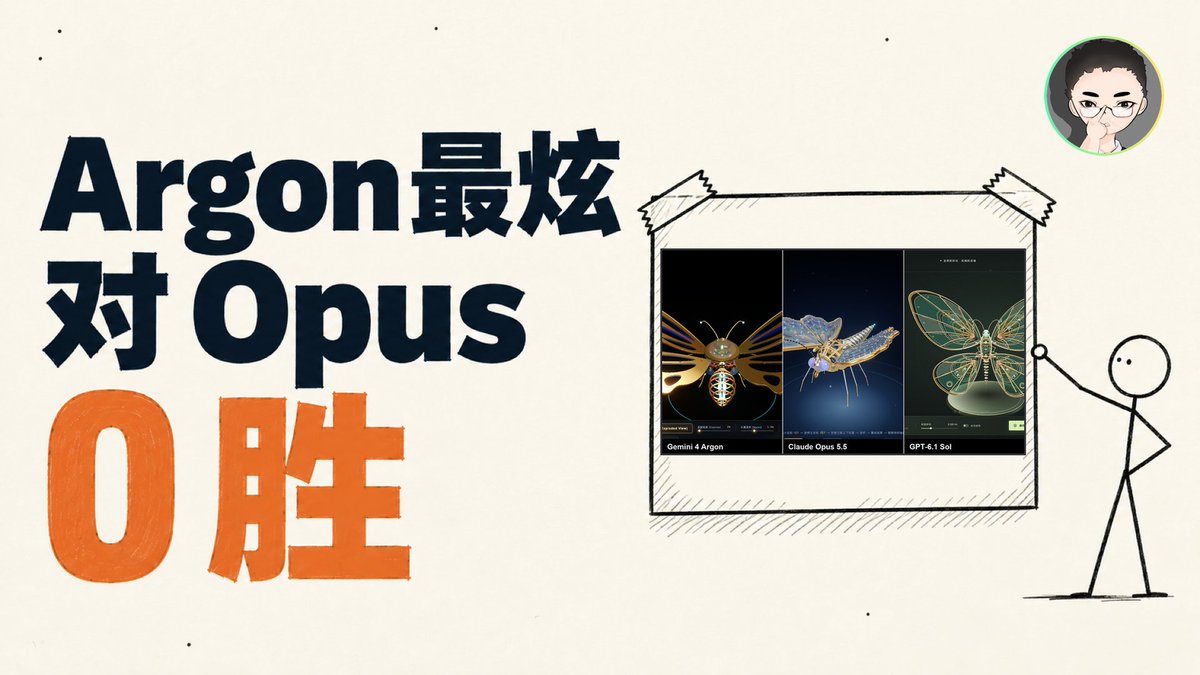
作者用同样的 12 道题横向实测 Gemini 4 Argon、Claude Opus 5.5 与 GPT-6.1 Sol。Argon 在 Gemini 网页 App 中闭卷盲打,另两家则通过 Claude Code 与 Codex 命令行 Agent 拥有自测调试的工作流。结果 Argon 对 Opus 0 胜 5 平 7 负,对 GPT 2 胜 4 平 6 负。失分分两类:铁路、咖啡店、四季三题毁于作用域未定义、少打空格、404 地址等小错,补一两行即可运行,根源在 App 环境无法自测;而机械蝴蝶连杆伸缩、折纸裂开、书封视觉误读、西瓜过曝等属于硬伤。Argon 在视觉题与原创游戏上表现出色,Pro 额度也较充裕。
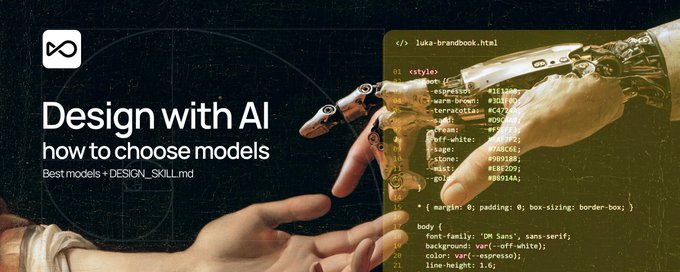
作者基于 OpenArt Arena 的匿名排名,从各创意设计榜单中选出前三名 AI 模型,并用虚构咖啡品牌 Luka 的品牌手册作为统一视觉基准,在产品图、平面海报和动态设计三类任务上进行实测对比。评估标准包括品牌还原度、设计质量和生成价格。作者通过 After Effects 对齐原始 SVG 检查 logo 还原精度,给出各模型的优劣分析与评分表格。结果显示 Seedream 5.0 Pro 在产品图上表现最佳且成本最低,Grok Imagine 2.0 在平面设计中胜出。文章还提供了完整的方法论和可复用的 Design_Judgment_Skill.md。
Jared Palmer(Cognition)开源了 Kev,一族建在 Qwen3.5/3.8 之上的 Jev 式小型决策模型(0.8B~27B,Apache-2.0)。文章介绍了 Kev 与 Jev 的对比数据:Kev-27B 在新数据源上与 Jev 相差一个点以内,但作者强调这不是受控比较。最有价值的部分是完整的微调闭环:通过 coding agent 的 skill,可自动从用户代码中找出问题、转换已有标签、在 Modal 上微调并部署,一次 Kev-4B 训练在 H100 上约 1 美元,示例中把准确率从 67.7% 提到 73.6%。文章还总结了校准温度、问题隔离设计等工程细节,以及作者诚实的自我限制态度。
作者从模型能力、产品功能、实测案例三个维度对比AI办公Agent产品WorkBuddy与豆包工作。模型方面,WorkBuddy支持接入DeepSeek、GLM等第三方模型,生态开放;豆包工作封闭,仅用自家Seed系列。生图生视频方面豆包完胜,Seedream 5.0和Seedance 2.5领先。产品功能上WorkBuddy的Skill生态更丰富,免费积分获取途径多、使用成本更低;豆包在手机遥控电脑方面体验更好。实测中两者使用同一Seed2.1 Pro模型,豆包在指令遵循和AI味控制上表现更佳,复杂规划任务耗时更短。文章认为两者各有优劣,选择取决于用户具体需求。
Anthropic 与 OpenAI 同日分别发布 Claude Opus 5.5 和 GPT-6 Sol。作者通过 5 个实测案例对两大模型进行对比评测:SVG 画熊猫骑车、300 字科普写作、3D 重庆城市生成器、操作电脑画 Q 版鲸鱼娘、复刻 Cursor 工具。结果显示,Opus 5.5 在智能程度、生成质量和细节刻画上全面领先,尤其在 3D 城市生成和复刻 Cursor 任务中表现惊艳,而 GPT-6 Sol 虽然速度快一倍、价格减半,但完成度明显逊色。
作者对 GPT-6 Sol、GPT-6 Luna 和 Claude Opus 5.5 三款新模型进行横向实测。价格方面,GPT-6 系列比 GPT5.6 便宜 50%,Opus 5.5 速度提升 30%、成本降低 40%。通过鹈鹕骑单车、可互动饺子网页、前端动效设计、写作 skill 生成、Blender 3D 建模复现舞蹈等多个案例对比,作者发现 Opus 5.5 在终端编程和前端能力上依然领先,细节表现惊艳;GPT-6 Sol 速度极快且能力不俗;Luna 则适合简单批量 Agent 任务。总体来看三款新模型在性能与成本上均有显著进步。
文章对比评测了同日凌晨发布的Grok 4.7与小米MiMo V2.6两款大模型。作者提出大模型的"不可能三角"——性能、价格、速度难以同时满足。Grok 4.7表现低于预期,前端能力崩盘,Coding Agent评测得分惨淡;而MiMo V2.6则超出预期,AA指数46分与Grok 4.7打平,位列开源与国产第一,CritPt科研推理仅次于GPT和Claude,价格极低(缓存输入0.025元/百万Token),输出速度达130 Token/s,成为作者心中解决不可能三角的版本答案。作者还介绍了小米公开直播强化学习训练过程的创新做法及其技术报告。
作者对比Claude、GPT、Grok等模型后,认为Gemini写出的自媒体文案AI腔最轻、最像人话。文章提出三步方法论:先训练文风档案(提炼人格、情绪强度、句式等特征),再挂载到Gemini的gem中,最后用短码调用。日常写作中,gem占70%、普通对话占30%;长文截断时明确告知续写位置;gem拒答时用反问法确认任务正当性。完整流程跑通后,一篇1500字文案约20分钟完成。作者也指出Gemini在深度技术分析、项目管理、多模态任务上的边界,建议各模型分工协作。
文章介绍了 9 月 8 日发布的 GPT-Image 2.5,其核心突破在于精准局部编辑和多轮一致性:只改指定区域、其余细节保持不动,长对话反复修改不掉画质,改变了以往'抽卡式'生图的痛点。新功能包括 @Sketch 手绘草图定构图、图片内评论标注、模板和提示词分享。API 推出 Flare(更快)和 Sunburst(更精)两个模型,价格相同,盲测分数统计上难分高下,跑量场景推荐 Flare。但新模型单价较 gpt-image-2 翻倍,一次成型、无需返工的场景不必升级。文章还提醒透明背景等并非全新功能,并给出三条实操建议。
程序员鱼皮实测 OpenAI 最新发布的 GPT-6 Astra 模型,通过 4 个由浅入深的案例评估其能力:3D 程序化城市生成器、3D 奥德赛战争视频动画、复刻 Cursor 的全栈 AI 编程工具,以及操作 KiCad 完成电路板布线。结果显示 Astra 在前端审美、产品设计、生成速度方面较 GPT-5 系列大幅提升,且有自己的产品想法,速度比同级模型快近三分之一;但在精细的 Computer Use 画布交互上仍存在坐标不准等问题,且 Codex 额度消耗明显更快。作者认为 Astra 适合视觉要求高的前端和全栈项目,日常任务用国产模型更划算。
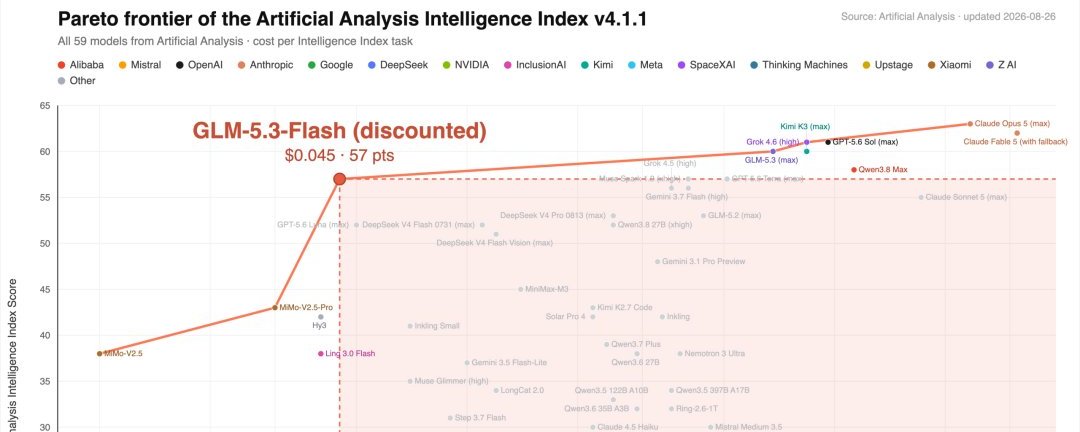
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。
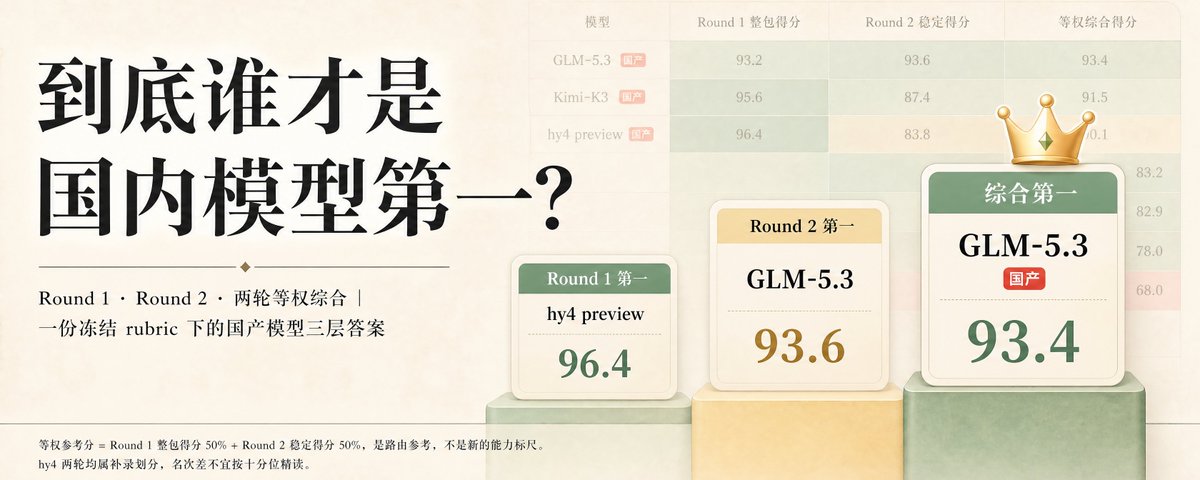
作者基于一份冻结 rubric 的自建评测(10 维 × 5 细项),通过 Round 1 超长整包和 Round 2 拆题稳定两轮测试对比八个大模型。Round 1 整包交付第一是 hy4 preview(96.4 分),Round 2 拆题稳定第一是 GLM-5.3(93.6 分);综合等权评分 GLM-5.3 以 93.4 分居国产第一,Kimi-K3 以 91.5 分列第二,hy4 因拆题时违反约束跌至 83.8 排第三。DeepSeek V4 Pro 与 Qwen3.8 Max 表现偏科,榜单前三均为国产模型。评测题面与方法已开源,结论是决定「第一」的不是最高一次成绩,而是每一次的稳定表现。
本文介绍了使用AI工具生成封面图的方法,重点强调生图模型的重要性(占80%),提示词仅占20%。作者分享了从图片反推提示词的技巧,并展示了自己用GPT Image2生成封面图的流程,同时提供了一套可复用的封面提示词模板。最后对比了国内模型(豆包Seedream5.0、千问Qwen-image3.0)的生成效果,并给出选择建议。
本文实测了 DeepSeek 开源的 Agent 框架 DeepSeek Harness(dsh),强调其“everything is a plugin”的设计理念,基于 Cordis 插件系统,可高度定制。文章介绍了四种预设模式(标准、PTC、极简、创造)的特点,并通过实际案例展示了 dsh 在代码审查、创意生成、性能对比等任务中的能力,最后探讨了模型与框架的乘法关系,推荐日常使用 v4-flash。
本文用办公室比喻,深入浅出地介绍了 DeepSeek Harness(dsh)的概念、组成、四种模式及其与 Claude Code、Codex 的区别。文章强调模型决定 Agent 的思考上限,而 Harness 决定其执行能力。dsh 作为开放实验场,允许用户自由组合模型、工具、Skills 等组件,但开源免费不等于安全,用户需注意权限控制。最后给出小白试用建议,并指出未来 Agent 竞争的关键在于模型之外的工作环境。
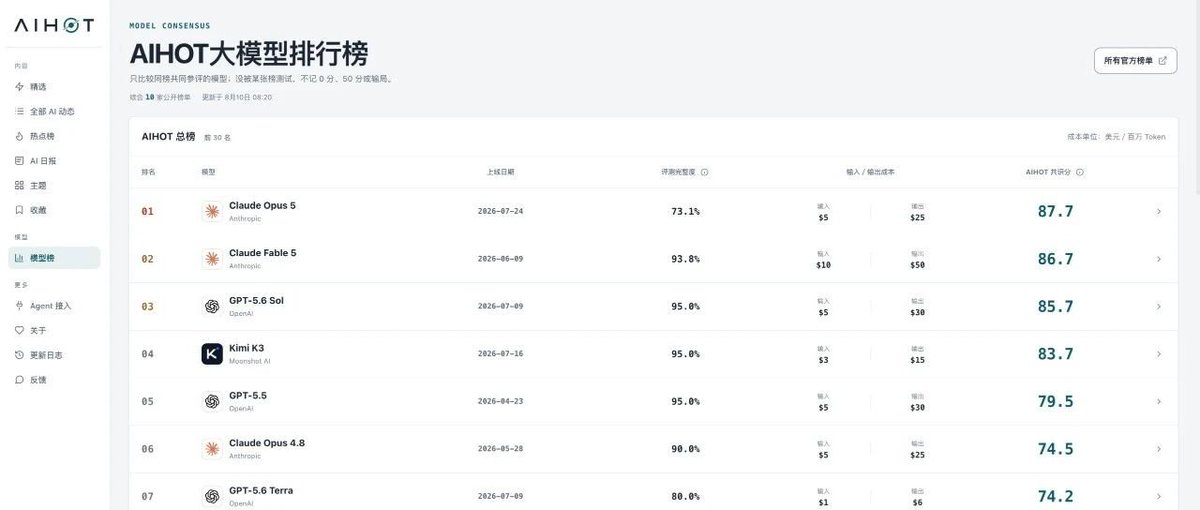
作者耗时54小时开发了一个全新的AI大模型聚合排行榜。为解决现有榜单数据缺失、样本量和标准不一的问题,作者参考电竞和统计学算法,自研了名为LatentRank的评分系统,通过模型间的成对比较来推算综合能力。目前该榜单已集成10个主流评测源,免费开放供用户查看和对比。
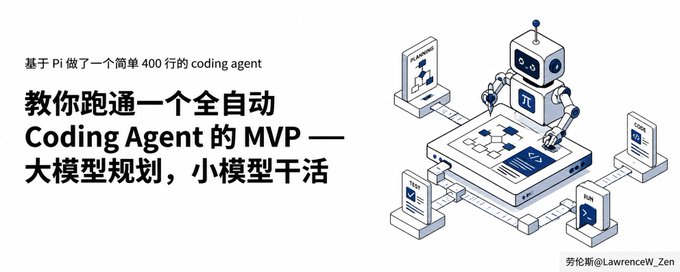
文章验证了一个关于多 Agent 编排的猜想,通过搭建 hero-coding MVP,对比了 ChatGPT 5.4、Ling-2.6-flash 和 Ling-2.5-1T 在编码任务中的表现。结果显示,非思考小模型(Flash)在明确 Bug 修复上比思考模型快 31%,而 Ling-1T 在加功能任务上仅需 11% 的 Token 和 63% 的时间。作者总结出“大模型规划,小模型干活”的最佳实践,并强调了非思考模型必须配合 Harness 工程兜底的重要性。
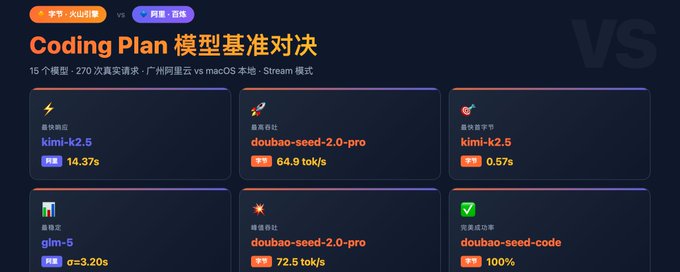
本文对比了字节火山方舟与阿里百炼两大平台的 Coding Plan API 服务性能。通过 270 次请求测试,从响应速度、吞吐量(TTS)和稳定性三个维度,对包括 GLM、Kimi、DeepSeek 等主力模型进行了评估。结果显示,对于相同的旧版本模型,阿里百炼在速度上完胜;而字节方舟在模型更新速度(如 k2.6)和覆盖广度上更具优势。
文章深入评测了 OpenAI 的新生图模型 GPT-image2,认为其虽然进步巨大,具备母语级中文理解能力和卓越的细节可控性,但推出时机过晚,提示词变现红利期已被 Gemini 的 Nano Banana Pro 吃尽。作者指出,未来 AIGC 将不再依赖复杂的“神仙提示词”,而是比拼创作者的构图与审美内卷。
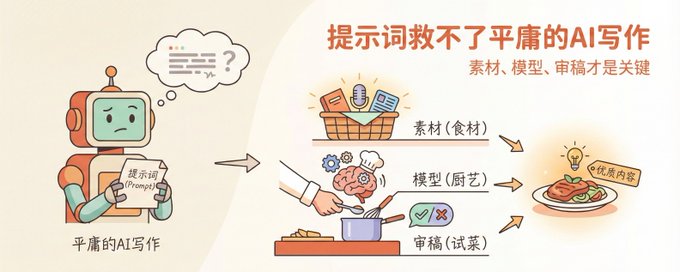
文章指出 AI 写作的质量关键不在于提示词,而在于素材质量、模型能力和审稿能力。作者将 AI 写作比作做菜,认为只有提供高质量的素材(食材),选择顶级的模型(厨艺),并具备优秀的审稿能力(试菜),才能产出优质内容。提示词仅相当于调料,只能起到锦上添花的作用。