Wiki 知识库

全部文档 / 标签: 性价比

10 篇
清除

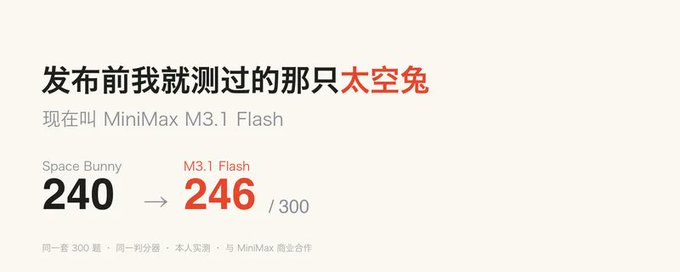
发布前我就测过的那只太空兔(Space Bunny),现在叫 MiniMax M3.1 Flash

作者在 MiniMax M3.1 Flash 还以匿名模型 Space Bunny 身份活跃时,用自己维护的 300 题封闭测试集(HumanEval+/MBPP+ 代码题与 MMLU-Pro 推理题)进行了评测,匿名期得 240 分。正式版发布后用同一套题复测得 246 分,两版表现几乎一致,主要提升在代码题。代码能力与 DeepSeek V4.1 Flash-1017 基本打平;官方数据显示其在企业流程自动化和操作电脑两项为国产第一,且成本显著低于 Claude Opus 5。短板是困难推理。整套 300 题成本仅一元出头,性价比突出。

技术 › LLM huangserva 2026-10-2410.5 KB 36K 29 81

DeepSeek V4.1 Flash 1017 实测:性能更强、费用更低的一次升级

DeepSeek 于 10 月 17 日发布 V4.1-Flash-1017 版本,AI 编程跑分显著提升,DeepSWE 达 77.0 超越 Claude Opus 5,任务平均费用降至原来的三分之一。作者使用 DeepSeek Harness 实测四个项目:3D 城市生成器对比显示新版的重庆、西安等地标建筑辨识度大幅提升,耗时从 102 分钟降至 61 分钟;许愿式编程能快速产出 3D 地铁跑酷游戏和天坛祈年殿建模;基于新开放的 Search/Fetch 接口开发的 AI 搜索引擎完成度很高。总花费仅 12.81 元,性价比突出,是一次实打实的帕累托改进。

技术 › LLM 程序员鱼皮 2026-10-1915.6 KB 8.2K 9 84

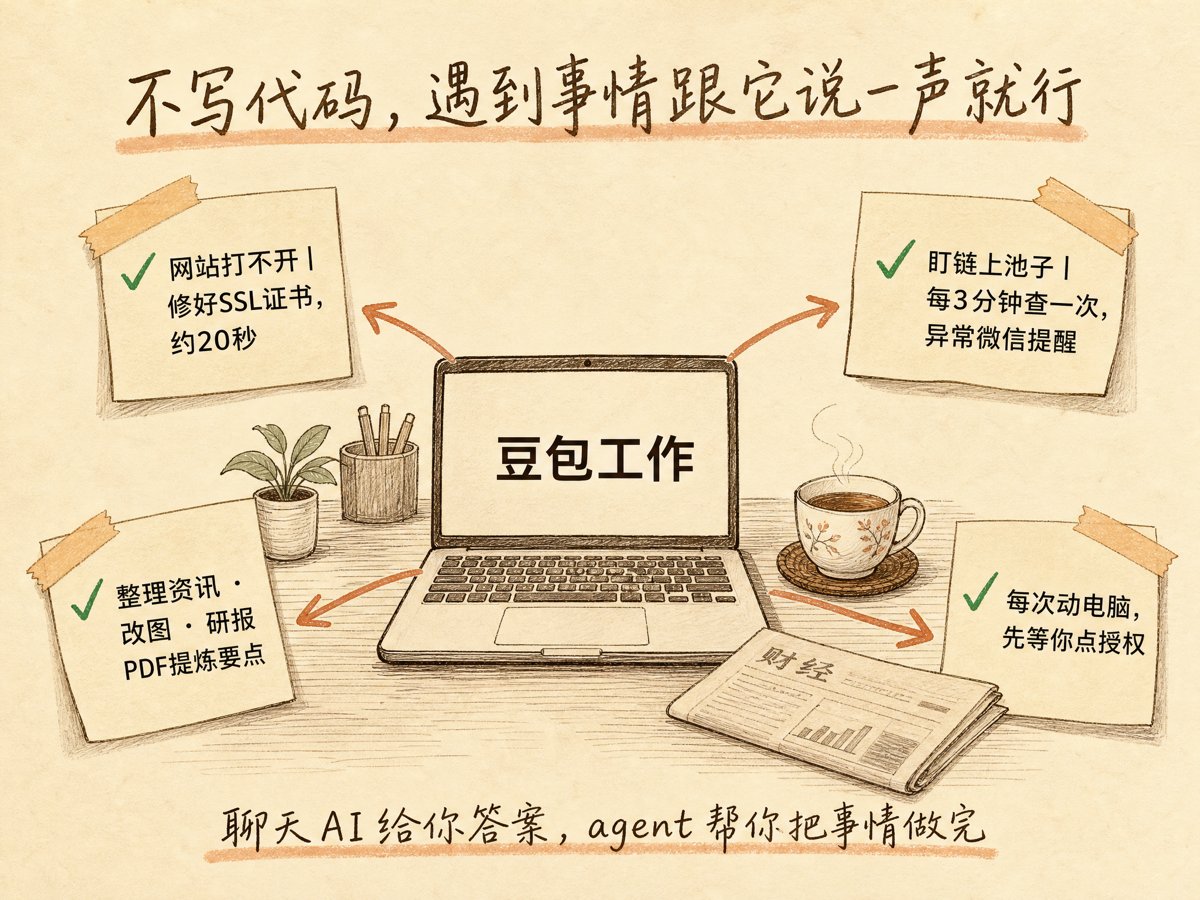
财经作者猫笔刀用豆包Agent的启示:Agent离普通人比想象更近

作者分享财经作者猫笔刀使用豆包工作(Agent)一个月的体验。猫笔刀不會编程,过去用AI只停留在问答层面,但豆包工作上线后他发现Agent能真正帮普通人做事:修复SSL证书故障、监控链上池子、整理资讯、提炼研报PDF等。与聊天AI不同,Agent能实际完成任务,且每次操作需手动授权,可控性强。价格方面,三档模型能力相同只差额度,68元/月足够日常使用,相当于一天两块多。文章认为Agent正从程序员专属工具走向普通人日常,类似拥有多个不知疲倦的助理。

技术 › Agent 老杨啊 2026-10-195.5 KB 53

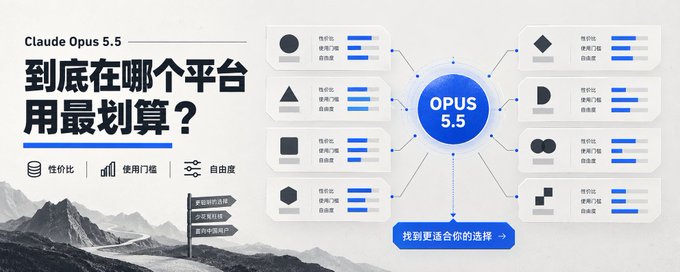
Claude Opus 5.5,到底在哪个平台用最划算?

文章从性价比和大陆用户使用门槛两个维度,盘点目前可用 Claude Opus 5.5 的正规平台。Claude 官方 Max 20 倍性价比最高但大陆门槛恶劣;Google Antigravity 的 Opus 额度很少,需搭配 Gemini 使用才划算;Cursor Ultra 跑 Opus 明显缩水,但 Cursor Models 额度很香;GitHub Copilot 价格透明、性价比不错;OpenCode Zen 无折扣但自由度高、支付方便;Kilo Pass 吃满 Bonus 后性价比不错;AWS 的 Kiro 性价比尚可但支付不便;Devin Desktop 额度较猛但学习成本高。最后建议先低门槛体验,再考虑高额度套餐,工具是拿来用的不是囤的。

技术 › Claude 冰河 2026-10-1113.4 KB 21.6K 105 86

Jev 模型实测:新闻分类任务上的速度、质量与价格三赢

作者分享了使用新模型 Jev 对《人民日报》新闻进行湖北相关元素分类的实测体验。此前该项目一直使用 Gemini Flash Lite 系列,积累约 2.4 万条数据。通过 OpenRouter 上线 Jev 后用相同提示词对比测试:速度上单篇耗时从 3 秒降至 0.35 秒,提升近 10 倍;质量上与 Flash Lite 仅 15% 判断不一致,且差异多源于人名知识库差异,实际正确率约 95%;价格上处理 5 千条数据 30M Token 仅花费 1 美元。作者认为 Jev 代表的分类器大模型在分类场景下实现了速度/质量/价格的不可能三角,极具前景,并计划连夜用于优化生产项目。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-195.0 KB 75

DeepSeek 视觉模型实测:免费识图能力 + 8 大场景体验

DeepSeek 发布实验性视觉模型 DeepSeek-V4-Flash-Vision-Exp,在 V4 Flash 基础上增加识图能力且价格不变。作者通过 DeepSeek Harness 接入该模型,完成了 OCR 识别、人物识别、iPhone 机型辨别、找不同、图片转 ASCII、报错修复、前端页面复刻、数据报表逻辑分析共 8 项测试。结果显示其 OCR 和找不同表现优秀,但人物识别、机型辨别和页面复刻存在明显失误。整体可用且性价比极高,一张图约 0.12 分钱,八轮测试仅花约 6 元,而同等测试用 Opus 5 需约 8 美元。这是 DeepSeek 迈向原生多模态的重要一步。

技术 › LLM 程序员鱼皮 2026-08-2512.6 KB 11.7K 25 73

2026年AI订阅性价比终极对比:Claude/Codex/Grok/DeepSeek/GLM/OpenCode Go哪家最划算

因DeepSeek官方API涨价,作者对比了2026年主流AI订阅套餐的性价比。结论:34元人民币的OpenCode Go订阅最划算,可0.33倍率用DeepSeek、0.083倍率用Muse Spark 1.2;30美元档推荐SuperGrok、GPT Plus和GLM Lite;200美元档推荐Claude Max和GPT Pro;300美元档推荐SuperHeavy。文章还详细列出各套餐的坑点,如Claude易封号建议通过苹果商店购买、Grok节点不干净会降智、GLM限购且速度慢等,并附AI模型智力排行榜。

技术 › Openclaw 峰哥亡命天涯 2026-08-213.5 KB 32.9K 43 70

PI > ClaudeCode/Codex?

本文对比分析了开源命令行编程工具 Pi 与 Claude Code、Codex 的性能。Databricks 的评测显示,Pi 在真实代码库上的 token 消耗显著更低,性价比极高,甚至压过了官方工具。文章探讨了 Pi 高性价比的原因,如精简的系统提示词,并指出了其在高强度思考下的局限性及功能缺失。

技术 › Agent Ren 2026-07-2615.9 KB 26.9K 160

DeepSeek V4 从入门到进阶,这一篇就够了

本文是一份 DeepSeek V4 的使用指南。文章指出大多数人未解锁 V4 的真正潜力,介绍了快速与专家两种模式的区别,重点解读了 100 万 token 上下文窗口的价值。作者提供了工作汇报、学习概念、辅助决策的提示词模板,并深度解析了“深度思考”与“智能搜索”的开启场景。此外,文章还对比了 API 型号与成本,强调了 V4-Pro 在 Agent 自动化领域的开源领先地位及其性价比优势。

技术 › LLM 诺鸭船长3 2026-05-036.9 KB 14K 76 79

DeepSeek V4 开源发布:行业威胁与地缘政治博弈

文章分析了 DeepSeek V4 的发布及其对美国 AI 主导地位的挑战。作为一款性能逼近 GPT-5.5 和 Opus 4.7 但价格极低的 MoE 开源模型,它打破了现有的商业逻辑。作者认为,虽然该模型并非完全超越前沿水平,但其极致性价比可能导致美国企业大规模转向采用,从而引发严重的地缘政治安全风险。同时,文章讨论了出口管制、蒸馏指控及文化叙事控制等深层影响,呼吁美国加强开源策略并降低模型成本。

技术 › LLM Matthew Berman 2026-04-2510.1 KB 756K 969 62