推特起号保姆级图文教程:10步从小白到起步
作者用 Grok Bot 分析了 70 篇中文圈的推特涨粉经验帖,整理出适合新手的 10 步起号指南。核心公式是“涨粉 = 曝光 × 关注转化率”。文章涵盖主页装修(头像、昵称、四要素简介)、定位方法(三圈交集)、开蓝V、写起号帖、借力冷启动、算法机制拆解、内容创作技巧、发文节奏、封号红线及变现路径(创作者收益、商单、联盟推广),并附新手 30 天行动清单,强调前 500 粉只管内容、稳定发帖和保持人味。
作者用 Grok Bot 分析了 70 篇中文圈的推特涨粉经验帖,整理出适合新手的 10 步起号指南。核心公式是“涨粉 = 曝光 × 关注转化率”。文章涵盖主页装修(头像、昵称、四要素简介)、定位方法(三圈交集)、开蓝V、写起号帖、借力冷启动、算法机制拆解、内容创作技巧、发文节奏、封号红线及变现路径(创作者收益、商单、联盟推广),并附新手 30 天行动清单,强调前 500 粉只管内容、稳定发帖和保持人味。
作者分享了自己从 7 月开始运营 X 的实战经验:3 个多月发帖 4854 条,总曝光 560 万、点赞 2.7 万。文章首先对比了 X 与小红书、抖音等国内平台的差异:X 是文字信息流平台,算法最看重互动(回复、引用、转发),创作成本低。接着讲解 X 算法奖励的三件事:写引发讨论的内容、认真回复评论、写值得转发的内容。冷启动可借助大 V 转发但应避免互关互刷。内容方面强调多发试错、选题决定流量上限、把个人经历转化为方法。最后介绍了蓝 V 会员档位及原创内容奖励计划的申请条件,指出增长是指数级的,鼓励读者从今天发出第一条帖子。
本文解析一道 Anthropic 真实面试题:如何从 profiler 采样快照还原函数调用事件。全文分三部分:Part 1 将采样序列转换为 start/end 事件,核心是通过 LCP 对比相邻栈,end 从内到外、start 从外到外,frame 身份为 (depth, name);Part 2 处理流式输入与去噪(debounce),只保留 O(depth) 状态,frame 身份沿 LCP 链追踪而非看名字;Part 3 用反转后缀 trie 实现崩溃 trace 的尾部匹配归因。文末附完整参考代码与备考清单,强调事件顺序的语义正确性是面试考察重点。
文章总结了单调队列的核心模版:队列存下标并保持单调性,通过'过期踢队首、单调踢队尾、队首即答案'三步解决滑动窗口最值问题。作者用一套通用 Python 模版讲解了五道 LeetCode 题目:滑动窗口最大值(239)、跳跃游戏 VI(1696,dp 套模版)、带限制的子序列和(1425)、和至少为 K 的最短子数组(862,前缀和+递增队列)、绝对差不超过限制的最长子数组(1438,双队列维护最大最小值),帮助读者快速掌握单调队列这一 O(n) 高效算法技巧。
作者通过其自主研发的铁路钢轨伤损自动识别系统,阐述AI时代软件的护城河在于对所构建系统的深刻理解,而不仅是功能复制。其系统采用116维支持向量机,每个维度都有真实物理含义,第三方盲测准确率高达99.985%,远超中车、铁科院及Sperry Rail等竞争对手。文章以x−y方差这一维度为例,详细解释了超声波探伤中波长、角度与单位换算背后的物理原理,说明即使拿到源码,对手也无法理解参数背后的含义。作者指出,正是数十年深入现场的独家研究构成了无法被AI抄袭的核心壁垒。
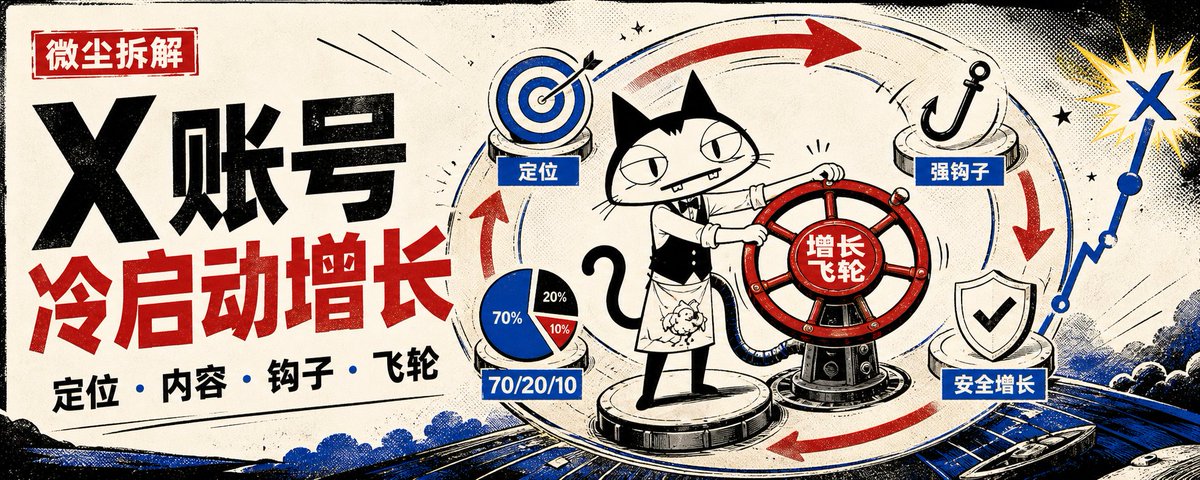
本文整理自微尘的 YouTube 直播,系统讲解了 X 账号冷启动的增长方法论:包括账号定位与 Bio 装修细节、70/20/10 内容配比法则、推文钩子的三段式结构与四种高转化类型、折叠线以上的排版铁律、每日发帖节奏与晚间转推放大技巧、引用他人内容的正确姿势、回复蹭流量的安全边界、置顶贴的内容地图策略、插件辅助涨粉的安全策略,以及从书籍中挖掘经过流量验证的选题方法。核心逻辑是让算法打标签、让读者记住你、提升收藏数据,形成正反馈飞轮。
作者运营着拥有7万+创作者的剪辑分发业务,总结了应用通过自然短视频流量增长至六位数MRR的方法。核心观点:开发已非瓶颈,分发才是关键。自然流量CPM远低于付费广告且能持续复利。方法论包括:让产品自带可展示的瞬间;先小规模测试找到可复制的爆款格式(幻灯片、UGC、录屏等);验证格式后大规模复制、砍掉无效内容并加倍投入有效内容。
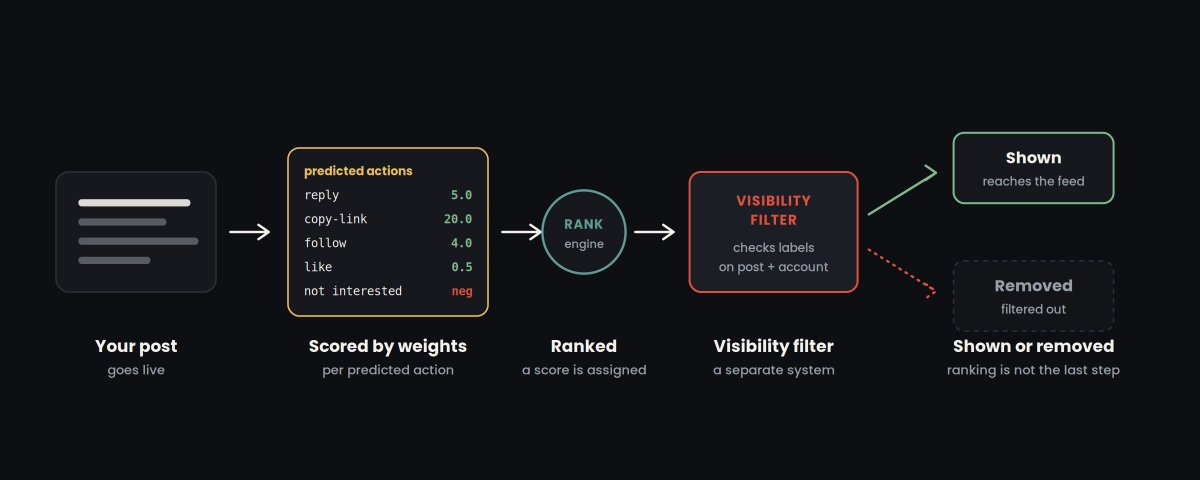
作者 Mubbu 基于 51,888 条内容的运营经验,解读 X 平台最新公布的推荐算法。文章指出:算法基于预测用户行为加权(回复、引用、私信分享权重远高于点赞),负面信号(不感兴趣、拉黑等)影响很大;新工具 Under the Hood 可查看账号的可见性限制标签;外链并非必死,同作者多条帖子会互相降权,站外内容被打 0.75 折扣。作者建议建立每周数据优化循环,明确垂直定位,让兴趣图谱匹配更精准,而非追求永久的算法技巧。
本文作者认为,尽管短视频和小红书等平台盛行,公众号依然值得每个人尝试,尤其是那些有工作、手艺或经验的人。文章详细阐述了公众号的三大优势:推荐流量、旧内容可被搜索和反复阅读、以及信任变现。作者强调,AI工具降低了写作门槛,但许多人因赛道选择错误、不懂算法分发或人为干预流量而失败。文章提供了从选赛道、起号四阶段、理解流量池机制、开通流量主到避免致命错误的完整实操指南,并给出了一套可立即执行的起号流程。
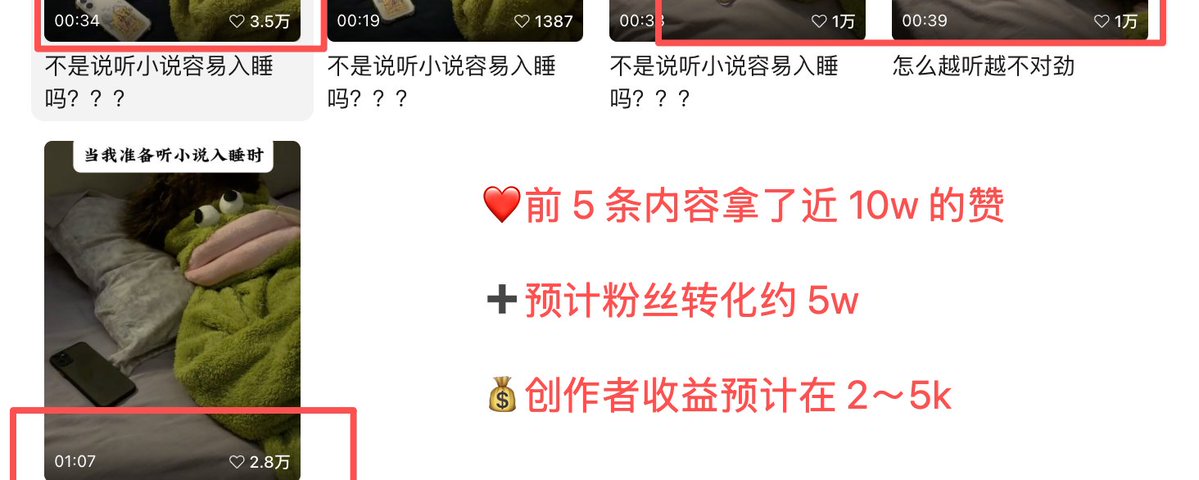
本文拆解一个低成本自媒体账号案例:博主仅用30元的悲伤蛙玩偶服加假发,拍摄玩偶听小说的搞笑视频,5条视频收获近10万赞、涨粉5万+。其成功逻辑在于:用丑萌玩偶打造统一视觉锚点,以反差型标题拉高完播率,在视频高潮处截断引发观众追问书名。变现核心是小说推文佣金:在评论区置顶搜索暗号,引导用户去番茄、七猫等平台充值,每单佣金8-12元,单条爆款视频可变现近万元。文末附保姆级五步实操SOP。
作者指出大多数创始人从未在 LinkedIn 上真正做过产品发布,而平台上聚集了完整的潜在买家名单。文章以 AI 外呼工具 Leadpoet 的发布为例(视频约 100 万浏览、150+ 预约通话、六位数管道收入),系统讲解 LinkedIn 发布的完整流程:准备一页定位文档、原生上传演示视频、用评论式 CTA 代替外链以驱动算法飞轮、由创始人账号发布、选择工作日早晨上线,并提前协调创作者在最初 1-2 小时集中互动。强调发布频率、清晰定位和真实立场比精良制作更重要。
本文作者通过分析X平台新公开的推荐算法,总结了提高内容推荐量的关键策略。文章指出,新算法更看重内容的复制链接、引用和回复等深度互动信号,而非单纯的点赞。作者提出了两类高权重内容:一是具有“带走价值”的干货,如清单、框架、步骤等,容易被复制链接分享;二是具有鲜明观点和讨论空间的内容,容易被引用。文章还提供了一份发帖前的自查清单,帮助创作者优化内容,使其在脱离原始时间线后依然具有独立价值。
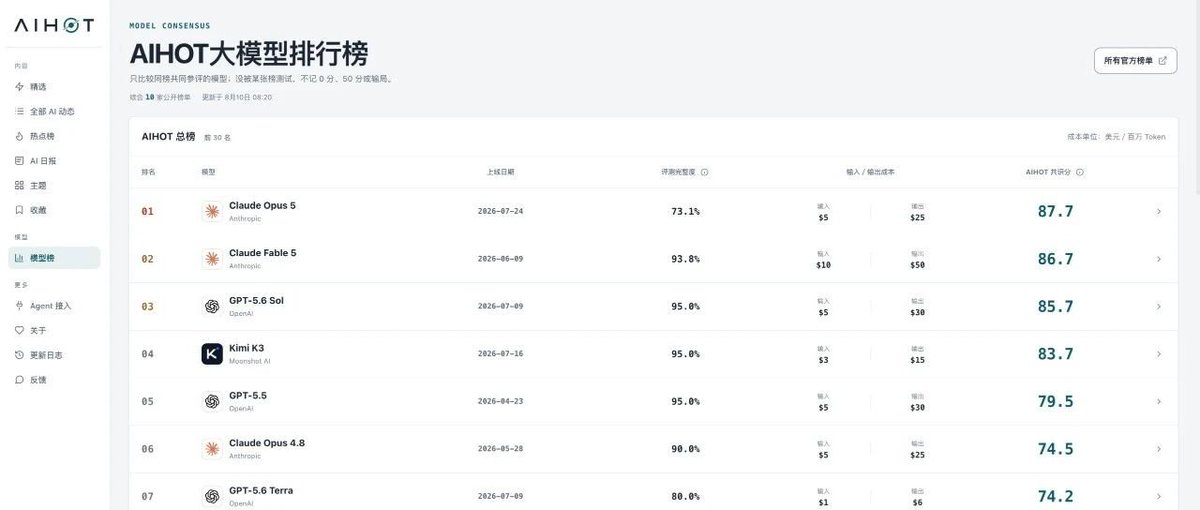
作者耗时54小时开发了一个全新的AI大模型聚合排行榜。为解决现有榜单数据缺失、样本量和标准不一的问题,作者参考电竞和统计学算法,自研了名为LatentRank的评分系统,通过模型间的成对比较来推算综合能力。目前该榜单已集成10个主流评测源,免费开放供用户查看和对比。
文章探讨了在产品开发日益容易的当下,分发和销售成为关键瓶颈。作者详细分析了X(Twitter)和YouTube两大渠道的运营策略,包括主页设置、细分领域选择、算法机制及从0到1的增长技巧,强调内容价值与外部助推的重要性,并指出高价值细分领域的变现潜力。
本文深入解析了HNSW(分层可导航小世界)算法,这是现代向量数据库实现快速近似最近邻搜索的核心技术。文章通过邮政分拣的比喻,阐述了HNSW如何结合NSW图结构和跳表的概念,利用分层结构从粗糙到精细地快速定位目标,并详细说明了向量搜索和插入的具体流程。
作者分享了通过180亿次浏览量总结的病毒式传播秘诀。文章指出流量并非随机,而是基于算法机制的工程化结果。核心包括:制造能力差距的钩子、高信息密度的视觉节奏以及完美的循环结构。此外,还介绍了四种内容框架和大规模的分发策略,强调一切皆在数据之中。
文章以梅西形象反转为例,分析了社交媒体如何通过算法推荐、虚假信息传播及付费营销操纵舆论。作者指出,随着AI生成内容的泛滥,这种重塑公众认知的效率将大幅提升,对政治、商业等领域构成严峻挑战。
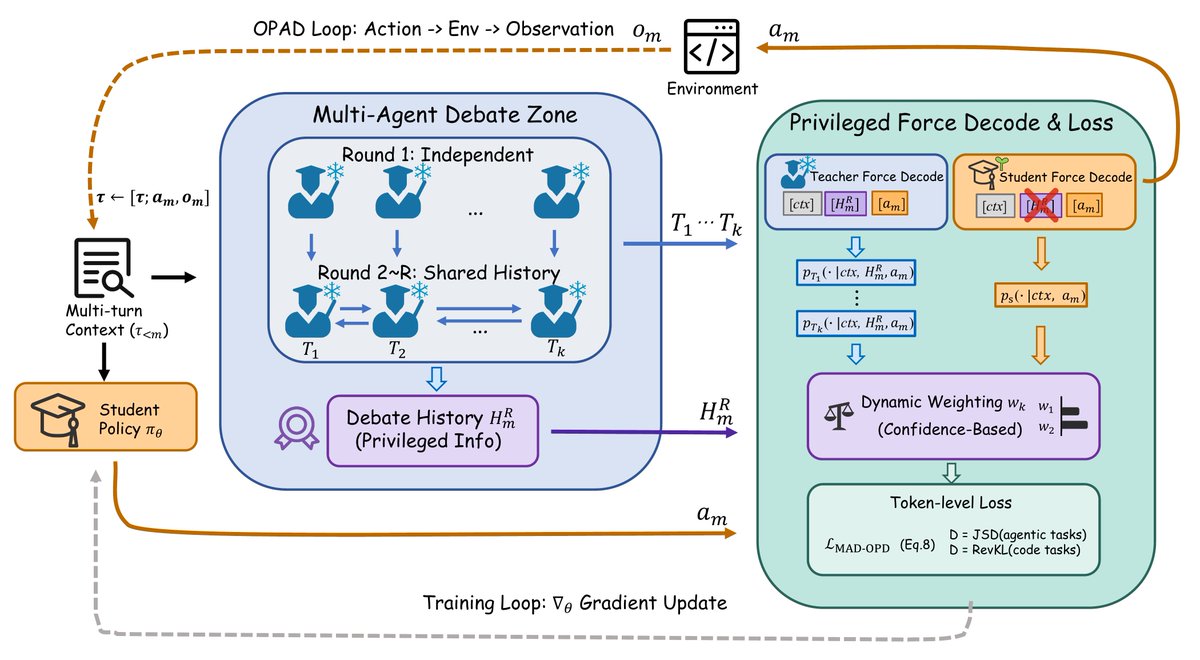
文章介绍了一种名为 MAD-OPD 的新算法,旨在解决 OPD(On-Policy Distillation)中单教师模型存在盲点导致学生模型学习受限的问题。通过引入多智能体辩论机制,让多个教师围绕学生状态互相纠错并达成共识,再进行蒸馏。实验表明,该方法在 14B+8B 到 4B 的蒸馏任务中,不仅提升了代码生成能力,还在 Agentic 任务中实现了小模型反超大教师的突破。
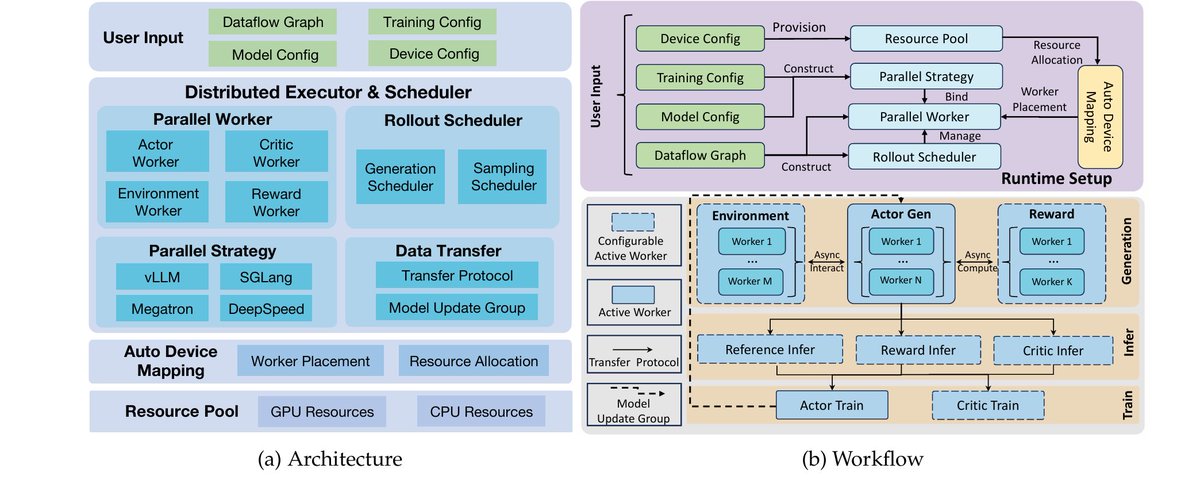
本文汇总了35道2026年强化学习(RL)领域的面试核心问题。内容涵盖算法与基础设施两大方向,既包括PPO、GRPO等训练机制的原理探讨,也涉及分布式推理、显存优化等工程落地细节。作者强调现代RL岗位需要具备全栈理解能力,建议面试者不仅要熟记问题,更需深究背后的技术逻辑。
本文作者分享了其小红书账号遭遇限流后,通过逆向工程思维进行排查与修复的经历。作者将限流视为系统故障,经过14天的调整,成功将首页推荐占比恢复至56.5%。文章提出了5条反共识观点:精准诊断降权类型、停发优于改内容、隐藏优于删除、重视CES互动权重以及将账号视为可维护系统,并附带了详细的14天恢复SOP清单。
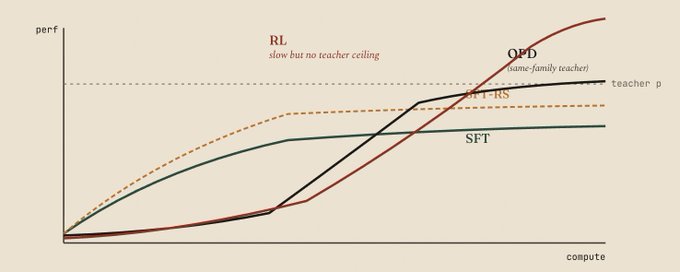
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。
Atlassian 首席工程师总结的后端面试与系统设计中的 20 个并发编程核心概念。文章涵盖了从基础的并发与并行、进程线程区别,到互斥锁、信号量、死锁、CAS、线程池及生产者-消费者模式等进阶主题。旨在帮助工程师掌握并发原语,理解性能权衡,从而构建可靠的生产级系统。
本文探讨了递归语言模型作为一种新的推理范式的重要性。RLM 通过将模型自己的提示视为可检查、切片和递归查询的环境,直接结合了推理和工具使用。文章回顾了推理和工具使用的历史发展,从思维链到 ReAct,再到 OpenAI o1 和 Claude 的工具使用。最新研究显示,RLM 在长上下文、记忆和长推理任务中表现出色,克服了传统单次前向传播的局限。
本文展示了如何在没有任何高级库的情况下,仅使用 x86-64 汇编语言从零构建一个微型的神经网络来解决 XOR 问题。作者详细讲解了数据内存布局、前向传播、基于 x87 FPU 实现的 Sigmoid 激活函数、损失计算、手动求导的反向传播算法以及权重更新的汇编代码实现。
文章探讨了知识图谱性能优化的核心技术,指出海量数据下的查询瓶颈在于算法而非数据本身。文中深入讲解了三大索引策略(六重索引、位图索引、邻接表压缩)以及四种关键的图遍历算法(BFS、DFS、Dijkstra、A*),并分析了其适用场景与计算复杂度。