Wiki 知识库

全部文档 / 标签: 数据工程

8 篇
清除

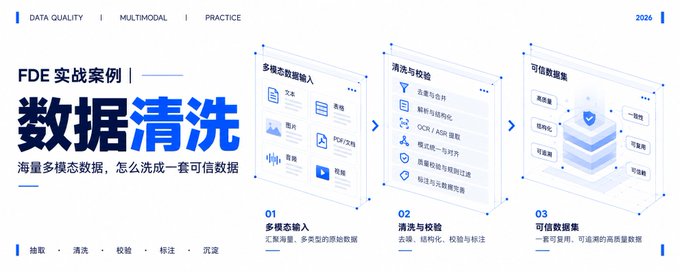
FDE 实战案例:海量多模态数据清洗成可信数据的八步方法

作者以美妆企业 FDE 落地项目为例,讲解如何将小红书、抖音、视频号、微博等平台采集的多模态数据(文字、图片、音频、视频)清洗成一套可信、可查询的结构化数据。文章提出八步通用链路:定数据规范、保留原始内容、梳理用户/帖子/评论关系、多模态归一处理、冲突与质量清洗(含证据分级)、生成结构化数据、执行验收、按规则和版本入库。文中还给出 OCR/ASR 工具选型建议(FFmpeg、PaddleOCR、Whisper 等)以及大模型结构化输出的实践经验。

技术 › 后端 Miles Ma 2026-10-2712.9 KB 5.8K 61 86

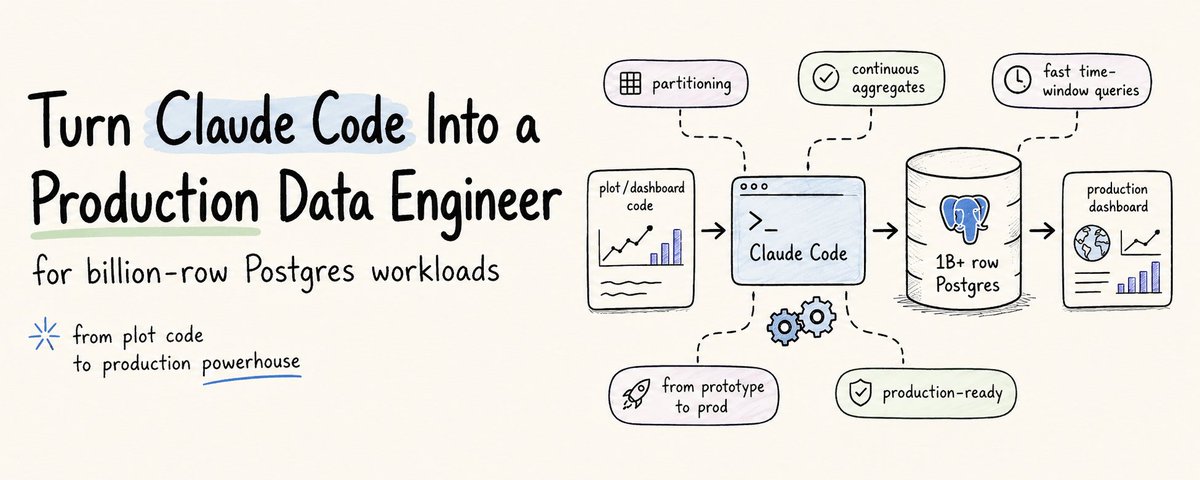
How To Turn Claude Code Into A Production Data Engineer On Billion-row Postgres Workloads

本文探讨了Postgres在处理数十亿行时间序列数据时遇到的性能瓶颈,以及如何通过Tiger Cloud(基于TimescaleDB的托管服务)解决这些问题。文章以Cloudflare团队的经历为例,展示了他们花费两年时间手动构建分区管理和聚合管道,最终迁移到TimescaleDB将查询速度提升35倍。作者演示了如何使用Tiger CLI作为MCP服务器,让Claude Code直接管理数据库基础设施,并构建了一个实时地震仪表盘。通过自动时间分区、连续聚合和压缩功能,Tiger Cloud简化了数据工程工作,使开发者能专注于应用开发。

技术 › 数据库 Avi Chawla 2026-08-129.1 KB 70.5K 49 71

How we built our knowledge base

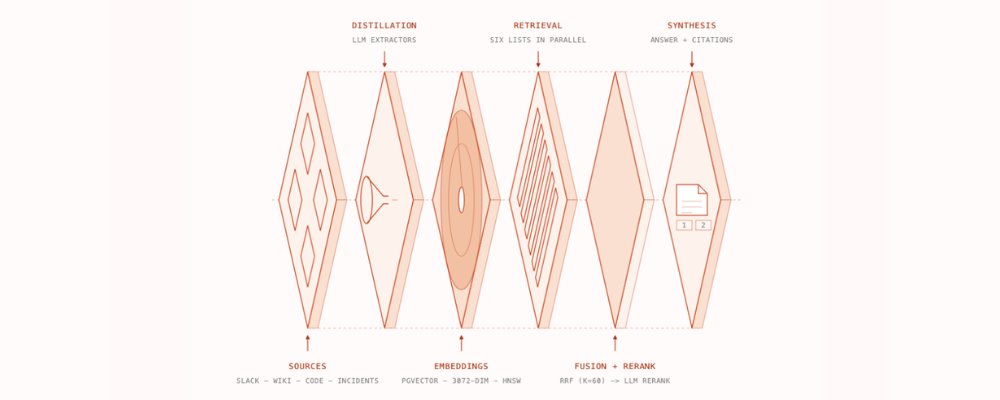
Cerebras 分享了构建其内部知识库的经验。该知识库每天处理超过 15,000 个问题,集成了 Slack、GitHub 等多种数据源。文章详细介绍了如何通过 Postgres 存储 embeddings,并采用混合搜索策略(全文搜索、向量搜索、IDF 加权、时间衰减)来高效检索非结构化对话数据,解决了信息分散和匹配精度的问题。

技术 › DevOps Cerebras 2026-07-18311.2 KB 3.6M 5.6K

Anthropic 如何通过 Claude 实现自动化商业分析

Anthropic 分享了如何利用 Claude 将数据分析准确率从 21% 提升至 95%,并自动完成 95% 的业务查询。文章详细介绍了其构建的四层智能体分析栈:数据基础、权威来源、技能(Skills)和验证机制。通过规范数据集、强制语义层使用、编写 Markdown 技能文件以及严格的离线与线上评估,Anthropic 解决了概念歧义、数据过时和信息检索困难三大问题,成功将重复性分析工作交给 AI,让数据科学家专注于高价值建模。

技术 › Agent 小互 2026-06-0527.4 KB 22.5K 111 93

Adam's Law:为何高频表达能解锁 LLM 的最强性能

文章介绍了 FaceMind 团队提出的 Adam's Law(文本频率定律),即在语义不变前提下,使用预训练语料中频率更高的表达方式能显著提升 LLM 表现。该发现通过 100 种语言和四大核心任务得到验证,并指出当前数据工程忽视了“频率”这一关键维度。Anthropic 的 Claude Opus 4.7 更新间接验证了这一理论。

技术 › LLM Berryxia.AI 2026-05-3018.7 KB 21.3K 57 89

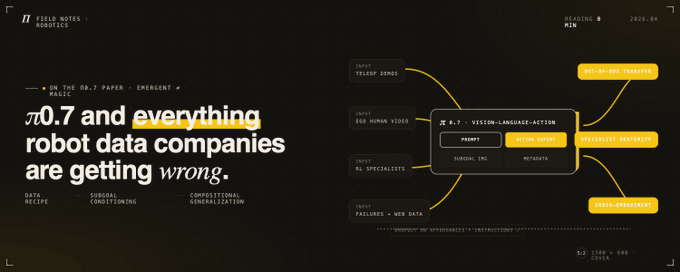
π0.7 与机器人数据公司的误区

文章批评了仅靠堆砌人类数据解决机器人问题的观点,深度解析了 Physical Intelligence 的 π0.7 论文。π0.7 通过拒绝仿真数据、利用子目标图像作为引导(Affordances)、以及增加详细的任务元数据(如子目标、子任务指令)来解决数据冲突,实现了跨具身迁移和更好的指令遵循。作者指出,机器人数据公司应通过自建机器人并提供高质量注释来创造价值,而非单纯销售原始数据。

技术 › Agent Shreyas Gite 2026-04-2210.1 KB 61.1K 246 79

系统工程:构建有效的智能体软件

文章提出构建智能体软件应采用系统工程思维,而非仅优化局部组件。作者提出了软件工程的五个关键层面:代理工程、数据工程、安全工程、接口工程和基础设施工程。文章通过开源项目 Dash 演示了如何将 RBAC、数据隔离和多接口集成等原则应用于实际开发中,强调智能体本质仍是软件,需遵循经典的系统设计原则。

技术 › Agent Ashpreet Bedi 2026-04-089.4 KB 145.8K 983 88

你不知道的大模型训练:原理、路径与新实践

本文深入探讨了大模型训练的全链路流程,指出2026年模型效果的差距主要源于后训练阶段。文章从预训练底座、数据配方、系统架构约束、后训练(SFT/RLHF/DPO)以及 Eval/Reward 机制五个维度,解析了如何通过工程化手段提升模型实际落地效果,并引用了 DeepSeek、Llama 等实例。

技术 › LLM Tw93 2026-04-0333.6 KB 650.9K 86