RAG架构详解:检索、增强与生成
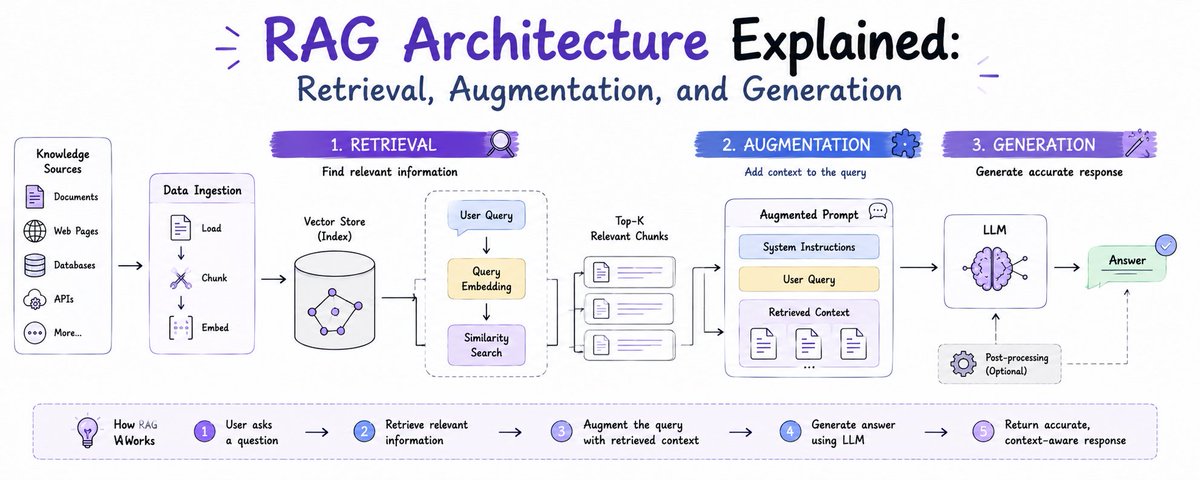
本文深入解析了生产级RAG(检索增强生成)系统的完整架构。文章首先指出LLM的局限性——无法访问私有数据,而RAG通过外部知识检索来弥补这一缺陷。然后详细介绍了系统的两大核心平面:知识平面(离线索引)和运行时平面(在线问答)。知识平面涵盖数据源、解析-分块-嵌入流水线以及向量索引;运行时平面则描述了用户查询、检索重排、LLM生成和答案引用的完整流程。文章还逐步拆解了查询生命周期,包括查询嵌入、Top-K检索、重排增强和生成,并强调了监控指标的重要性。
本文深入解析了生产级RAG(检索增强生成)系统的完整架构。文章首先指出LLM的局限性——无法访问私有数据,而RAG通过外部知识检索来弥补这一缺陷。然后详细介绍了系统的两大核心平面:知识平面(离线索引)和运行时平面(在线问答)。知识平面涵盖数据源、解析-分块-嵌入流水线以及向量索引;运行时平面则描述了用户查询、检索重排、LLM生成和答案引用的完整流程。文章还逐步拆解了查询生命周期,包括查询嵌入、Top-K检索、重排增强和生成,并强调了监控指标的重要性。
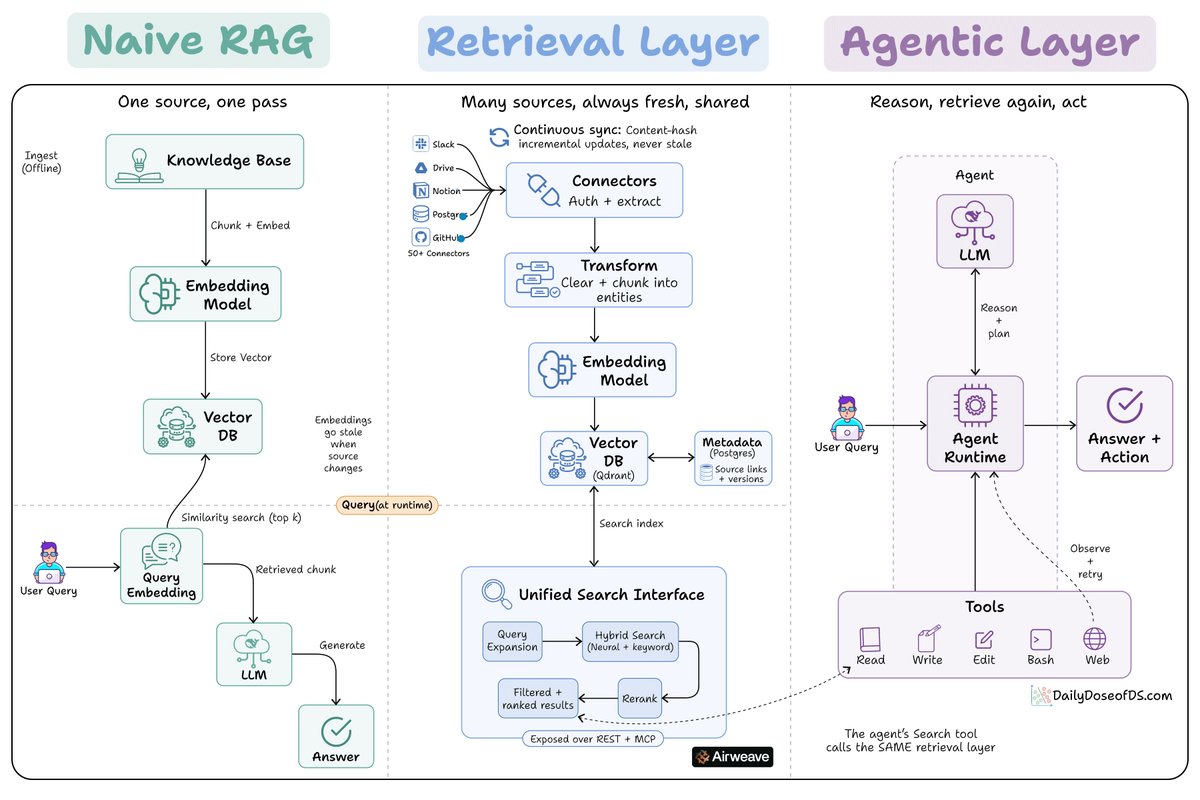
文章讨论了Google和Anthropic将检索从单一应用中移出,转变为独立服务的新趋势。这种分离解决了旧RAG设置中的过时嵌入和基础设施耦合问题。通过将摄取与查询分离,并使用结构化单元代替原始文本块,可以显著减少语料库大小并提高向量相关性。
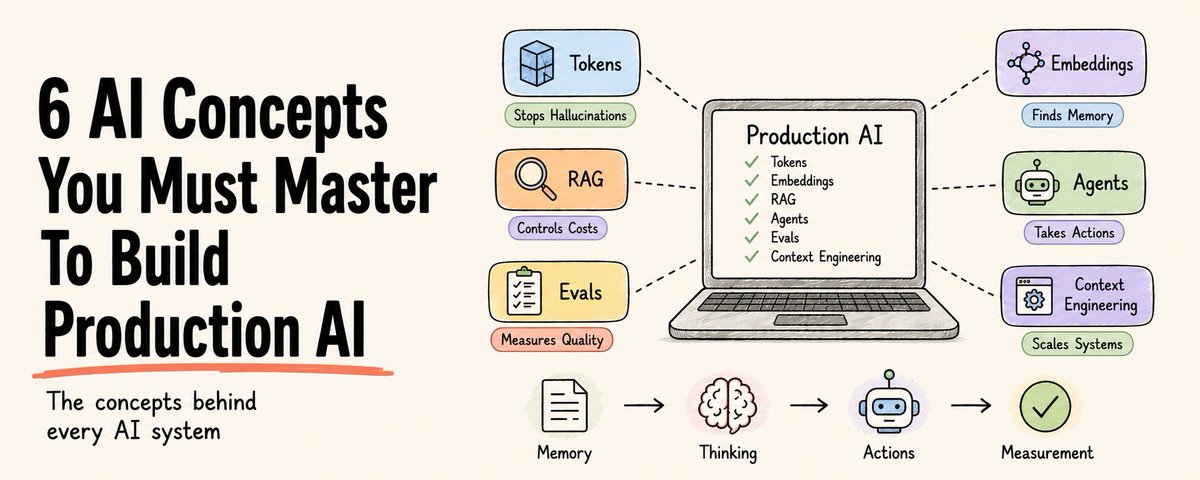
本文由作者因遭遇 AI 智能体失控产生高昂费用的经历引出,旨在阐述构建生产级 AI 系统必须掌握的核心概念。文章提出了 AI 系统的通用公式:记忆(RAG)+ 思考(LLM + Tokens)+ 行动(Agents)+ 测量(Evals)。文中重点解析了 Tokens 与上下文窗口的成本与限制、嵌入向量与语义搜索的原理、RAG 检索增强生成的正确姿势、智能体循环中的工具使用与停止条件等关键技术细节,帮助开发者从“调参侠”进阶为真正的 AI 工程师。