Wiki 知识库

全部文档 / 标签: 检索

7 篇
清除

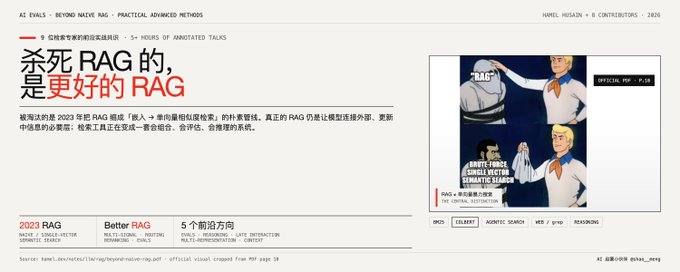
杀死 2023 RAG 的,是更好的 RAG:9 位检索专家的前沿实战共识「Beyond Naive RAG」

本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。

技术 › LLM meng shao 2026-10-1211.9 KB 4.7K 43 84

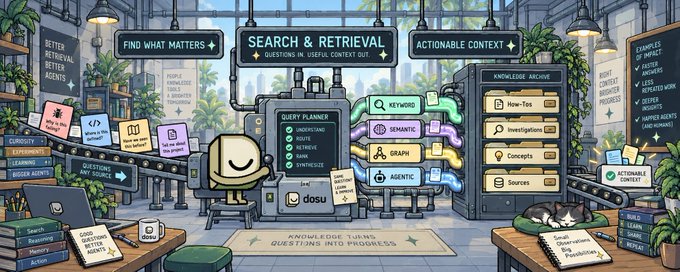
How to Build Agent Memory: Search & Retrieval

本文是构建 Agent 记忆系统系列的第四篇,聚焦读取路径:如何检索已保存的知识并加以利用。文章首先强调根据问题类型选择检索方式——精确查找、相似案例识别或项目概览各有不同需求。接着对比了四种搜索方法:关键词匹配、语义搜索、图遍历和 Agentic 检索,指出 Agentic 检索能综合运用其他方法并随信息获取调整调查策略。文章还强调检索结果应具备可操作性,一条包含复现步骤和验证方式的笔记远比泛泛的描述更有价值。最后提醒要注重精确度,避免给 Agent 返回过多无关信息造成干扰,因为它可能将小问题扩大成大改动。

技术 › Agent Devin Stein 2026-09-1512.0 KB 6.2K 105 82

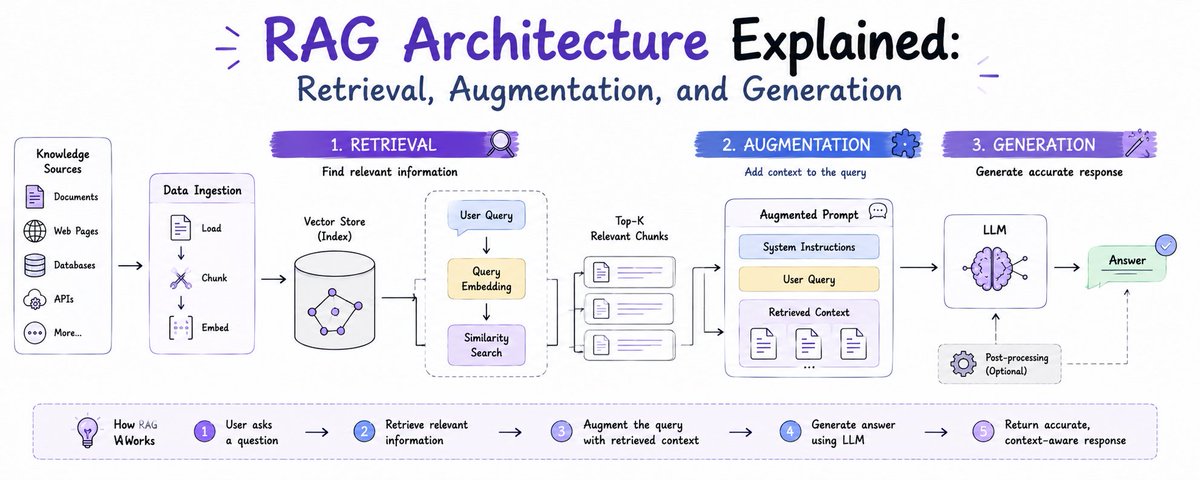
RAG架构详解:检索、增强与生成

本文深入解析了生产级RAG(检索增强生成)系统的完整架构。文章首先指出LLM的局限性——无法访问私有数据,而RAG通过外部知识检索来弥补这一缺陷。然后详细介绍了系统的两大核心平面:知识平面(离线索引)和运行时平面(在线问答)。知识平面涵盖数据源、解析-分块-嵌入流水线以及向量索引;运行时平面则描述了用户查询、检索重排、LLM生成和答案引用的完整流程。文章还逐步拆解了查询生命周期,包括查询嵌入、Top-K检索、重排增强和生成,并强调了监控指标的重要性。

技术 › LLM Vikas gupta 2026-08-2020.4 KB 260.7K 69 73

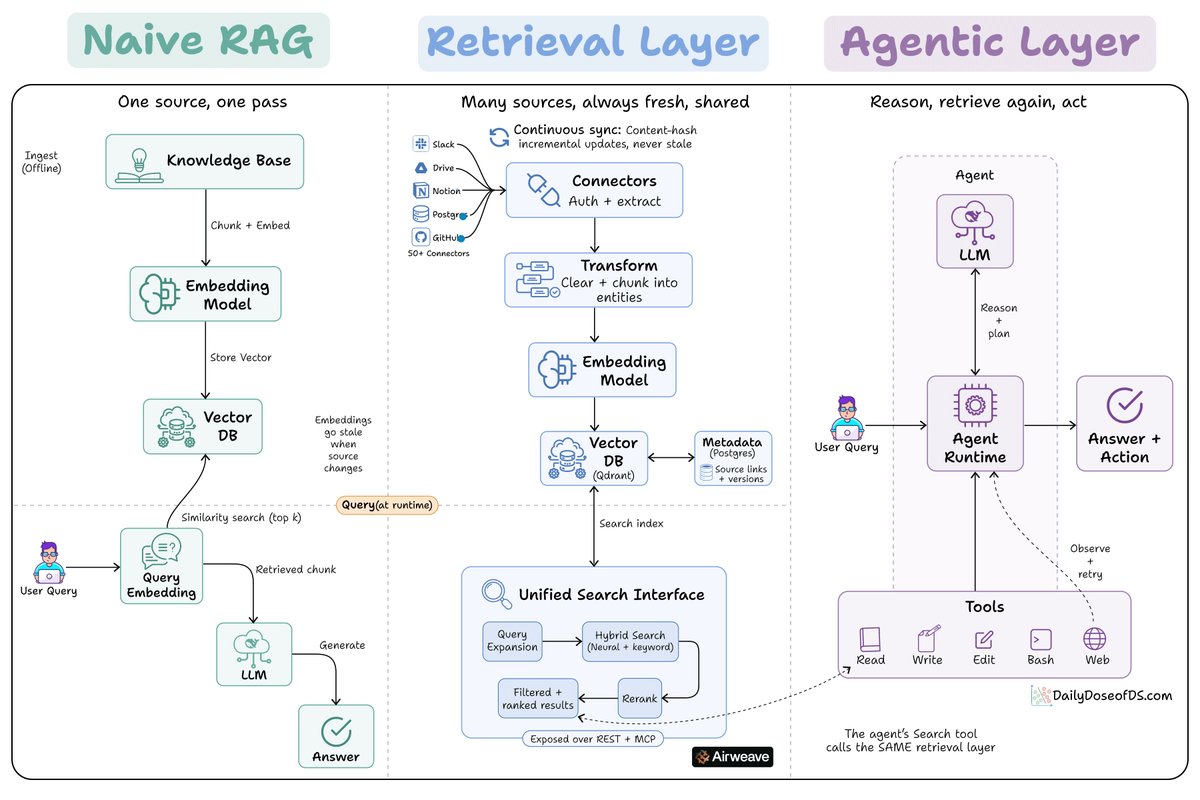
Google和Anthropic对检索的共识:从单一应用到独立服务

文章讨论了Google和Anthropic将检索从单一应用中移出,转变为独立服务的新趋势。这种分离解决了旧RAG设置中的过时嵌入和基础设施耦合问题。通过将摄取与查询分离,并使用结构化单元代替原始文本块,可以显著减少语料库大小并提高向量相关性。

技术 › LLM Akshay 2026-08-022.9 KB

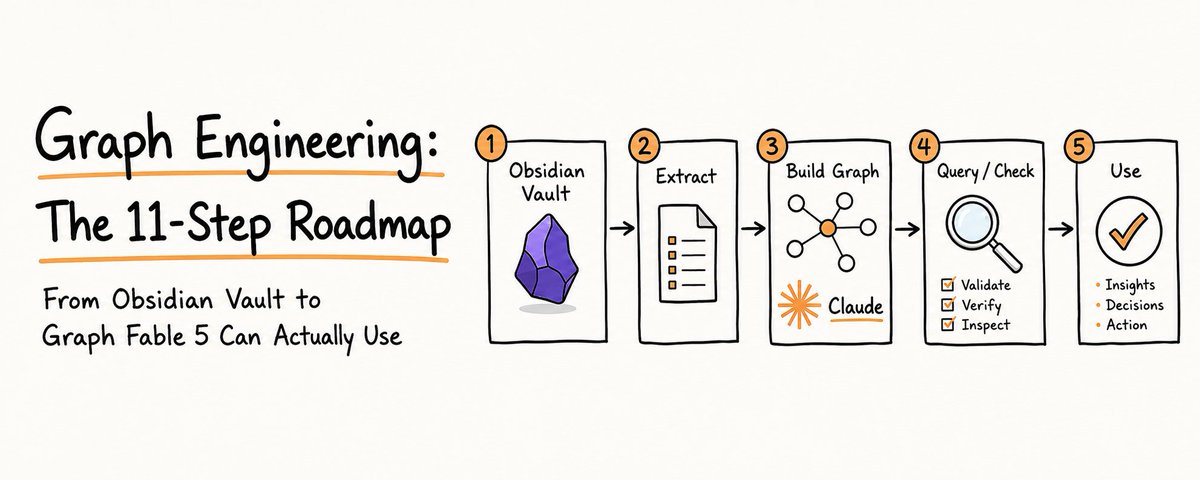
Graph Engineering: The 11-Step Roadmap From Obsidian Vault to Graph

文章指出仅使用 Obsidian 构建笔记库效率低下,AI 读取所有笔记导致成本高昂且速度慢。作者提出了 11 步图谱工程路线图,通过构建路由、索引、节点和边,将“杂乱的文件堆”转化为结构化的知识图谱。这种方法将检索过程从模型调用转变为逻辑匹配,大幅降低 Token 消耗并提升响应速度,实现真正的“第二大脑”。

技术 › 工具与效率 unicode 2026-07-259.8 KB 813.5K 378

BestBlogs 早报 · 07-17|Bun 借 AI 重写、Hook 堵越权、Nemotron 登顶检索

本期早报聚焦 AI 工程落地,精讲 Bun 用 64 个智能体 11 天重写 53.5 万行代码、腾讯 DECO 用 Hook 治理 LLM 偷懒越权、NVIDIA Nemotron 登顶检索榜。此外涵盖 Kimi K3、Inkling 模型、全双工语音等速览,强调竞争焦点从模型参数向工程实践迁移。

技术 › Harness Engineering ginobefun 2026-07-1723.8 KB 6.8K 2

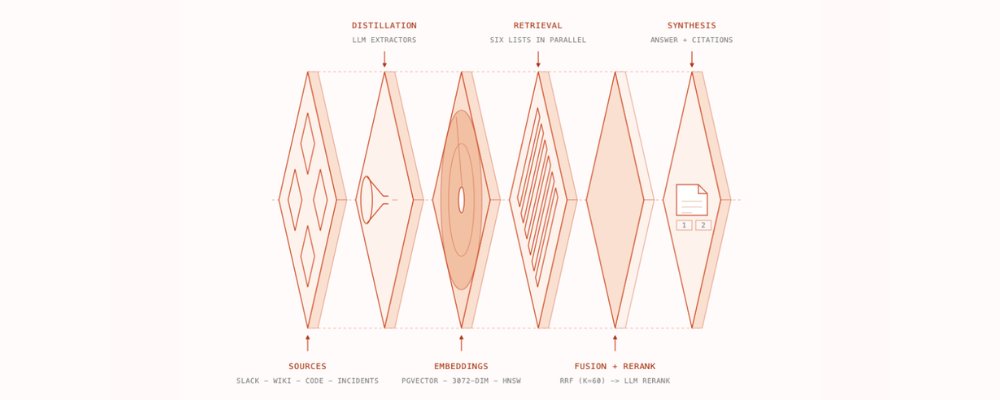
How we built our knowledge base

Cerebras 分享了如何构建内部知识库,该系统每天处理超过 15,000 个查询。文章介绍了其数据采集架构,特别是如何通过混合搜索技术(全文搜索、Embedding 搜索、IDF 和时间衰减)来处理非结构化的 Slack 对话,以提高信息检索的准确性和实时性。

技术 › 后端 Cerebras 2026-07-17261.6 KB