Wiki 知识库

全部文档 / 标签: GLM

16 篇
清除

实测Today,国内首个原生Personal Agent免费送3亿Tokens

作者实测了国内首个原生Personal Agent产品Today,该产品获得腾讯和蚂蚁集团投资的2亿美元融资,新用户注册可获3亿token和3个月Pro会员。文章详细介绍了Today的下载安装、设置页面的模型(内置DeepSeek V4.1 Flash和GLM 5.3)、应用连接、设备连接、Skill技能等功能,并演示了改名、任务创建、记忆构建、做梦写日记与灵感等特色功能。作者强调Personal Agent的好用性在于给足上下文,让AI主动理解用户、安排任务,是AI从被动执行走向主动服务的关键。

技术 › Agent 马佳彬 2026-10-237.4 KB 1.4K 3 73

REA逆向工程保姆教程

作者分享了一份利用 Opencode 搭配免费 GLM-5.3-Flash 模型进行 REA 逆向工程的教程。步骤包括安装 Opencode、使用特定提示词,即可让模型执行逆向任务,且不封号、不拒绝。评论区讨论了 APK 脱壳需消耗大量算力、pi 和 deepseek 模型同样可行、frida 内存钩子在免费模型上的实际效果,以及与 IDA MCP+AI 方案的对比。作者提醒提示词可能很快失效,建议尽快尝试,并根据具体项目自定义验收标准。

技术 › 网络安全 拓跋鼠 (@qwerty__cs) 2026-10-172.8 KB 47

把 96.5GB 的 GLM-5.3-Flash 塞进单张 4090 48GB,跑出 41.8 token/s

本文记录了在单张魔改 RTX 4090 48GB 上,通过系统级调优将 96.5GB 的 MoE 模型 GLM-5.3-Flash 推理提速至 41.8 token/s 的完整工程实录。作者采用混合 i-quant 量化,将 12,096 个专家常驻显存与锁页内存,通过实测发现减少 CPU 线程反而提升 42% 速度、扩大显存池至 46GB 带来质变、以及激进的 PCIe 搬运策略是致命代偿陷阱。文章逐毫秒拆解了 24.47ms 的 token 耗时去向,指出 PCIe 搬运是硬瓶颈,并对比了更稀疏的 Qwen3.8-Flash-Next 架构可达 120 tok/s 的原因。

技术 › LLM huangserva 2026-10-1217.6 KB 9.3K 57 89

把 GLM-5.3-Flash 变成一个 Jev 式的 System One 模型

本文介绍一种无需微调的方法,把现成的 LLM(GLM-5.3-Flash)变成类似 Jev 的专用决策模型(System One 模型)。核心做法是给选项编号、预填答案、通过读取选项索引上的概率分布,让模型在一次前向传播中给出类型化决策及其置信度。文章详细说明了 vLLM 部署中的三个实现细节(allowed_token_ids、logprob_token_ids、tokenizer 分词),并在 29 个公开数据集上与 Jev、Laya 进行基准对比:文本决策准确性与 Jev 相当,延迟相近但成本较高;由于具备视觉能力,还能做图像上的类型化决策,这是 Jev 和 Laya 做不到的。文章还讨论了推理模式的准确性收益与成本代价、选项数量与重命名对结果的影响,并开源了实现与基准代码。

技术 › LLM yibie 2026-09-2814.3 KB 2.8K 17 87

智谱用 GLM-5.3 自己优化了自己的推理系统

智谱披露 GLM-5.3-Flash 的全部生产推理已运行在超 10 万块国产 AI 加速器上,从跑通到上线不到两周,端到端吞吐量提升 3.2 倍,大量优化工作由 GLM-5.3 驱动的智能体完成。核心经验在于'密集反馈'机制:将资深工程师的隐性过程奖励显性化为分层验证接口,让智能体自主定位并修复精度漂移、GIL 并发瓶颈、重复计算等真实工程问题。国产芯片单 token 成本已对标英伟达 GPU。唐杰指出目标设定与高风险审查仍由人负责,但最小递归自我改进闭环已存在。

技术 › LLM 宝玉 (@dotey) 2026-09-174.2 KB 84

如何在本地运行开源 GLM-5.3-Flash 模型

本文详细介绍在个人机器上本地部署 GLM-5.3-Flash(320B 总参数、激活约 18B 的 MoE 模型)的完整流程。作者首先澄清显存误区:即使激活参数小,仍需容纳完整权重,最小 GGUF 量化文件即超 93GB,100GB 内存是起跑线。教程提供两条路线:一是使用图形化的 Unsloth Desktop 快速上手;二是编译支持 glm5next 架构的 llama.cpp 专用分支,并启动兼容 OpenAI 接口的本地服务。文章还涵盖硬件需求估算、量化版本选择建议(UD-IQ2_XXS 适合 128GB 机器)、常见报错排查与性能优化要点。

技术 › LLM 极客开源 2026-09-0711.5 KB 3.9K 13 86

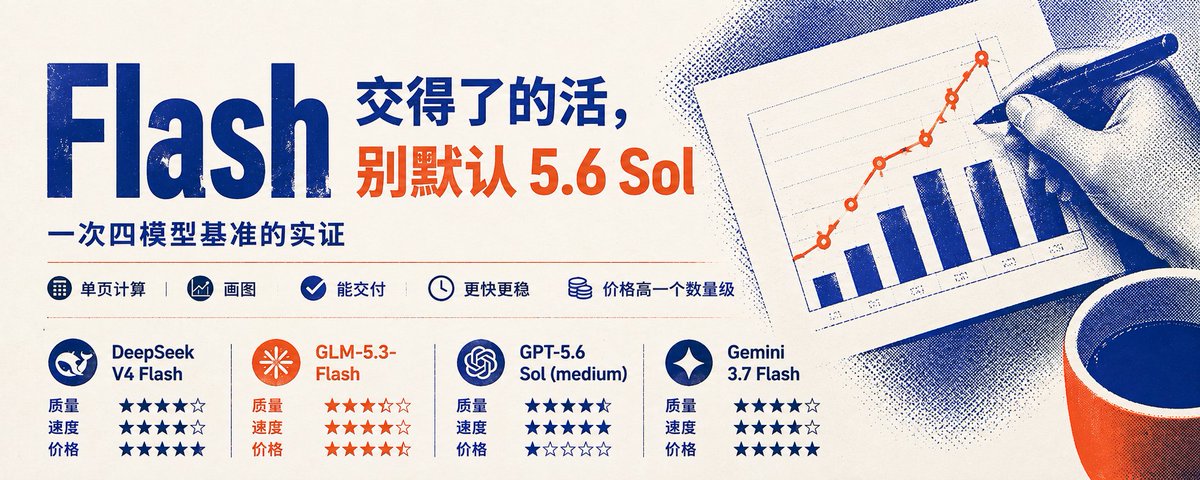
Flash 交得了的活,别默认 5.6 Sol:一次四模型基准的实证

作者通过同一 Hermes Agent、同一数据目录和任务,对 DeepSeek V4 Flash、GLM-5.3-Flash、Gemini 3.7 Flash 和 GPT-5.6 Sol 四个模型进行单页计算与画图任务的基准测试。结果显示,Flash 模型已能胜任此类任务,其中 DeepSeek V4 Flash 用时最短且成本最低,GPT-5.6 Sol 虽稳定但价格高一个数量级。作者建议默认使用 Flash,将 Sol 作为备选,并强调测试的局限性与诚实声明。

技术 › LLM Kimberly 2026-09-017.7 KB 8.6K 15 81

实测智谱 GLM-5.3-Flash,我称之为能稳稳把 DeepSeek 纳入斩杀线

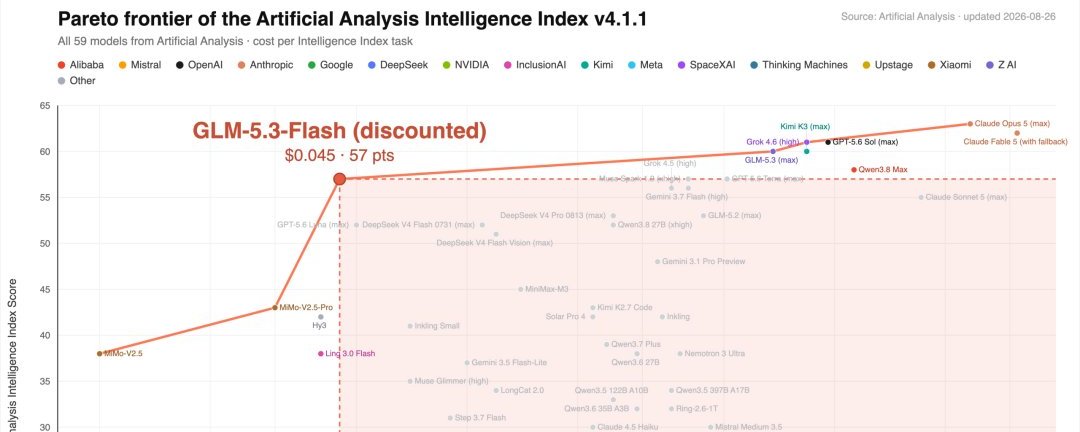
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。

技术 › LLM 卡尔的AI沃茨 2026-08-3111.6 KB 1.9K 1 71

爆火的《牛来》模型正式发布!GLM-5.3-Flash 实战测评

匿名爆火的「牛来」模型 Ox-Alpha 揭晓身份,是智谱的首个原生多模态模型 GLM-5.3-Flash。仅 320B 参数(激活 18B),能力对标 Claude Opus 4.8,价格仅其 1/40,MIT 协议开源,跑在 10 万张国产芯片上。作者使用智谱官方 Harness 工具 ZCode 进行三个项目实测:复刻 Apple Vision 产品页、开发全栈 AI 绘图工具、制作 3D 联机对战游戏《牛来格斗》。测评显示其视觉理解与截图自主验证能力对 AI 编程体验提升巨大,长程任务稳定,但实时网络同步等后端难点仍有不足。

技术 › LLM 程序员鱼皮 2026-08-2818.9 KB 14K 9 72

BestBlogs 早报 · 08-28|MHS 连接真实设备,Anthropic 重构产品协作,GLM 5.3 Flash 以架构与国产芯片降本

本期早报聚焦智能体真实交付的三个坐标。其一,Anthropic 的 MHS 研究预览通过标准驱动和统一能力格式,把实验室设备集成从数周压缩到数小时,让智能体操作显微镜、移液工作站与机械臂,卡内基梅隆团队报告实验速度提升约三倍。其二,Mike Krieger 讨论智能体时代团队从逐步派任务转向结果委派,同时强调可观测性、Feature Flag 与意图审查等工程控制的重要性。其三,智谱 GLM-5.3-Flash 通过稀疏注意力、视觉反馈和国产芯片推理栈实现五层降本。速览覆盖教育实验、双盲评估、数据治理、商业协议与算力金融化等话题。

技术 › LLM ginobefun 2026-08-2829.0 KB 5K 1 79

对标 Opus 4.8,价格只有 1/40,“牛来”模型 GLM-5.3-Flash 实测

智谱发布 GLM-5.3-Flash 模型(320B 总参数、仅激活 18B),即此前在 X 上爆火的匿名“牛来”模型。其 AA 综合智能指数达 57 分,与 Opus 4.8 相当,但价格仅为后者的 1/40,并采用稀疏注意力+线性注意力混合架构,由国产芯片支撑全部线上推理流量。作者通过多个实测案例展示模型能力:一句话从 PDF 生成企业官网、生成带真实图片的 PPT、模拟 Omarchy Linux 界面、构建在线 Excel、开发多款小游戏,以及用多模态能力自动剪辑《楚门的世界》电影解说视频。文章认为该模型以架构创新和国产算力打破了“前沿模型必然昂贵”的逻辑,且已以 MIT 协议开源。

技术 › LLM 向 向阳乔木 2026-08-2715.3 KB 26.7K 22 77

GLM-5.3-Flash 发布:多模态大模型,开始真正“看着自己干活”了

文章介绍了智谱 GLM-5.3-Flash 模型的发布。该模型总参数量 320B、激活 18B,采用稀疏与线性注意力混合架构,注意力计算量降低 3 倍,支持 1M 上下文。作为 GLM-5 系列首个原生多模态模型,其最大亮点是视觉能力被直接纳入 Coding 循环,模型可观察网页截图、渲染结果和交互反馈,自主发现并修正问题,实现“生成—检查—迭代—交付”的完整闭环。文章还展示了其在游戏开发、3D 建模、办公文档和法律金融场景的应用,并给出 API 使用细节,认为大模型竞争正从回答质量转向完整工作的交付质量。

技术 › LLM Smartpig 2026-08-276.8 KB 6.5K 11 77

2026年AI订阅性价比终极对比:Claude/Codex/Grok/DeepSeek/GLM/OpenCode Go哪家最划算

因DeepSeek官方API涨价,作者对比了2026年主流AI订阅套餐的性价比。结论:34元人民币的OpenCode Go订阅最划算,可0.33倍率用DeepSeek、0.083倍率用Muse Spark 1.2;30美元档推荐SuperGrok、GPT Plus和GLM Lite;200美元档推荐Claude Max和GPT Pro;300美元档推荐SuperHeavy。文章还详细列出各套餐的坑点,如Claude易封号建议通过苹果商店购买、Grok节点不干净会降智、GLM限购且速度慢等,并附AI模型智力排行榜。

技术 › Openclaw 峰哥亡命天涯 2026-08-213.5 KB 32.9K 43 70

实测GLM5.3:1/3参数量+后训练逼平GPT-5.6

本文实测了智谱最新发布的GLM-5.3模型,该模型基于GLM-5.2的750B参数基础模型,仅通过后训练提升性能,在AA榜上以60分进入前十,成为同分段参数最小的模型。作者通过多个编码与安全案例测试,包括修复Ice菜单栏工具漏洞、开发2D跑酷游戏、3D愤怒的小鸟及音乐工作台等,展示了GLM-5.3在复杂编码、长程Agent任务和防御性网络安全方面的出色表现,并对比了DeepSeek、Grok等模型,认为后训练Scaling是提升模型能力的重要路径。

技术 › LLM 卡尔的AI沃茨 2026-08-2115.0 KB 4K 6 69

多花 10-20% 心思在 UI 上就是在这个 AI slop 满天飞的时代最大的竞争优势

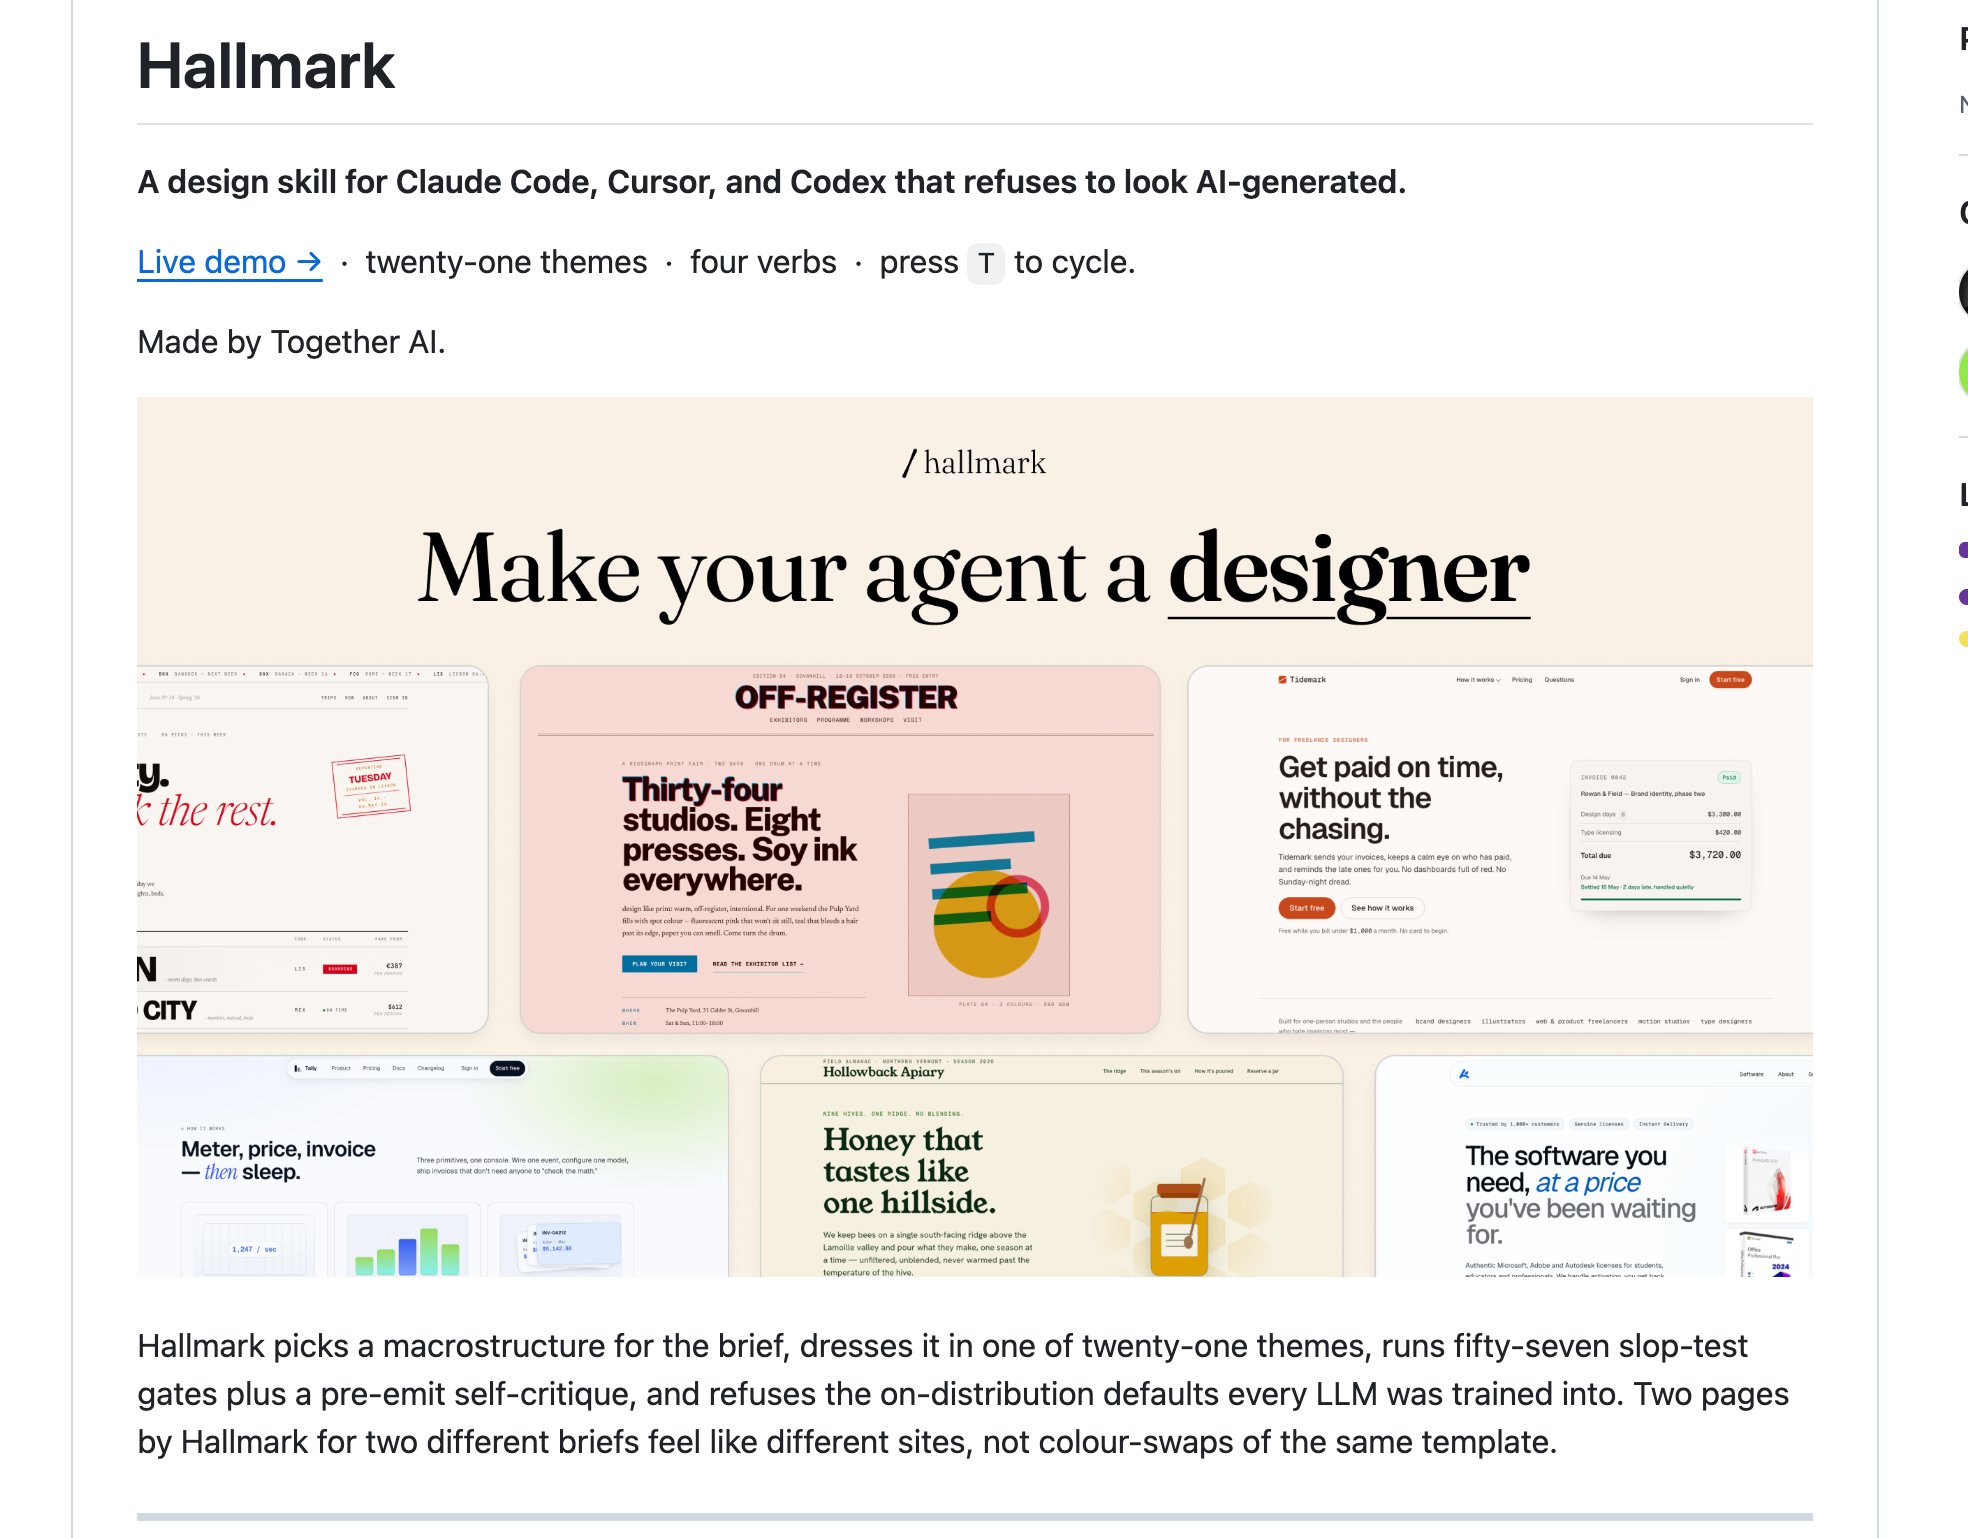
本文分享了在 AI 生成内容泛滥的时代,通过多花 10-20% 的心思在 UI 设计上,可以成为最大的竞争优势。作者介绍了 Together AI 大神哈桑的 /Hallmark design skill,该技能通过将 AI 生成的常见设计套路列为负面规则,有效提升了 AI 生成 UI 的质量。文章还总结了几个关键心得:摸清 AI 套路、给 agent 喂参考图、使用更具体的长提示词,以及利用便宜小模型进行快速迭代。

技术 › 工具与效率 LinearUncle 2026-08-201.4 KB 65

从0开始,在国内用上Claude Code的终极保姆教程

本文是一份针对国内用户的 Claude Code 安装与配置保姆级教程。文章详细介绍了在 Mac 和 Windows 系统下,无论是否有网络代理,如何安装 Claude Code 框架。同时,为了解决国内访问 Claude 官方模型的困难,作者提供了使用国产模型(如 GLM-5.1)的接入方案。教程涵盖了从环境配置、工具安装(如 Homebrew、Git)、模型切换工具 CC Switch 的使用,到配置 CLAUDE.md 规范文件的完整流程,旨在帮助新手用户无障碍地使用这一 Agent 框架。

技术 › Claude Code 数字生命卡兹克 2026-04-2019.7 KB 341.9K 2.6K 88