Wiki 知识库

全部文档 / 标签: 统一内存

3 篇
清除

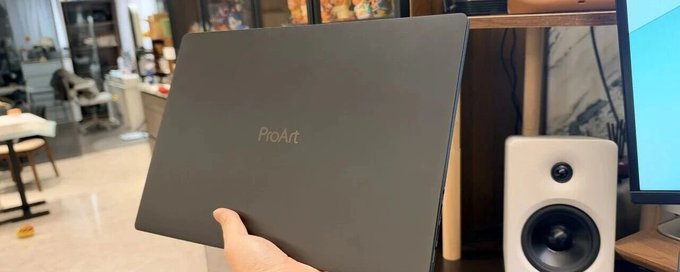
这台卖37999的RTX Spark电脑,让我实现了Token自由

作者分享了使用英伟达RTX Spark笔记本(华硕ProArt创16,128G统一内存+1T,售价37999元)一周的深度体验。该设备结合了大内存与CUDA生态,解决了本地跑大模型要么选Mac要么受显卡显存限制的痛点。作者演示了通过WorkBuddy部署各类本地模型,包括Qwen3.8-27B大语言模型、图像生成、视频生成、OCR、ASR、TTS等,并打包成一个专家应用方便开箱即用。文章还讨论了AI全天候工作带来的成本问题,认为本地算力是实现Token自由、摆脱API费用束缚的关键方案。

技术 › LLM 数字生命卡兹克 2026-10-1821.4 KB 55.4K 170 77

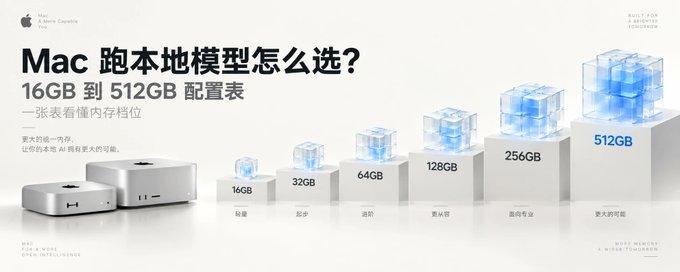
2026 Mac 跑大模型配置指南|16GB 到 512GB 怎么选

文章针对 Apple 新发布的 M6 Mac mini 与 M5 Mac Studio 系列,系统讲解如何为本地运行大模型选择合适配置。作者提出三笔账:内存容量决定模型能否装下、内存带宽决定生成速度、算力决定提示词处理和训练能力。给出 4 位量化模型内存估算公式和生成速度理论公式,并提供四档选购建议:24-32GB 跑 8B-14B、64GB 跑 32B、128GB 跑 70B、256-512GB 跑 200B 以上或 671B MoE。最后指出数据保密、高频调用、离线需求才是为本地模型购买大内存 Mac 的真正理由。

技术 › LLM 苏乐 2026-09-2019.6 KB 317.2K 453 86

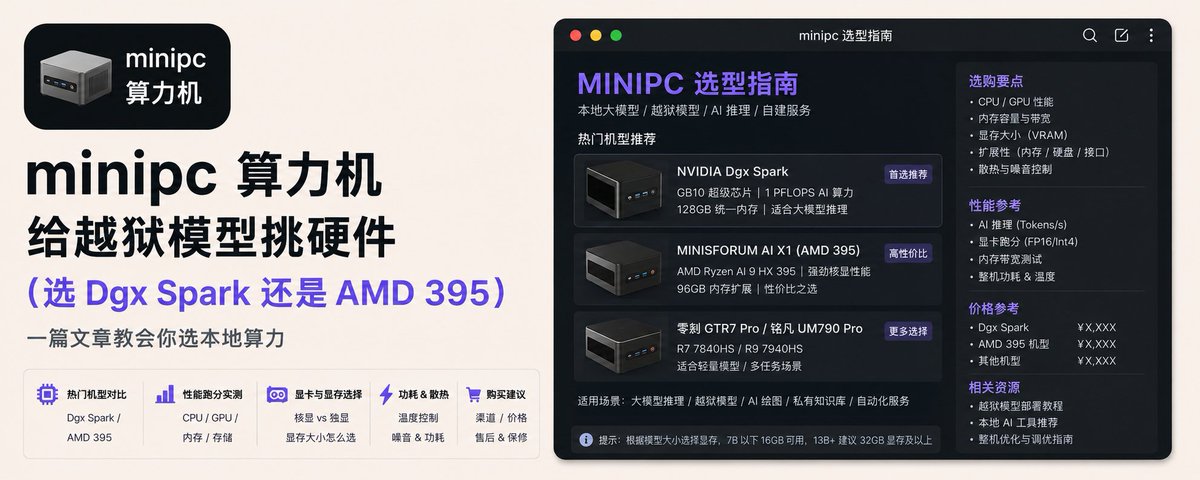
AIPC选购指南:DGX Spark 还是 AMD 395?

文章对比了两款桌面跑大模型的设备:英伟达 DGX Spark(国行3.5万)与搭载 AMD Ryzen AI Max+ 395 的小主机(近2万)。两者均采用统一内存架构、128GB 内存,可装下 70B 级模型。核心结论:出字速度受内存带宽限制,两台几乎一样;读题(预填充)速度 Spark 快五到六倍,资料越长优势越大。文章还分析了各自优缺点、CUDA 生态、双机集群跑 DeepSeek-V4 的玩法及真实翻车案例。

技术 › LLM 黄小木 2026-08-2227.2 KB 100.7K 119 86