Wiki 知识库

全部文档 / 标签: 模型量化

7 篇
清除

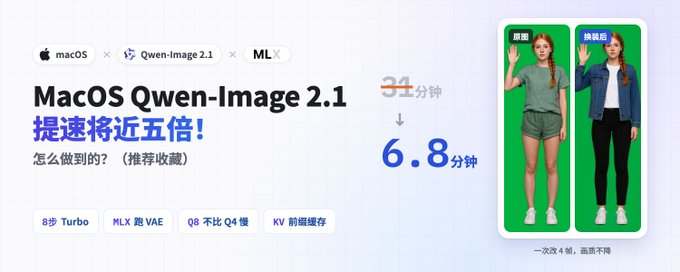
MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)

作者分享了在 M2 Pro Mac 上将 Qwen-Image 2.1 改图时间从 30 分钟压到 6.8 分钟(提速4.5倍)的完整方法论。首先通过耗时拆解定位瓶颈,然后叠加四个优化点:换用 Turbo 模型将去噪从20步降至8步;将 VAE 编解码切换到苹果 MLX 框架,从315秒降到15秒;实测发现 Q8 与 Q4 量化在扩散模型上速度相同,因此选用画质更好的 Q8;利用块因果结构实现前缀 KV 缓存,使每步采样时间减半。作者还用该流水线完成了一段10秒视频的逐帧换装,并通过肤色基准校正、锚点补偿和时序平滑三层方案解决了误差累积问题。

技术 › 工具与效率 WquGuru 2026-10-1311.0 KB 16.6K 87 88

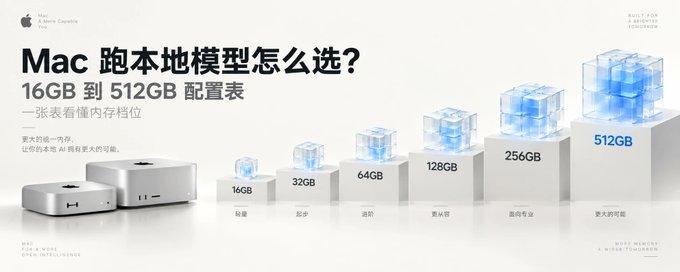
2026 Mac 跑大模型配置指南|16GB 到 512GB 怎么选

文章针对 Apple 新发布的 M6 Mac mini 与 M5 Mac Studio 系列,系统讲解如何为本地运行大模型选择合适配置。作者提出三笔账:内存容量决定模型能否装下、内存带宽决定生成速度、算力决定提示词处理和训练能力。给出 4 位量化模型内存估算公式和生成速度理论公式,并提供四档选购建议:24-32GB 跑 8B-14B、64GB 跑 32B、128GB 跑 70B、256-512GB 跑 200B 以上或 671B MoE。最后指出数据保密、高频调用、离线需求才是为本地模型购买大内存 Mac 的真正理由。

技术 › LLM 苏乐 2026-09-2019.6 KB 317.2K 453 86

DeepSeek V4.1 Flash:架构学习笔记

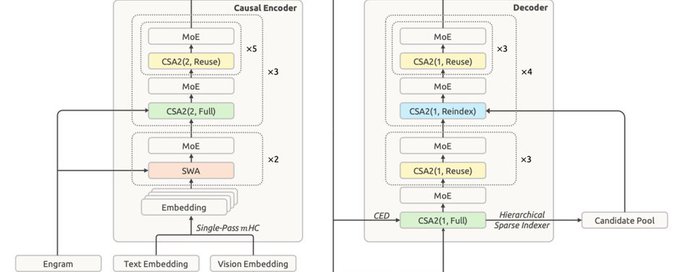
本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。

技术 › LLM AI Dance 2026-09-1113.1 KB 21.3K 203 79

越狱大模型小白从 0 到 1 教程

本文面向新手系统讲解大模型越狱的基础知识。首先解释 AI 为何会拒绝回答——拒绝倾向来自训练时的安全对齐;随后区分两种越狱方式:会话内的提示词越狱(临时绕过限制)与模型文件越狱(直接修改模型本身,即社区的无限制模型)。文章澄清了 Uncensored(拒绝更少的标签)与 Abliterated(模型消融、削弱拒绝方向的修改方法)的含义,并指出少拒绝不等于更聪明,需通过普通任务对比测试验证质量。最后介绍 Base/Instruct、GGUF、量化等模型名词,并给出写小说、阅读敏感资料等实际应用建议。

技术 › LLM 黄小木 2026-09-079.5 KB 131.5K 247 68

Pi Agent + Qwen 3.8 27B 深度优化

作者在懒猫AI算力舱 X5(128GB显存)上部署 Qwen 3.8 27B 稠密模型,真实项目中跑了4个任务均完成良好。通过 MTP 投机解码 + NVFP8 混合优化并关闭 thinking 模式,速度从 13.9 提升到 30.8 Tokens;但发现关闭思考模式会降低代码推理准确度,重新开启后实测稳定 26.47 Tokens(含思考阶段实际可达 35.23 Tokens/s)。后续还将通过重新量化构建 draft engine 进一步提速。

技术 › LLM Andy Stewart 2026-08-252.7 KB 26.1K 42 55

MiniMax H3 8G 最低配本地部署与出片全流程实测

本文详细记录了在RTX 3060 Ti 8GB最低配显卡上本地部署运行MiniMax H3音视频大模型的全流程。涵盖ComfyUI安装、39.6GB量化模型下载及排坑(如文件截断断点续传)。实测验证了该配置的生成耗时、分辨率与帧数限制。文章总结了生成画面的两条硬规则及结构化提示词的三字段写法,并意外发现模型对中文字体渲染极佳,为低显存用户提供了一套可实操的保姆级教程。

技术 › 工具与效率 mousepotato 2026-08-0922.8 KB 75K 140 96

本地大模型小白从0到1完整入门教程

本文是一篇面向新手的本地大模型运行与部署全攻略。文章首先对比了云端与本地模型在隐私和成本上的差异,随后用通俗易懂的语言拆解了模型命名、参数量(B)、量化压缩(Q4_K_M)等核心概念。教程详细指导了如何根据显存计算并选择合适的硬件与模型,并推荐了LM Studio与ComfyUI等无代码软件。最后,针对文本对话、图像及视频生成三大场景,提供了具体的模型选型建议与实战评测方法,帮助小白零基础快速玩转本地AI生态。

技术 › LLM 黄小木 2026-08-0620.3 KB 186.2K 291 89