Wiki 知识库

全部文档 / 标签: 视觉理解

3 篇
清除

如何让AI更高效的做网站设计

文章介绍如何解决AI生成网页时“不太对,再改一下”这类模糊修改意见难以落地的问题。作者拆解百灵 Ling-3.0-flash-VL 的官方演示,并提出用 Claude Code + Ling-3.0-flash-VL + Playwright MCP 的复现方案:VL 负责看参考图、生成代码和分析差异,Claude Code 负责读写文件和调用工具,Playwright 负责打开浏览器截图。关键细节是保持截图宽度一致,并让模型真正查看截图。作者建议从作品集首屏入手,通过截图对照迭代修改,让“看着不太对”变成可对照的图片差异。
技术 › 前端 Cheery 2026-09-174.9 KB 47.3K 129 75

实测豆包新模型2.1-pro,这次审美和长时间Agent任务都追上第一档了

作者实测火山方舟最新发布的Doubao-Seed-2.1-pro模型,通过五个真实任务案例评估其能力:用Three.js复现3D体素浮空樱花岛、开发沉浸式3D小笼包互动网页、从洗衣机产品文档提取参数生成对比表格、处理61个子表的钢筋含钢量计算、以及加拿大办公室选址调研。测试显示该模型在审美还原、长时Agent任务稳定性、视觉理解和数据严谨性上都达到第一梯队水平,能处理百万上下文任务而不摆烂,输出结果可追溯、细节丰富。文章最后还介绍了QBS方法——将书籍转为skill让AI按书中方法回答,避免说空话。

技术 › LLM 卡尔的AI沃茨 2026-09-1717.3 KB 7.6K 2 78

实测智谱 GLM-5.3-Flash,我称之为能稳稳把 DeepSeek 纳入斩杀线

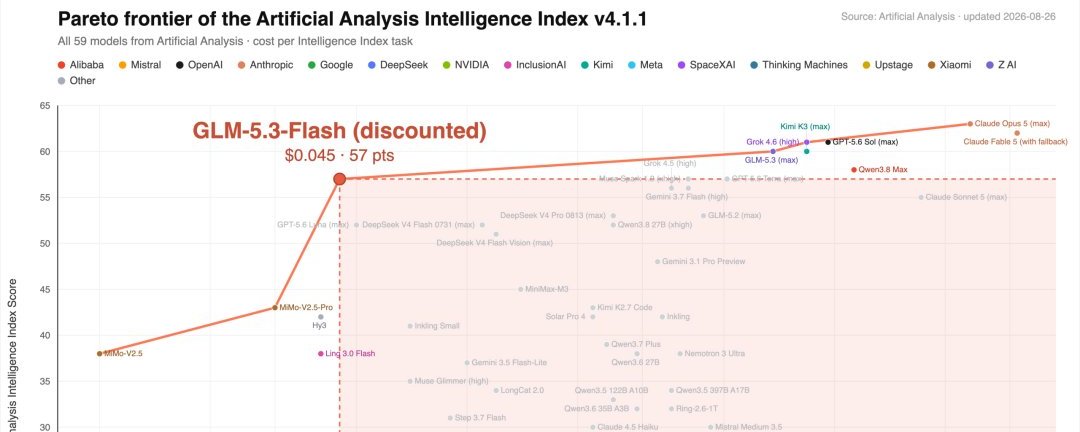
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。

技术 › LLM 卡尔的AI沃茨 2026-08-3111.6 KB 1.9K 1 71