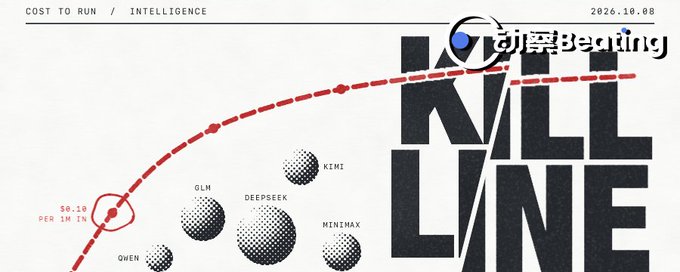
中国大模型的斩杀线,被斩杀了
Anthropic 发布 Haiku 5.5,将短请求价格压至上一代十分之一,OpenAI 同步降价,美国巨头以巨额资金和工程优化发起价格战,接管了帕累托前沿。中国大模型曾凭借 DeepSeek 等极致性价比焊死斩杀线,迫使硅谷换用中国开源基座,但自身陷入增收不增利、算力告急与防御性涨价的困境。随着美国巨头闪电降价,中国模型股价暴跌,低价护城河被填平,斩杀线反被斩杀。
Anthropic 发布 Haiku 5.5,将短请求价格压至上一代十分之一,OpenAI 同步降价,美国巨头以巨额资金和工程优化发起价格战,接管了帕累托前沿。中国大模型曾凭借 DeepSeek 等极致性价比焊死斩杀线,迫使硅谷换用中国开源基座,但自身陷入增收不增利、算力告急与防御性涨价的困境。随着美国巨头闪电降价,中国模型股价暴跌,低价护城河被填平,斩杀线反被斩杀。
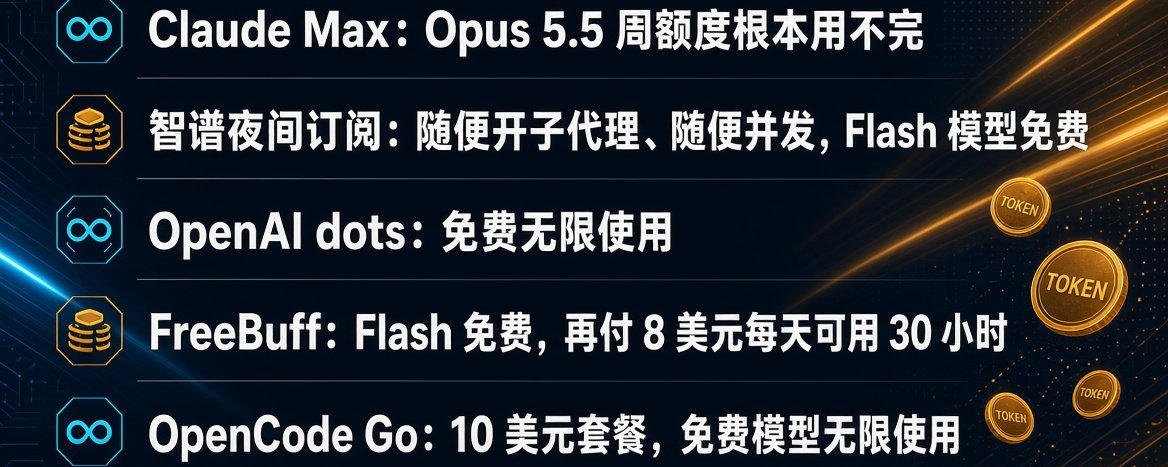
文章指出 AI 市场出现新变化:各家厂商的 Token 额度开始过剩。Claude Max 用户反映 Opus 5.5 周额度用不完;智谱夜间订阅可随意开子代理、高并发,Flash 模型免费;OpenAI 的 dots 模型免费无限使用;FreeBuff 免费提供 Flash 模型,付费 8 美元每天可用 30 小时;OpenCode 的免费模型仅需 10 美元 Go 套餐即可无限使用。作者由此提出疑问:Token 从稀缺转向过剩,是否意味着半导体和 AI 相关股票将面临崩盘风险。
智谱披露 GLM-5.3-Flash 的全部生产推理已运行在超 10 万块国产 AI 加速器上,从跑通到上线不到两周,端到端吞吐量提升 3.2 倍,大量优化工作由 GLM-5.3 驱动的智能体完成。核心经验在于'密集反馈'机制:将资深工程师的隐性过程奖励显性化为分层验证接口,让智能体自主定位并修复精度漂移、GIL 并发瓶颈、重复计算等真实工程问题。国产芯片单 token 成本已对标英伟达 GPU。唐杰指出目标设定与高风险审查仍由人负责,但最小递归自我改进闭环已存在。
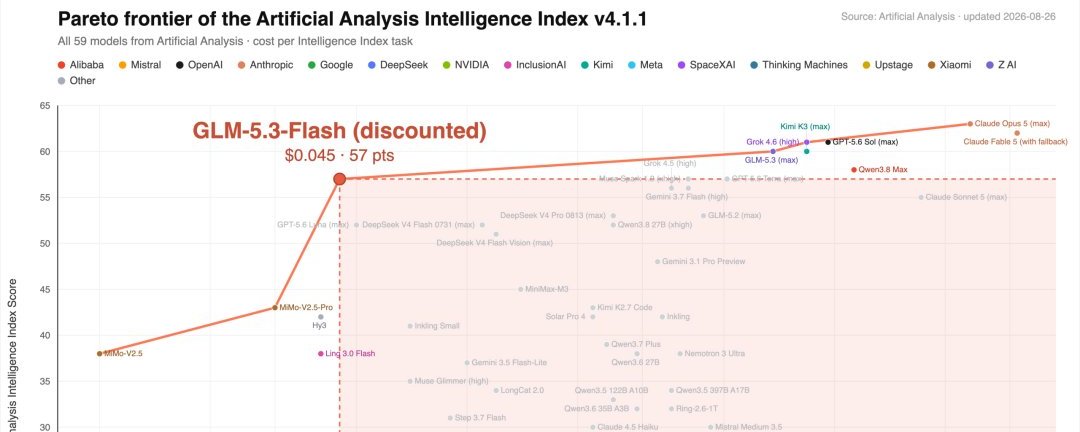
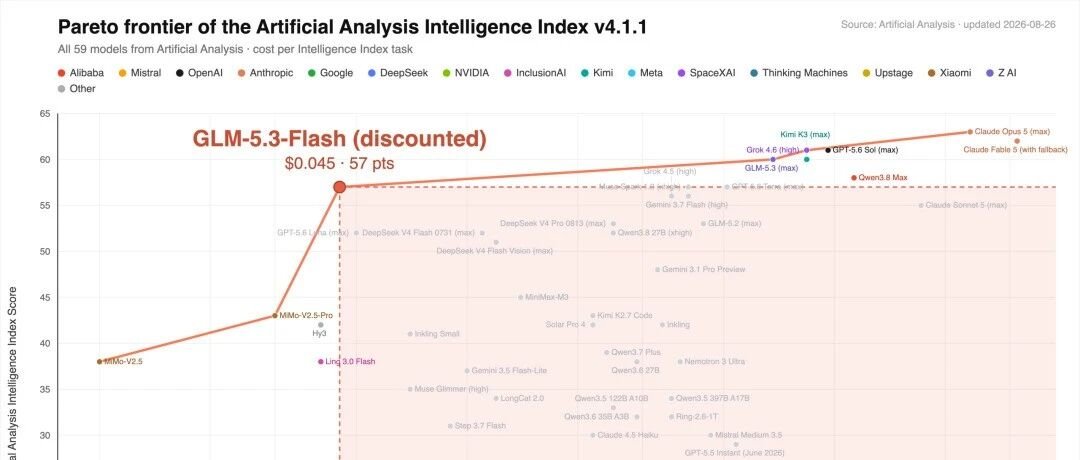
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。
匿名爆火的「牛来」模型 Ox-Alpha 揭晓身份,是智谱的首个原生多模态模型 GLM-5.3-Flash。仅 320B 参数(激活 18B),能力对标 Claude Opus 4.8,价格仅其 1/40,MIT 协议开源,跑在 10 万张国产芯片上。作者使用智谱官方 Harness 工具 ZCode 进行三个项目实测:复刻 Apple Vision 产品页、开发全栈 AI 绘图工具、制作 3D 联机对战游戏《牛来格斗》。测评显示其视觉理解与截图自主验证能力对 AI 编程体验提升巨大,长程任务稳定,但实时网络同步等后端难点仍有不足。
本期早报聚焦智能体真实交付的三个坐标。其一,Anthropic 的 MHS 研究预览通过标准驱动和统一能力格式,把实验室设备集成从数周压缩到数小时,让智能体操作显微镜、移液工作站与机械臂,卡内基梅隆团队报告实验速度提升约三倍。其二,Mike Krieger 讨论智能体时代团队从逐步派任务转向结果委派,同时强调可观测性、Feature Flag 与意图审查等工程控制的重要性。其三,智谱 GLM-5.3-Flash 通过稀疏注意力、视觉反馈和国产芯片推理栈实现五层降本。速览覆盖教育实验、双盲评估、数据治理、商业协议与算力金融化等话题。
作者袋鼠帝开发并开源了一款AI原生截图工具“拓(Ta)”,具备钉图、标注、马赛克、截长图等常规功能,并深度集成AI能力:框选即可OCR识别文字、翻译并自动复制到剪贴板,还支持AI识图。拓可作为skill或CLI接入任何Agent(如Codex),实现自动截图获取报错信息等自动化流程。开发过程使用智谱最新开源模型glm-5.3-flash,作者评价其coding、agent与视觉能力出色,价格仅为Opus的1/40,兼具速度、性能与性价比,标志前沿模型进入普惠时代。
文章揭秘了海外爆火的匿名模型OX Alpha的真实身份——智谱发布的GLM-5.3-Flash。该模型是总参数320B、激活18B的MoE架构,GLM-5系列首个原生多模态模型,支持图像、视频和文本输入,上下文达100万。其能力逼近Opus 4.8,而价格极低(每百万Token输入0.8元、输出2.8元),比DeepSeek V4还便宜一半。作者通过自建1000条新闻评测集实测发现其在精选率和品味上优于MiMo 2.5 Pro和DeepSeek V4 Pro,前端代码能力也直逼顶级模型。此外,智谱用10万张国产卡扛下了匿名测试期的全部推理流量。作者决定将AIHOT网站模型全面切换至GLM-5.3-Flash。
智谱发布 GLM-5.3-Flash 模型(320B 总参数、仅激活 18B),即此前在 X 上爆火的匿名“牛来”模型。其 AA 综合智能指数达 57 分,与 Opus 4.8 相当,但价格仅为后者的 1/40,并采用稀疏注意力+线性注意力混合架构,由国产芯片支撑全部线上推理流量。作者通过多个实测案例展示模型能力:一句话从 PDF 生成企业官网、生成带真实图片的 PPT、模拟 Omarchy Linux 界面、构建在线 Excel、开发多款小游戏,以及用多模态能力自动剪辑《楚门的世界》电影解说视频。文章认为该模型以架构创新和国产算力打破了“前沿模型必然昂贵”的逻辑,且已以 MIT 协议开源。
文章介绍了智谱 GLM-5.3-Flash 模型的发布。该模型总参数量 320B、激活 18B,采用稀疏与线性注意力混合架构,注意力计算量降低 3 倍,支持 1M 上下文。作为 GLM-5 系列首个原生多模态模型,其最大亮点是视觉能力被直接纳入 Coding 循环,模型可观察网页截图、渲染结果和交互反馈,自主发现并修正问题,实现“生成—检查—迭代—交付”的完整闭环。文章还展示了其在游戏开发、3D 建模、办公文档和法律金融场景的应用,并给出 API 使用细节,认为大模型竞争正从回答质量转向完整工作的交付质量。
匿名模型 Ox Alpha 揭晓为智谱 GLM-5.3 Flash,320B 参数、MIT 开源、原生多模态、1M 上下文,限时价格仅为 Opus 4.8 的 1/40。作者通过三个前端场景实测:仅凭一张图用 Three.js 复刻玻璃折射海报、看录屏视频还原 60 片玻璃螺旋彩带交互网站、将静态体素海报改造为滚动揭示的 3D 网页,均表现出顶级多模态理解与代码能力,远超同价位的 DeepSeek V4 Flash,接近 Fable 5 但便宜约百倍。作者认为其把'便宜又够用'的行业斩杀线大幅推进,让预算有限的创作者也能用上前沿智能。
文章梳理了DeepSeek、Kimi、智谱和MiniMax四家中国头部大模型公司的创始人信息,包括年龄、学历背景及身家估值,并探讨了学历与家庭背景对成功的影响。