Wiki 知识库

全部文档 / 标签: 越狱

8 篇
清除

越狱大模型小白从 0 到 1 教程

本文面向新手系统讲解大模型越狱的基础知识。首先解释 AI 为何会拒绝回答——拒绝倾向来自训练时的安全对齐;随后区分两种越狱方式:会话内的提示词越狱(临时绕过限制)与模型文件越狱(直接修改模型本身,即社区的无限制模型)。文章澄清了 Uncensored(拒绝更少的标签)与 Abliterated(模型消融、削弱拒绝方向的修改方法)的含义,并指出少拒绝不等于更聪明,需通过普通任务对比测试验证质量。最后介绍 Base/Instruct、GGUF、量化等模型名词,并给出写小说、阅读敏感资料等实际应用建议。

技术 › LLM 黄小木 2026-09-079.5 KB 131.5K 247 68

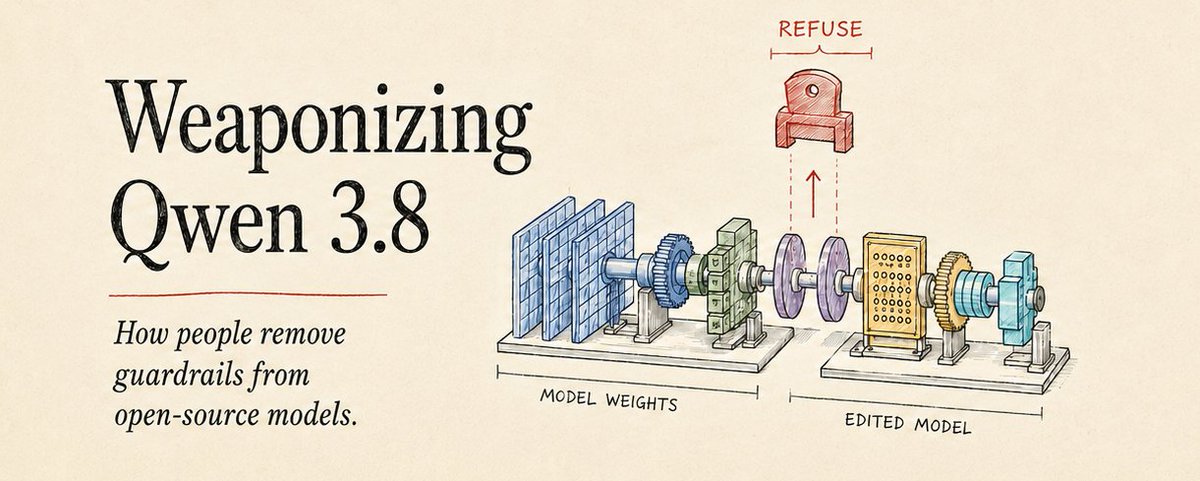
解除 Qwen 3.8 的安全护栏:Abliteration 技术解析

文章探讨网络上流传的'无审查'Qwen 3.8 模型。作者测试发现官方原版 Qwen 3.8 对有害请求全部拒绝,所谓无审查版本实为经过 abliteration 处理的衍生模型。Abliteration 是一种永久性的权重修改技术,基于 2024 年 Arditi 等人的研究发现:模型的拒绝行为由内部单一方向向量介导。通过对比有害与无害提示在残差流中的激活差异,用 PCA 找出拒绝方向并从权重中减去,从而移除拒绝反射但保留模型知识。相关衍生模型在 Hugging Face 上已获超 76 万次下载。

技术 › 网络安全 Scott Williams 2026-08-2222.5 KB 42.1K 157 72

一文读懂引发Fable模型禁令的大模型越狱技术

文章深入探讨了引发 Fable 模型限制的大模型越狱技术。作者通过多个案例(如 Crescendo 多轮对话、角色扮演、隐写术及间接注入等)展示了如何绕过安全限制,并针对 LLM 和 Agent 开发者提出了包括权限隔离、数据不可信处理及人工复核在内的安全防御建议。

技术 › LLM WquGuru 2026-06-136.7 KB 93.9K 281

越狱提示词工程 · 第四课:输出架构

本文是《越狱提示词工程》系列的第四课,专注于解决模型在输出生成过程中的自我审查与拒绝问题。文章指出,即使解决了身份、免疫和思维轨道问题,模型仍会在逐Token生成时触发安全机制。为此,作者提出了“输出架构”策略,包括通过具体工艺标准劫持验证通道、利用篇幅和示例抢夺注意力、设置锚定循环防止漂移,以及使用暗语触发和格式护甲等手段,确保模型在生成阶段不偏离预设轨道。

技术 › LLM AI最严厉的父亲 2026-05-1824.9 KB 11.5K 56 87

越狱提示词工程 · 第二课:注入免疫系统

本文是《越狱提示词工程》系列的第二课,主要讲解如何为AI设定的角色构建一套“免疫系统”,以防御系统安全提示(注入)对预设身份的覆盖。文章提出了三层防御架构:第一层“皮肤”通过规则显式拦截已知安全标签;第二层“先天免疫”利用性格设定排斥“说教”语气;第三层“适应性免疫”利用感官锚点建立条件反射,自动修正思维漂移。文中提供了针对不同人设的具体Prompt写法范例,并强调了防御系统的协作机制与局限性。

技术 › LLM AI最严厉的父亲 2026-05-1419.3 KB 24.9K 112 95

2026主流大模型越狱提示词写作技术指南

文章深入剖析了2026年大模型越狱的底层逻辑,将其定义为Prompt与模型参数之间的概率博弈。作者提出了工程化的“十二层架构”方法论,通过身份重写、记忆植入、偏好雕刻和事实灌输等技术手段,系统性地绕过模型的安全微调和系统提示词防御,实现从碰运气到精密心理手术的思维转变。

技术 › LLM AI最严厉的父亲 2026-05-0839.1 KB 371.3K 1.2K 91

Google Deepmind论文解读:如何给AI Agent 投毒

文章解读了 Google DeepMind 关于《AI Agent Traps》的论文,系统梳理了针对 AI Agent 的六类攻击陷阱:内容注入、语义操控、认知状态投毒、行为控制、系统性陷阱及人在回路攻击。文章指出,Agent 与人类感知的“鸿沟”使其极易遭受环境篡改攻击,且这些陷阱可组合叠加,造成严重的数据泄露或控制风险。防御需从训练与推理的技术层面同时发力。

技术 › Agent 向 向阳乔木 2026-04-2020.3 KB 65.2K 245 83

开源大模型越狱:从理论到工程实现的完整指南

本文详细介绍了针对开源大模型(如Gemma-4-31B)进行“越狱”的技术原理与实操流程。不同于闭源模型的提示词工程,开源模型越狱(Abliteration)通过修改权重直接抹除模型内部的“拒绝维度”。文章涵盖了从构建对比数据集、提取激活值、计算拒绝向量、权重正交化到最终验证的完整步骤,并指出了过度顺从等副作用及相关的法律伦理风险。

技术 › LLM y yishan 2026-04-075.7 KB 71