如何设计与构建 AI Agent 评估数据集
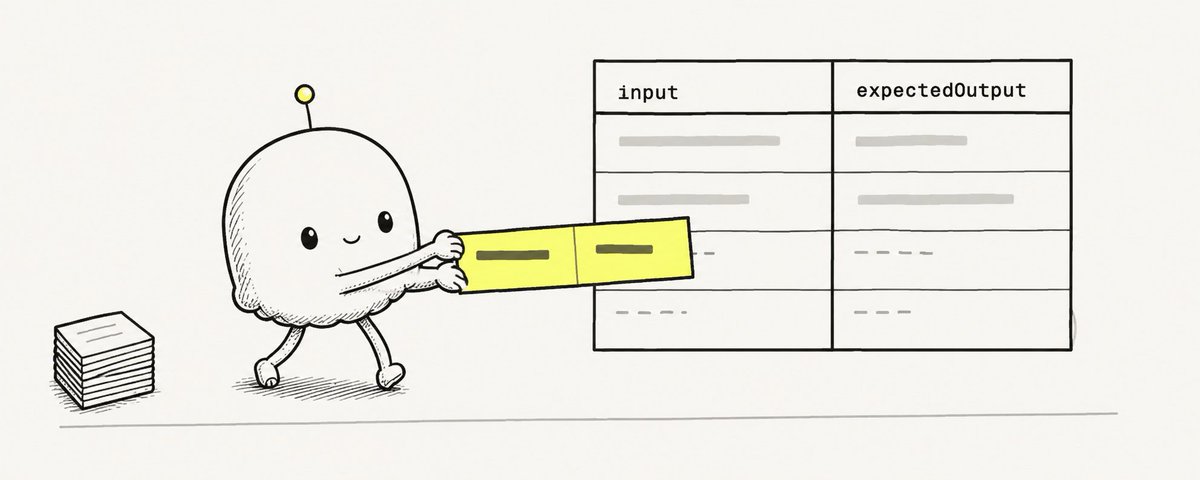
当应用仅靠直觉调试无法满足需求时,构建评估数据集至关重要。本文详细介绍了设计AI Agent评估数据集的五个核心步骤:1.明确数据集的最小目标;2.检查生产记录、现有资产等可用数据源;3.规划输入分布,合理搭配场景与难度;4.决定评估机制,选择基于参考或无参考的评估方式;5.定义包含输入、预期输出和元数据的结构化项目模式。通过迭代设计,确保系统质量可量化和持续改进。
当应用仅靠直觉调试无法满足需求时,构建评估数据集至关重要。本文详细介绍了设计AI Agent评估数据集的五个核心步骤:1.明确数据集的最小目标;2.检查生产记录、现有资产等可用数据源;3.规划输入分布,合理搭配场景与难度;4.决定评估机制,选择基于参考或无参考的评估方式;5.定义包含输入、预期输出和元数据的结构化项目模式。通过迭代设计,确保系统质量可量化和持续改进。
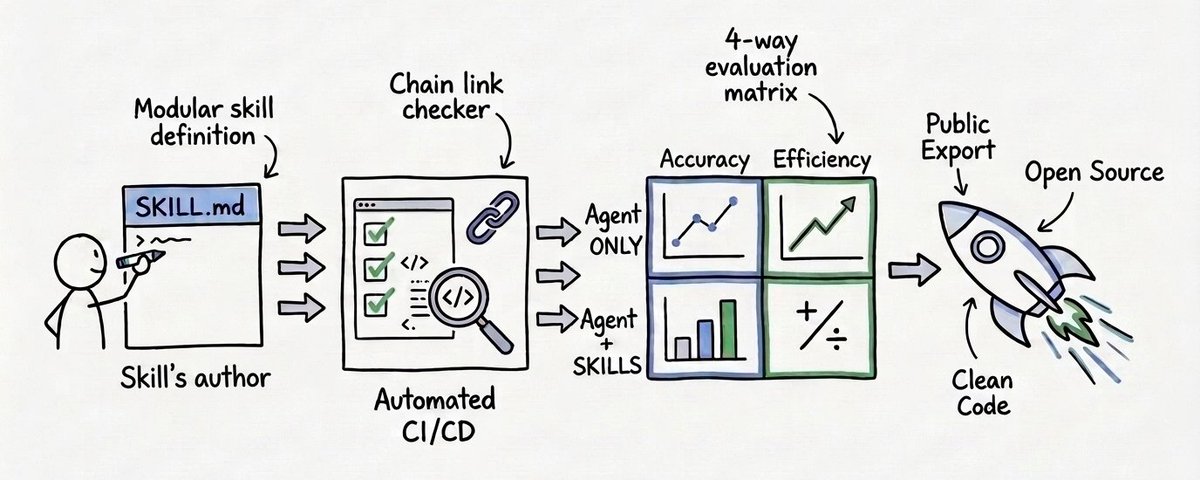
本文深入探讨了 Google Agent Skills 项目的构建与扩展。作者分享了如何通过标准化的存储结构、自动化 CI/CD 检查、持续的评估流程以及严格的所有权规则,来保证技能库在规模增长时的质量和可靠性。文章强调将技能视为产品而非简单代码片段,并介绍了利用 MCP 工具和 GitHub Actions 进行质量管控的实践。
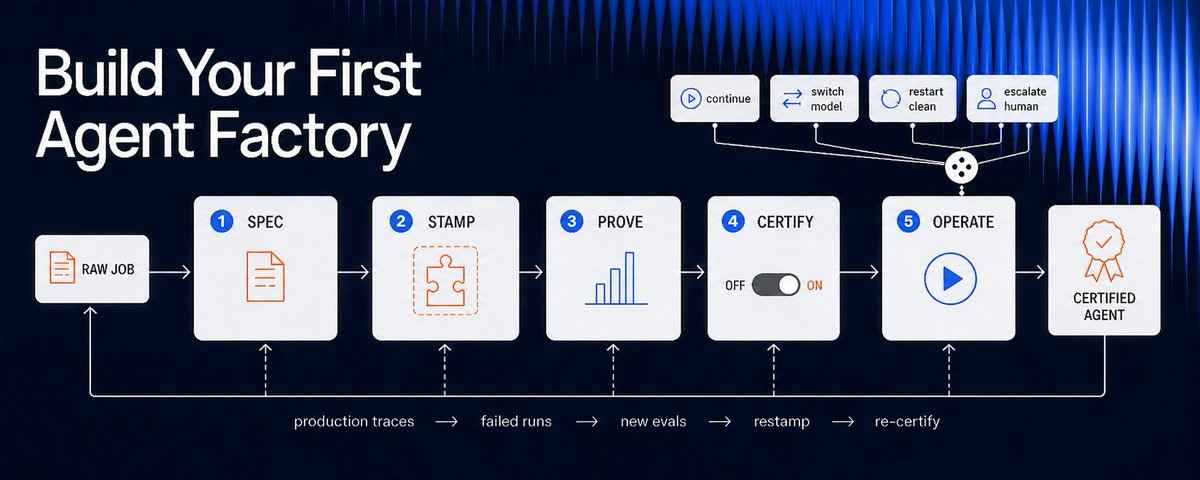
文章探讨了如何从构建单个智能体转向构建智能体工厂,以解决人工审核瓶颈问题。介绍了Sage决策模型在自动化质量控制和输出门控中的应用,提供了具体的实现思路和GitHub资源。
文章探讨了在企业级 Agent 开发中,如何通过建立版本化固定案例集和审计日志来准确评估模型更新后的质量变化。强调不能只看平均分,需逐条对比案例的改善与退步,并实施一票否决机制以确保安全和可追溯性。
《Clean Code》作者鲍勃大叔表示,为利用AI生产力,他不阅读AI生成的代码,而是通过设置单元测试、QA流程、代码质量指标等严格约束来确保质量。他提出了由多个Agent组成的流水线实践,强调AI时代核心能力从读代码转向写测试和定指标。
文章探讨了在智能体工程中,工程师需要掌控外层循环,即对系统的问责。通过定义质量、裁决和可回应性三个概念,强调人在AI辅助代码生成中的决策权和所有权。AI代码生成比例增长,但审查和验证成为瓶颈,需建立更有效的信任验证机制。
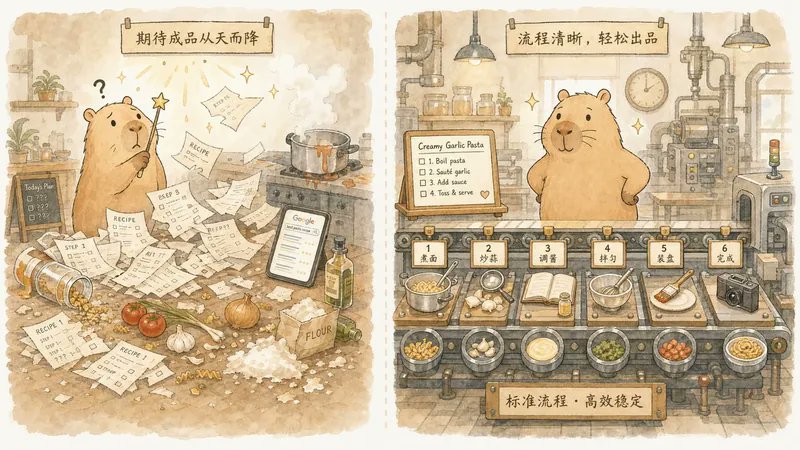
文章对比了AI写作的“魔法棒”与“流水线”模式,指出一次性生成缺乏质量门禁,容易产生误导性幻觉。作者提出了一套包含库检索、补搜、写作、配图、核查、修复的六步生产管线,强调通过结构化验证和分诊核查,确保每个论点有据可查,从而将AI写作从简单的文本生成升级为可验证的知识生产过程。
文章探讨了在代理工程和软件工厂时代,工程师的角色转变。作者指出,随着 AI 承担更多内部执行循环,工程师必须拥有“外部循环”的问责权,负责定义质量、做出最终裁决并保证可解释性。文章区分了内部循环(能力)与外部循环(能动性),强调虽然 AI 生成代码的速度提升了,但验证、治理和人为的判断力成为了稀缺资源。