Wiki 知识库

全部文档 / 标签: 模型评估

8 篇
清除

Agentic evals: 如何判断 AI Agent 是否真正完成了任务并保持可靠

本文面向构建基于 LLM 的 Agent 系统的工程师,讲解如何对 Agent 进行评估(Agentic Evals)。核心观点是:要评估 Agent 实际改变了什么,而非它说了什么。文章通过一个自行车店客服 Agent 的完整示例,展示五步评估法:编写带预期终态的任务、多次运行并保留完整轨迹、同时评估终态和路径、报告能力与可靠性两个数字、定位失败的第一步。文章还区分了单次回答模型与多步 Agent 在评估上的差异,强调没有可检验终态的任务不构成有效的评估,并讨论了模型作为评判者的可信度问题。

技术 › Agent Sergii Makarevych 2026-10-1151.9 KB 65.5K 671 89

BestBlogs 早报 · 09-23|Claude Opus 5.5 发布,MiMo-V2 扩展强化学习,美团分享统一推荐基座大模型实践

本期早报精讲三条内容:Anthropic 发布 Claude Opus 5.5,能力接近上代旗舰而成本下降 40%,并强化行动控制与可审计机制;小米发布 MiMo V2.6,通过更大的 Batch、全异步架构和可验证任务环境扩展强化学习,并开源训练框架与轻量 Harness;美团分享 MTFM 统一推荐基座在外卖多业务场景的落地,通过异构 Tokenizer 与混合注意力实现跨业务统一建模,订单量提升 2.06%-6.68%。速览涵盖腾讯工程师转型大模型推理、AI 产品评估实践、Agent Harness Skill Engineering、去哪儿网 AI Coding 重构、千问办公企业上下文、算力芯片趋势及 OpenAI 第三方评估原则。

技术 › LLM ginobefun 2026-09-2322.4 KB 2.9K 3 83

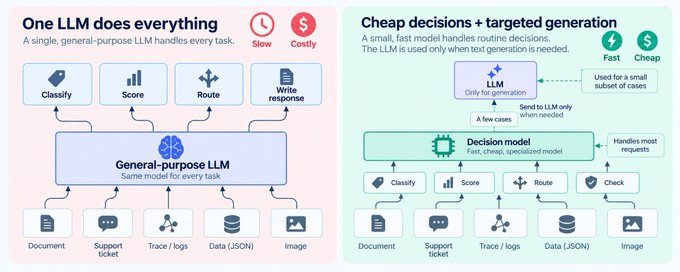
Will TypeSafe's Jev change how we build AI applications?

文章分析了 TypeSafe 发布的新模型 Jev——一种只能做分类、评分和路由决策、不能生成文本的'System One'模型。Jev 比通用 LLM 快 40-200 倍、便宜 40-400 倍,通过 RLCD 训练方法实现零样本概率判断。早期独立测试显示其准确率接近 GPT-5.6 等大模型,垃圾邮件分类甚至可媲美有标注训练的分类器。代价是失去了解释能力,无法说明判断理由。作者认为这可能改变 AI 应用架构:用 Jev 做大规模廉价监控评估,用 LLM 判官处理少量样本以获取改进方向信号。

技术 › LLM Aparna Dhinakaran 2026-09-1912.8 KB 15.2K 202 78

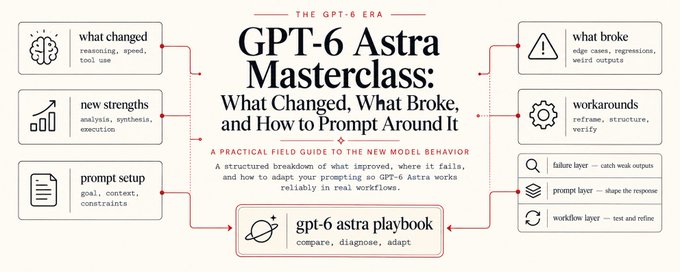
GPT-6 Astra Masterclass: What Changed, What Broke, and How to Prompt Around It

GPT-6 Astra于2026年9月3日发布,带来了计算机使用范式的重大转变,在ARC-AGI-3等基准测试中表现优异。然而,用户面临会话限制快速耗尽、访问权限受限以及回归问题等实际挑战。本文详细介绍了Astra的改进与问题,并提供了针对会话限制、受限访问和计算机使用范式的具体提示调整策略,帮助用户在生产环境中有效使用该模型。

技术 › LLM CyrilXBT 2026-09-0925.5 KB 313.7K 222 83

GLM-5.3 开放发布:通往网络防御的负责任之路

本文介绍了 Z.ai 公司发布 GLM-5.3 模型的情况,该模型在网络安全任务上表现显著提升,如漏洞发现、利用分析和多步安全任务。文章强调了负责任开放的重要性,采取分阶段发布策略,并介绍了安全评估、披露流程和防御性安全措施,旨在平衡开放与安全。

技术 › LLM Z.ai 2026-08-1411.2 KB 266.8K 1.9K 71

Agent记忆的进阶:从记住到学会再到做得成

本文深入探讨了Agent长期记忆的复杂性,指出仅记住历史并不足够,还需处理信息过期、判断变更、反馈应用及错误回滚等问题。作者通过Alloomi的Holistic Context和Self-Evolving Agent技术报告,阐述了如何通过组织实体时间线、经验筛选与后训练,实现Agent从记忆到学习再到实际交付的进化。文章强调,真正的数字员工应具备经验迁移、状态理解和受控进化能力,并提出了三层评估框架。

技术 › Agent Yanhua 2026-08-1314.5 KB 7.4K 50 78

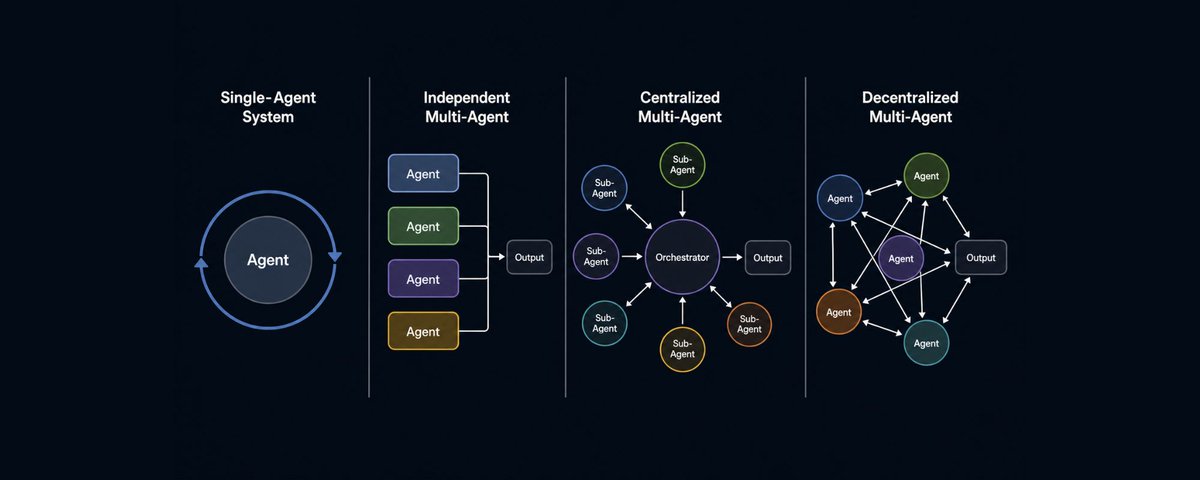
四大 Agent 编排模式详解

本文探讨了单提示词 LLM 工作流的局限性,并介绍了 NYU 研究者测试的四种多 Agent 编排架构:顺序流水线、并行分发合并、分层主管-工人模式以及反思式自纠循环。文章详细分析了每种模式的技术原理、优缺点、Token 效率及适用场景,指出分层模式在成本与精度间最平衡,而自纠模式虽精度最高但成本高昂且难以扩展。

技术 › Agent AlphaSignal AI 2026-05-0611.0 KB 18.5K 249 82

The Self-Healing Agent Harness

文章介绍了作者开发的“自愈 Agent Harness”系统,该系统通过 AI 代理实现了自动化评估和修复闭环。它包含三个核心组件:用于实时评分的三法官评审团、将低分转化为修复工单的工程管道,以及由 AI 评分控制发布的灰度发布机制。这一系统替代了传统的 QA 和人工审查,使团队能够在每天发布 3-8 次的高频节奏下,自动发现并修复模型幻觉、工具契约漂移或基础设施故障等问题。

技术 › Harness Engineering Peter Pang 2026-04-2831.9 KB 168.9K 1.1K 75