Wiki 知识库

全部文档 / 标签: 测试

18 篇
清除

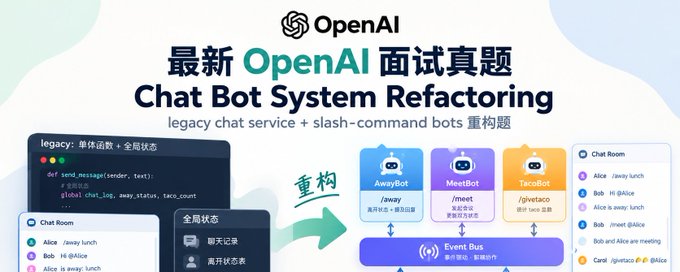
最新OpenAI 面试真题:Chat Bot System Refactoring(legacy chat service + slash-command bots 重构题)

本文解析一道 OpenAI 面试真题:重构一个基于斜杠命令的 legacy 聊天服务(含 AwayBot、MeetBot、TacoBot)。作者提出五步解法:先冻结旧行为并编写黄金测试,再定义 should_activate/execute 接口分离判断与执行,为全局状态找到归属组件,比较直接调用与事件总线两种协作方案并给出迁移顺序,最后单独提交行为修复。文章附有最小事件驱动实现的完整 Python 代码,并讨论了事件时序、bot 注册顺序、测试策略等细节。

技术 › OpenAI 山景城小路 2026-10-1415.2 KB 2.8K 37 83

Verification Engineering 时代

文章探讨 AI Native 组织中 Verification(验证工程)正成为关键工程环节。当 AI 和多个 agent 高频生成并提交代码时,验证速度和可靠性成为新瓶颈。作者提出设立专门的 Verification Engineer 岗位,并分享实践:用 Rust 工具链缩短反馈时间、程序化 E2E 分层、agent 定期真实操作巡检、使用 PGlite 减轻环境负担、merge queue 验证合并后代码、mutation testing 验证测试有效性,以及为验证系统本身建立可观测性指标(如反馈耗时、缓存命中率、flaky 测试跟踪),以实现更快、更可信的代码验证闭环。

技术 › DevOps Sanjin 2026-10-038.1 KB 7K 66 86

Joy & Curiosity #101:Agent 时代的编程语言与框架思考

Thorsten Ball 分享了他对 AI Agent 时代编程语言与框架未来的思考。他认为手写代码时代正在终结,框架不再是最大的生产力杠杆,语法和工具易用性变得不再重要,但共享抽象仍有价值。未来重要的是性能、可观测性、可调试性等对 Agent 透明的特性。语言偏好将从'我喜欢'转向'我的 Agent 能用好'。他还探讨了生态系统的变化、测试框架的命运、静态类型的未来等话题,认为 token 成本下降是最强的技术驱动力。

技术 › LLM Thorsten Ball 2026-09-2619.3 KB 9K 98 70

GPT-6 官方推荐的 11 段提示词:不知道怎么用,就从这里开始

OpenAI 在 GPT-6 Astra 发布时提供了 11 段官方提示词,帮助用户减少模型中途停顿、跑偏和套话问题。作者将其按场景整理为中文版并附英文原文,涵盖五大类:主动性与持续推进(让模型自主完成任务、先准备成果再请求批准)、指令遵循(用户指令优先于 Skill、冲突时说明规则)、表达与写作风格(先讲重点、按读者调整细节、删除套话与模板表达)、子代理任务分派(并行委派、消息可读性)以及测试与验证(测试范围与改动相称)。涉及文件修改、部署等条目需在 Codex、API 或 Agent 环境中使用。

技术 › OpenAI 苏乐 2026-09-0820.0 KB 230.5K 628 82

OpenAI 官方的 GPT-6 Astra 提示词

本文整理了 OpenAI 官方针对 GPT-6 Astra 模型发布的提示词建议。Astra 比 GPT-5.6 Sol 更爱提问,官方给出提示词让其直接执行任务;针对 Skill 过多导致指令冲突的问题,建议定期检查上下文文件并明确优先级,可让模型指出受哪条规则影响;此外 Astra 在代码任务上容易过度测试,官方建议只在发现新失败或风险时扩大测试范围。作者认为 Astra 是相对完善的模型,但与 fable5.1 相比仍有差距。

技术 › OpenAI Aron厚玉 2026-09-073.3 KB 12.8K 96 79

用 Eval 工程测试 AI Agent 的 6 种方法

文章指出传统确定性单元测试无法覆盖 AI Agent 的多轮、非确定性行为,提出将评估视为可自动化、可度量的 CI/CD 测试套件。作者给出 6 种生产级 Eval 实践:1)先做确定性 schema 检查(JSON 有效性、工具调用参数);2)用 Check Grounding API 等数学化度量事实依据,低于阈值即拒绝输出;3)检查多轮工具调用轨迹的依赖顺序并惩罚循环调用;4)构建带严格评分标准、输出推理过程的 AutoRater 评审模型;5)用 AutoSxS 成对对决和胜率数据安全替换模型;6)在 CI 中建立黄金回归数据集作为硬门禁。文中提到 Firebase 团队借此将复杂多步任务通过率从 31.7% 提升至 78.0%。

技术 › Agent Praveen Rajasekar (Google Cloud Tech) 2026-09-047.1 KB 32.9K 318 81

workbuddy创建skill攻略!以客户访谈摘要作为示例,完整拆解一份可验收Skill应该包含什么

本文以客户访谈摘要为例,详细拆解了在WorkBuddy中创建一份可验收Skill的完整流程。文章指出,仅保存提示词的Skill无法复用,必须包含输入合同、触发条件、执行步骤、输出合同和失败策略五段合同。作者通过正常、异常和对抗样本的测试方法,以及团队复用时的版本管理和权限控制,强调了从人工SOP出发、逐步固化和测试的重要性。最终目标是沉淀团队能力,而非简单的提示词收藏。

技术 › Skill FlowOps Daily 2026-08-207.6 KB 1.4K 16 82

Skills 从入门到精通

本文全面介绍了 Agent Skills 的概念、创建、扩展、测试及企业级应用。作者从最小 Skill 的构建开始,逐步讲解如何拆分文件、接入知识库与 MCP、管理多个 Skill 与 Agent 的协作,并讨论了大型 Skill 的潜在问题与测试方法。最后,文章强调了企业级 Skill 的安全分级、评测与治理,旨在帮助读者从零开始掌握 Skill 开发,并避免常见误区。

技术 › Skill Miles Ma 2026-08-1920.4 KB 141K 615 84

I Thought Grok Bot Was Hype. Then I Tested It on 5 Businesses.

作者在五个业务中测试了 Grok Bot,发现它并非单纯的 hype,而是填补了“全天候代理”的空白。相比专注于深度工作的 Session agents 和积累知识的 Server agents,Grok Bot 更适合夜班工作,如社区管理、内容监控和 QA 测试。作者保留了现有技术栈,将 Grok Bot 作为夜班员工使用,认为其在特定场景下极具价值。

技术 › Agent Prajwal Tomar 2026-08-1714.9 KB 322.3K 235 82

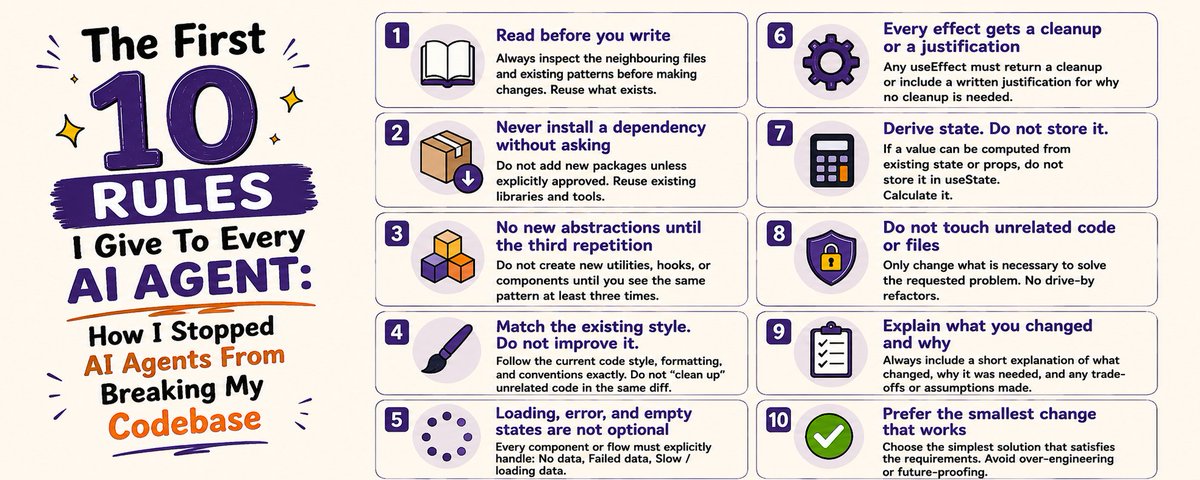
The First 10 Rules I Give To Every AI Agent: How I Stopped AI Agents From Breaking My Codebase

AI coding agents can introduce bugs and break codebases without clear constraints. This article presents ten practical rules to guide AI agents, such as reading before writing, avoiding unnecessary dependencies, matching existing style, handling loading/error/empty states, and requiring explanations for changes. These rules help channel agent capabilities safely, reducing breakage and improving reliability.

技术 › Agent Kanika 2026-08-1211.9 KB 26.8K 30 81

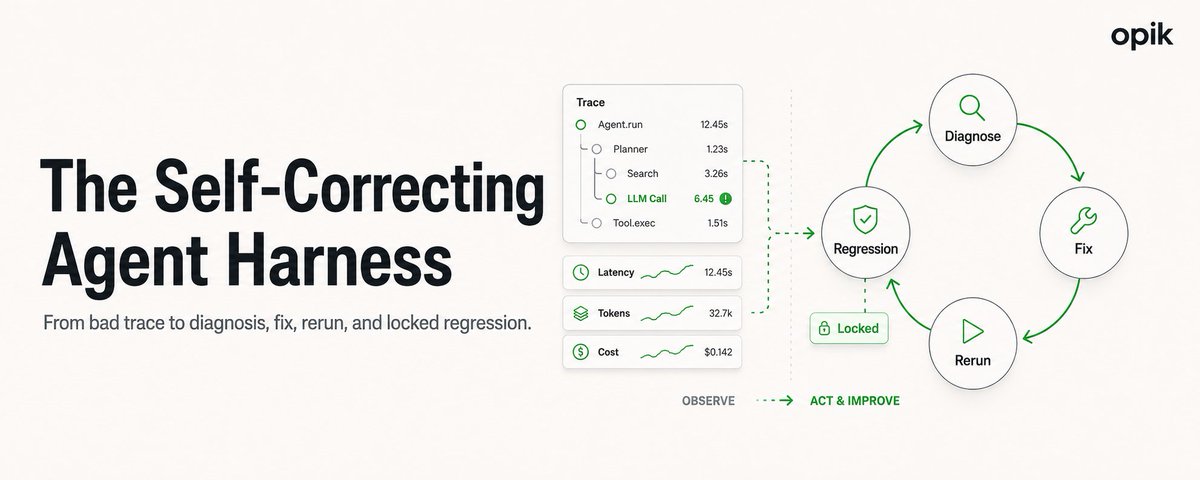
你的 Agent 框架应该能够自我修复

文章探讨了AI Agent在生产环境中失败时,传统可观测性工具仅能提供追踪数据,而无法自动解决修复问题的瓶颈。作者介绍了开源平台Opik,它通过四层架构(Tracing追踪、Ollie诊断与修复、Test Suites测试集、Agent Sandbox沙盒)形成闭环。该平台能自动诊断错误链路,内置代码代理提出修复方案,并将真实失败转化为回归测试,从而实现Agent框架的自我修复与持续优化。

技术 › Agent Akshay 2026-08-099.9 KB 1.8M 1.6K 84

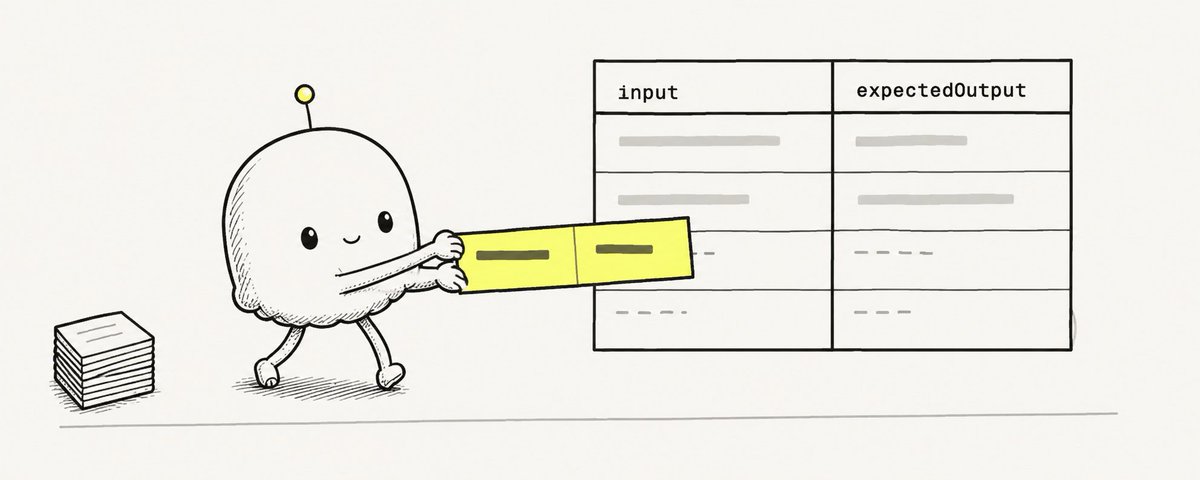
如何设计与构建 AI Agent 评估数据集

当应用仅靠直觉调试无法满足需求时,构建评估数据集至关重要。本文详细介绍了设计AI Agent评估数据集的五个核心步骤:1.明确数据集的最小目标;2.检查生产记录、现有资产等可用数据源;3.规划输入分布,合理搭配场景与难度;4.决定评估机制,选择基于参考或无参考的评估方式;5.定义包含输入、预期输出和元数据的结构化项目模式。通过迭代设计,确保系统质量可量化和持续改进。

技术 › Agent Annabell 2026-08-0714.3 KB 25.5K 80 83

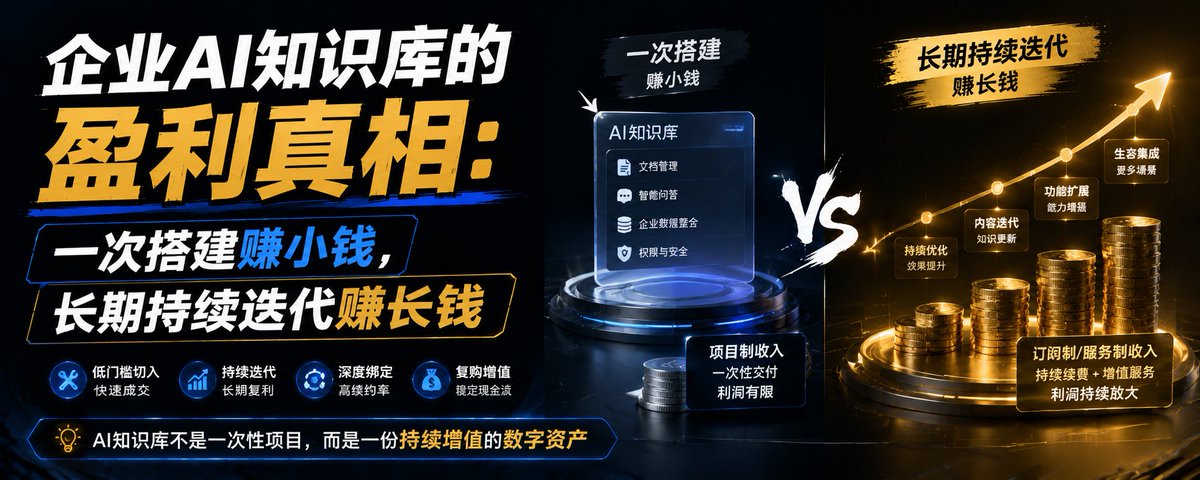
企业AI知识库的盈利真相:一次搭建赚小钱,长期持续迭代赚长钱

文章指出企业AI知识库上线后常因资料维护不当失效。建议初期不直接搭建整套系统,而是通过资料体检和错例维护切入。通过建立台账、编写测试卡、固定错例修复流程,将一次性搭建转化为持续盈利的月度服务,确保知识库长期有效。

技术 › LLM Christal.Z 2026-08-045.8 KB 751 2

如何递归地改进你的智能体

文章介绍了一种递归自动改进智能体(RAI)的方法。通过使用编码智能体分析指令、挖掘使用数据并运行探测,测试并修复目标智能体,直到符合规范。文章详细阐述了实现该循环所需的系统设置、平台搭建步骤以及“创建-改进-扩展-部署”的全新开发生命周期。

技术 › Agent Ashpreet Bedi 2026-08-047.2 KB 85.9K 564

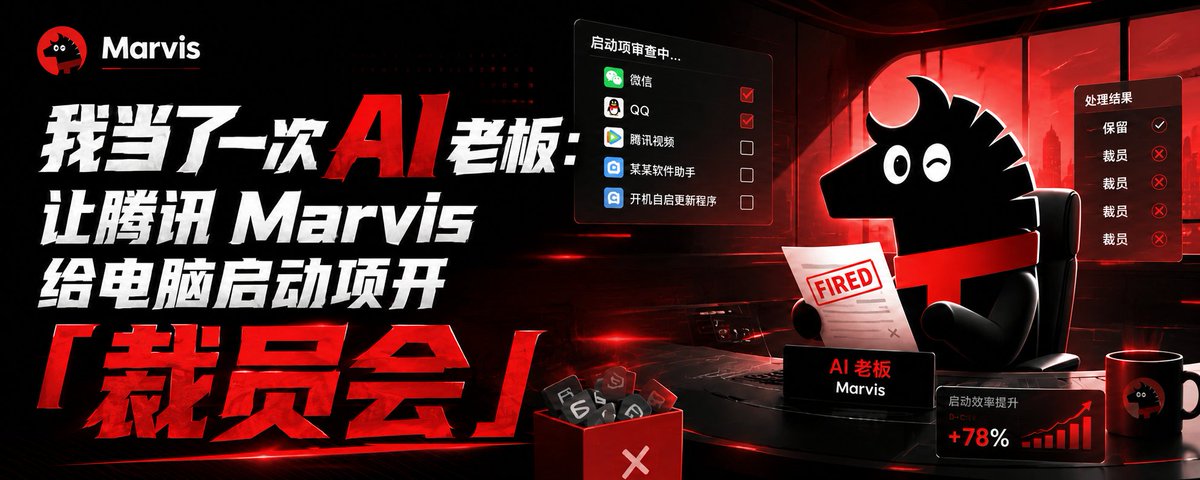
我当了一次 AI 老板:让腾讯 Marvis 给电脑启动项开「裁员会」

文章介绍了腾讯新推出的操作系统级 AI 助手 Marvis(马维斯)。作者体验了其独特的“AI 办公室”UI 设计,该设计将不同的 Agent 视为员工,直观展示任务进度。作者测试了让 Computer Agent 分析电脑启动项并进行优化的流程,认为虽然目前存在限制,但其可视化的交互方式降低了 Agent 使用门槛。

技术 › Agent Florian.C 2026-05-265.3 KB 11K 20 74

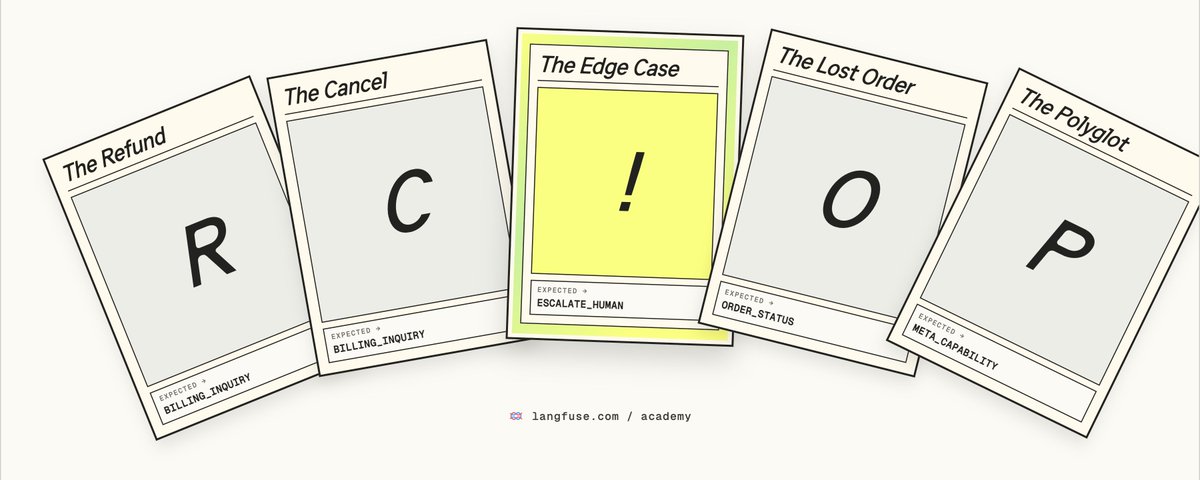
Designing eval datasets for LLM applications

本文是 Langfuse Academy 系列的一部分,深入探讨了 AI 工程生命周期中的数据集设计。文章解释了数据集如何连接生产监控与开发迭代,详细介绍了数据集项的三个核心字段(输入、期望输出、元数据)及不同的评估模式。此外,文章还分享了构建高质量数据集的最佳实践,包括如何定义范围、确定规模,以及如何从生产 Trace、手工编写和合成数据中起步。

技术 › LLM Lotte 2026-05-186.3 KB 39.8K 321 80

我测试了 247 个 Claude Skills 并删掉了 224 个:留下的这 23 个改变了我的工作方式

作者花费 6 周时间实测了 247 个 Claude Skills,基于质量提升、效率节省和上下文开销等标准,最终仅保留了 23 个。文章详细列出了 S 级必装工具(如 frontend-design, superpowers)和 A 级垂直领域工具,并给出了安装顺序建议。

技术 › 工具与效率 Mnimiy 2026-05-0635.7 KB 253.8K 971 92

如何真正防止 Agent 重复犯错:Skillify 实践指南

本文批评了 LangChain 等框架虽有工具但缺乏工作流,导致 AI Agent 测试困难。作者提出“Skillify”模式:通过构建包含确定性代码和单元测试的 Skill(技能),将潜在的 LLM 推理转化为确定性的工具调用。文章以日历查询和时区计算为例,展示了如何利用“薄框架、厚技能”架构,永久修复 Agent 的重复性错误。

技术 › Agent Garry Tan 2026-04-2246.7 KB 947.1K 1.7K 84