Wiki 知识库

全部文档 / 标签: PyTorch

13 篇
清除

现在普通人也能从零训练一个 Reasoning Model 了

Sebastian Raschka 公开了一套完整课程《Building Reasoning Models from the Ground Up》,包含 8 节视频、11+ 小时内容,基于 Qwen3 0.6B 小模型,用 Python + PyTorch 实现现代推理模型的关键技术,包括 Inference-Time Scaling、Verifier、GRPO 强化学习、KL/Clipping 训练稳定性控制、Reward Hacking 以及基于 DeepSeek-R1 数据的推理蒸馏。课程让学习者可以亲手运行训练循环,观察模型生成推理路径、根据奖励更新参数的全过程,大幅降低了理解推理模型的门槛,使推理模型训练从少数实验室技术变为可动手验证的工程知识。

技术 › LLM lifcc (@mylifcc) 2026-10-261.9 KB 73

Sebastian Raschka 免费视频课:从零构建推理模型

《从零构建大模型》作者 Sebastian Raschka 推出 8 集共 11 小时的免费视频课,配合新书《从零构建推理模型》,教你用 PyTorch 基于 Qwen3 0.6B 从零实现推理模型。课程内容涵盖 KV cache、数学答案验证器、self-consistency 多数投票、自我修正、简化版 GRPO(RLVR)训练、reward hacking 以及 DeepSeek R1 蒸馏。前几集 CPU 或 Mac Apple 芯片即可运行,只需会 Python 和 PyTorch 即可直接学习。视频与代码仓库均已开源。

技术 › LLM 耳朵 (@RookieRicardoR) 2026-10-252.5 KB 70

手把手带你解锁 N 卡隐藏算力(Linux|RTX 30 系部分型号、4090、4070 Ti SUPER)

作者分享了 Linux 下使用 gpu-unlock 项目解锁 NVIDIA 显卡 Tensor Core 算力限制的实践。该项目通过在驱动加载前修改控制运算速度的寄存器,解除 FP16/BF16 输入、FP32 累加运算的限速。作者在 RTX 4070 Ti SUPER 上用 Codex 辅助完成兼容性检查、编译模块、创建实验启动项和断电重启等步骤,实测 8192×8192 矩阵 FP16 乘法耗时从 12.15ms 降至 6.49ms,吞吐接近翻倍至约 190 TFLOPS,且数值校验通过。社区反馈该解锁可使本地大模型 prefill 提速 30%–50%,decode 速度基本不变。

技术 › 工具与效率 铁锤人 2026-10-259.3 KB 57.9K 105 83

读 2.83% 的 key 就够了

一位18岁大学生仅用iPhone 16e和Kaggle笔记本,开发出稀疏注意力机制ALHR(Adaptive Learnable Hierarchical Routing)。该方法通过给key矩阵构建静态二叉树,配合预算预测器、邻居搜索和树下降三步推理,让每个query只读取所需key。在1024 token的MQAR测试中,仅读取2.83%的key即可达到92.1%准确率(稠密基线94.9%),KV压缩35.3倍。训练分三段:先训稠密教师模型,再用其注意力矩阵标注top-k key训练树模块,最后无教师联合训练。目前因未做kernel优化比稠密注意力慢约10倍,代码由Claude Sonnet 5.5生成,Apache-2.0开源。

技术 › LLM yibie 2026-10-105.0 KB 1.3K 2 76

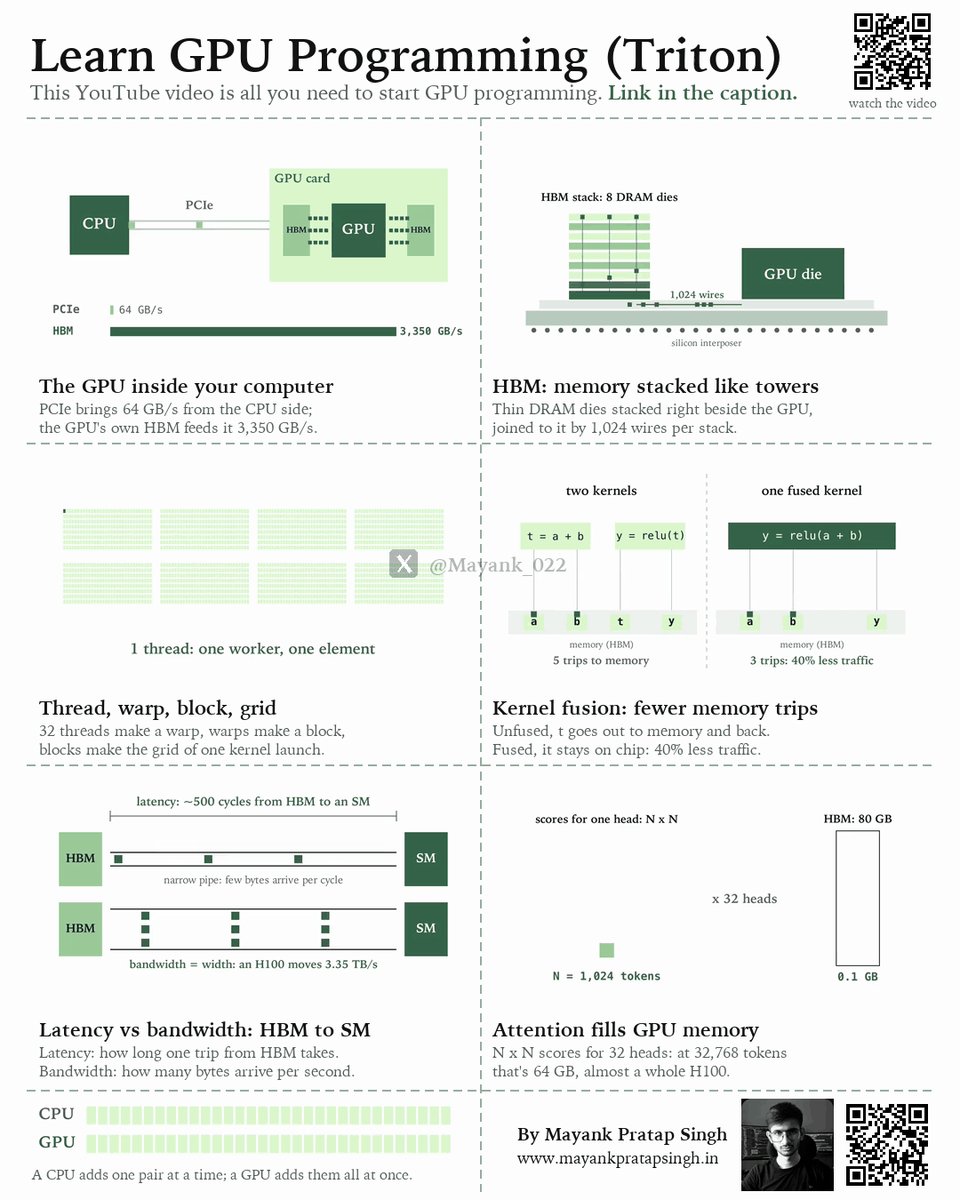
用一部全动画视频开始学习 GPU 编程(Triton 系列)

作者发布了一个全动画形式的 GPU 编程系列讲座首集,时长约一小时,通过可视化方式讲解 GPU 工作原理。内容涵盖:GPU 在计算机中的位置(PCIe、NVLink、集群)、NVIDIA H100 内部结构(SM、张量核心、共享内存)、线程/warp/block/grid 概念、内存体系(SRAM、DRAM、HBM、缓存)、延迟隐藏与核融合等优化技术,以及 Triton 的设计理念。还介绍了 FlashAttention 如何优化注意力计算。讲座无需 CUDA 或硬件背景,后续将推出 Triton kernel 编写和推理优化等课程。

技术 › 编程语言 Mayank Pratap Singh 2026-10-053.0 KB 56

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

万字长文!读懂模型微调的基本概念和名词

本文系统梳理了模型微调的核心概念与术语。作者首先解释了微调的意义:在预训练模型基础上,用任务相关数据继续训练,使模型更适应特定表达、任务或指令,减少幻觉。随后从五个层面展开:模型训练阶段(预训练、基础模型、后训练、微调);训练原理(SFT、指令微调、下一个token预测);训练框架与工具(PyTorch、容器、训练方案);LoRA相关技术(PEFT、QLoRA、rank、alpha、target modules);数据与训练参数(语料、数据集、batch size、学习率、过拟合、eval loss等)。文章以DGX Spark本地微调Gemma为例,帮助读者理解微调全流程。

技术 › LLM Roland.W 2026-09-0120.3 KB 32.5K 85 71

OpenRLHF 作者发布 Agentic RL 框架 Molt:9K 行核心代码支持超大规模 MoE 训练

OpenRLHF 作者发布了新的强化学习框架 Molt。该框架采用纯 PyTorch 栈,核心代码仅约 9000 行,专注于 Agentic RL 研究。它支持 Qwen3.5-397B 到 GLM-5.2 753B 等超大规模 MoE 模型训练,无需依赖 Megatron,具备高度的代码可读性和可修改性。

技术 › LLM 青稞社区 2026-07-1610.2 KB 9.5K 81

PyTorch 训练流程速查表

这是一份关于 PyTorch 训练流程的单页速查表。文章通过代码示例和原理解析,深入浅出地讲解了张量的核心概念、矩阵乘法、自动求导机制、反向传播以及梯度下降优化过程。同时涵盖了 `nn.Module` 常用组件如 Linear、ReLU 和 GELU 的使用,旨在帮助开发者快速理解深度学习引擎的运作原理。

技术 › 编程语言 k kozue 2026-07-0312.0 KB

机器学习大神批判高校 AI 教学:fast.ai 的自顶向下革命

文章批判了当前大学 AI 教育重理论轻实践、先筑高数门槛的弊端,认为这应像学骑车一样先上手。介绍了机器学习大神推出的免费课程 fast.ai,采用“自顶向下”教学法,首节课即通过实战让模型上线,强调产品交付能力优于学术头衔,旨在打破学术精英主义,普及实用技能。

技术 › LLM 墓碑科技 2026-07-022.3 KB

AI/ML 所需的线性代数知识(完整路线图)

本文旨在消除从事 AI/ML 工作对数学博士学位的恐惧,提供了一份精准的线性代数学习路线图。文章分为五个阶段:从标量、向量、矩阵等基础概念,到特征值、SVD(奇异值分解)等核心机器学习数学工具,再到连接微积分的梯度与雅可比矩阵。作者强调了掌握这些概念对于理解神经网络、PCA、推荐系统及 LoRA 微调等技术的重要性。

技术 › LLM vixhaℓ 2026-04-2424.4 KB 106.9K 1.3K 79

900万参数,130行代码:从零构建微型语言模型 GuppyLM 教程

本文介绍了开发者 arman-bd 开源的微型语言模型 GuppyLM。该模型拥有 900 万参数,核心代码仅 130 行,可在免费 Colab 上 5 分钟训练完成。文章详细拆解了构建流程:利用模板生成 6 万条合成数据、训练 4096 词表的 BPE 分词器、搭建 6 层 Vanilla Transformer 架构以及优化推理环节。该项目旨在通过极简的实现,帮助开发者深入理解语言模型的数据工程、架构设计与训练循环。

技术 › LLM Jason Zhu 2026-04-077.5 KB 8.5K 74 92