Wiki 知识库

全部文档 / 标签: 推理模型

12 篇
清除

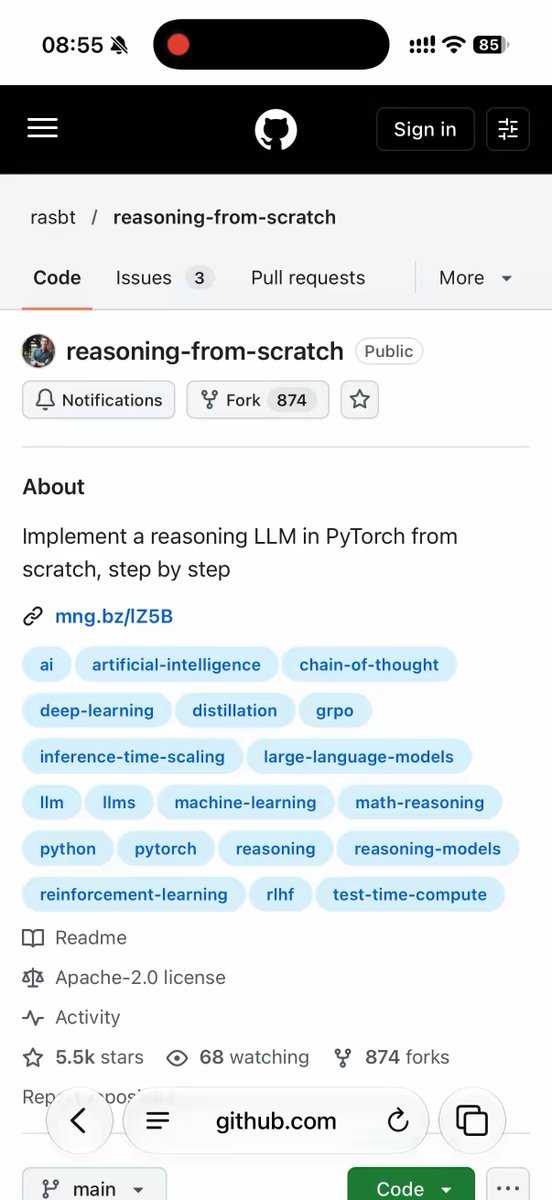
Sebastian Raschka 免费视频课:从零构建推理模型

《从零构建大模型》作者 Sebastian Raschka 推出 8 集共 11 小时的免费视频课,配合新书《从零构建推理模型》,教你用 PyTorch 基于 Qwen3 0.6B 从零实现推理模型。课程内容涵盖 KV cache、数学答案验证器、self-consistency 多数投票、自我修正、简化版 GRPO(RLVR)训练、reward hacking 以及 DeepSeek R1 蒸馏。前几集 CPU 或 Mac Apple 芯片即可运行,只需会 Python 和 PyTorch 即可直接学习。视频与代码仓库均已开源。
技术 › LLM 耳朵 (@RookieRicardoR) 2026-10-252.5 KB 70

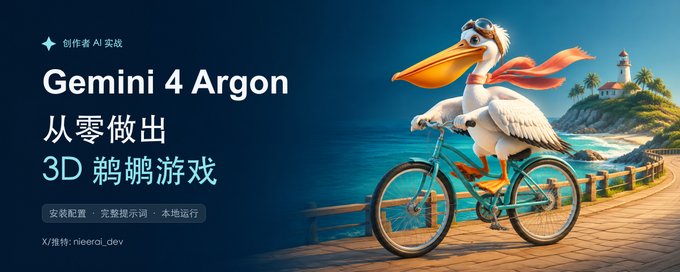
最适合创作者的模型:保姆级教程教你用 Gemini 4 Argon 跑通 3D 鹈鹕游戏

本文是针对 Google 最新旗舰推理模型 Gemini 4 Argon 的保姆级使用教程。文章介绍了使用该模型的两种方式:一是通过 Antigravity 桌面版订阅会员直接使用;二是安装 Gemini CLI 并配合开源工具 CC-Switch 一键导入第三方中转站配置。教程覆盖 Mac 和 Windows 平台,从 Node.js 环境准备、CLI 安装、配置导入到最终提示词发送,全程无需编程基础。作者用一个完整的 3D 鹈鹕骑自行车网页游戏任务作为实战案例,展示 Argon 在空间想象力、几何结构推理和前端代码生成上的能力,并提供了在线试玩地址。

技术 › 工具与效率 聂二AI落地内参 2026-10-1620.3 KB 9.1K 18 74

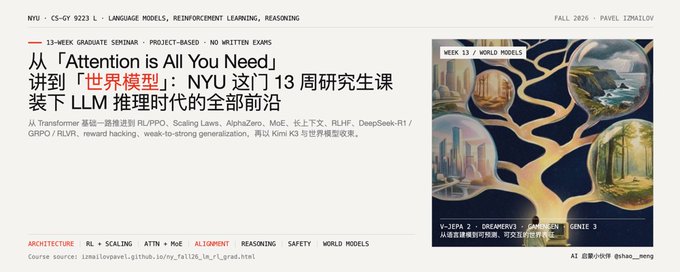
NYU 13周研究生课:LLM推理时代的前沿全景

文章介绍了NYU Tandon 2026年秋季由Anthropic研究员Pavel Izmailov开设的研究生课程《Language Models, Reinforcement Learning, Reasoning》。课程共13周,除Sutton & Barto教材外全部使用原始论文,沿「预训练→架构与训练效率→后训练RL→对齐与安全→前沿与未来」的主线展开,涵盖Attention机制、扩展律、Muon优化器、RLHF、GRPO与RLVR、奖励过优化、可扩展监督以及世界模型等前沿主题。文章分析了课程叙事逻辑,指出RL重回舞台中心、中国实验室工作成为正典、安全对齐被当作工程学科等趋势,并给出自学者建议。

技术 › LLM meng shao 2026-10-0512.9 KB 7.9K 72 80

System One Models: What Comes After Agentic Software

文章介绍 TypeSafe 发布的 Jev 模型,一种用于快速语义决策而非生成或长推理的 System One 模型,延迟低至 70ms 且成本低廉。作者认为这类模型可将小型语义智能分散嵌入应用的各个决策点,而非集中于 Agent 循环中,从而推动微推理时代的到来。这将使代码库中包含更多非确定性判断,同时应用层更明确地掌控编排控制流,推理模型则退居处理模糊和复杂案例的升级路径。文章还探讨了围绕微推理所需的基础设施(批处理、缓存、模型路由),并以自动驾驶和 Waymo 的 ML-primary 架构类比这种通用语义模型进入控制循环的新范式。

技术 › LLM Josh Rosen 2026-09-1710.9 KB 14.2K 181 71

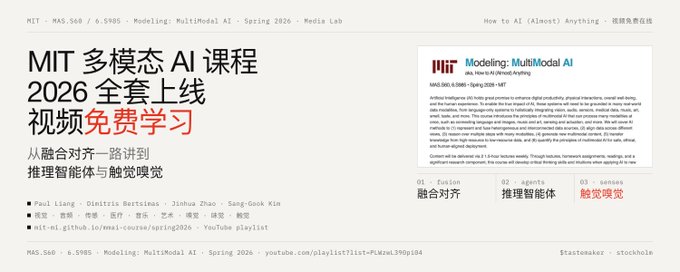
MIT 多模态 AI 课程 2026 版全套上线:视频免费在线学

MIT 由 Paul Liang 主讲的《How to AI (Almost) Anything / Multimodal AI》2026 春季课程全套视频免费上线。课程涵盖多模态学习完整技术栈:异构数据表示与融合、跨模态对齐、多模态生成、推理(RLHF、DeepSeek-R1、DPO)、智能体、跨模态迁移,以及触觉、嗅觉等新模态与自进化 AI 等前沿方向。相比 2025 版,新增多模态推理、智能体、自进化 AI 模块及制造、城市、交通等应用课。适合有机器学习基础的学习者系统建立多模态 AI 知识框架,课程网站与 YouTube 播放列表均可免费访问。

技术 › LLM meng shao 2026-09-089.9 KB 63.9K 32 82

异类的心智:当机器比人聪明,人还剩下什么

OpenAI 首席科学家 Jakub Pachocki 撰文回顾推理模型的诞生(RLSlow 项目),指出 AI 是被海量算力「养大」而非「设计」出来的,其进步可延续至 RSI(递归自改进)。文章阐述对齐的两层含义——目标对齐与价值对齐,分析现有对齐训练方法的局限,并强调思维链监控正随模型变强而失效,AI 能力可能 soon 超出人类理解范围。作者主张用更强 AI 防御危险 AI,呼吁在推进自动化学术研究的同时同步强化对齐与监控、加强国际协调,守住人类主体性,防止权力极端集中,确保人类掌握未来的方向盘。

技术 › LLM Jakub Pachocki(Orange AI 翻译) 2026-09-0711.0 KB 8.6K 13 76

Token工程的四大实用支柱:超越提示压缩的成本优化

本文介绍了在大规模AI应用中优化token成本的四大实用支柱:一是上下文缓存与Agent循环修剪,通过裁剪中间工具输出和总结历史步骤保持提示精简,利用缓存可获最高75%的输入折扣;二是实时与批量推理,将非紧急任务如工单汇总、报告生成等打包为异步批处理,可享50%折扣;三是设置思考预算,避免推理模型在简单任务上消耗数千隐藏思考token;四是模型合理选型与持续评估,90%的任务应使用最小最便宜的模型,并通过自动化评估及时更换高效模型,配合Apigee AI Gateway等企业网关实现智能路由与安全防护。

技术 › LLM Google Cloud Tech 2026-08-227.4 KB 36.7K 345 77

蒸馏风暴:AI 公司不愿公开谈论的技术竞赛

本文深入探讨了 AI 领域中备受争议的“蒸馏”技术。文章追溯了蒸馏从最初的模型压缩方法到如今被用于“蒸馏攻击”的演变过程,分析了其技术原理、规模化实现方式以及引发的伦理与竞争争议。通过访谈多位研究员,文章揭示了蒸馏并非简单的复制,而是涉及复杂系统工程,且不构成长期壁垒。同时,文章也讨论了蒸馏与数据飞轮的关系,以及行业对黑盒与白盒蒸馏的不同态度,呈现了这项技术背后的商业、伦理与竞争图景。

技术 › LLM 晚点 LatePost 2026-08-1329.5 KB 36.6K 75 78

从提示词工程师到全栈 AI 工程师的升级指南

文章反驳了“提示词工程已死”的观点,指出单纯的提示词思维虽已过时,但提示词仍是人机交互的核心。作者旨在将读者从仅会提问的初级用户,升级为具备系统思维的 AI 工程师。文章详细讲解了具体的技能升级路径,包括:如何进行具体且确切的提问、如何设定角色(Role)来界定行为、利用示例来固定输出模式,以及如何正确引导模型的推理过程。

技术 › LLM hoeem 2026-05-2880.1 KB 72.1K 339 70

深度扩展视角:Looped LLM 与 Claude Mythos 架构解析

本文深入探讨了 Looped LLM(循环大语言模型)的演进及其在 Claude Mythos 中的潜在应用。作者从字节跳动实习期间的研究出发,分析了循环架构在多跳推理任务上的优势,并指出 Anthropic 新发布的 Mythos 在 GraphWalk BFS 基准上的异常提升可能与底层状态跟踪能力有关。文章进一步探讨了将 Looped LLM 扩展至大规模应用时面临的“三道门槛”:深度稳定性(借鉴 RNN/SSM 理论解决梯度问题)、推理效率(结合 Diffusion Forcing 和 YOCO 优化并行度)以及单位 FLOPs 的有效性,强调了在算力预算有限时架构选择的重要性。

技术 › LLM Rui-Jie Zhu 2026-04-2230.5 KB 70.4K 292 81

Looped LLM 与深度缩放:解析 Claude Mythos 的架构演变

文章基于作者在 ByteDance Seed 的研究经历,探讨了 Looped LLM 架构的起源与演进。作者通过分析 Anthropic 发布的 Claude Mythos 在 GraphWalk BFS 基准上的异常表现,指出 Looped 架构在多跳推理和状态追踪上的优势。文章进一步深入讨论了 Looped LLM 在扩展至 10T/100T 规模时面临的深度稳定性、推理效率和 FLOPs 有效性的三大挑战,并对比了 RNN 视角与 Parallel Looped Transformer 等解决方案。

技术 › LLM Rui-Jie Zhu 2026-04-2230.5 KB 85

RLMs are the new reasoning models

本文探讨了递归语言模型作为一种新的推理范式的重要性。RLM 通过将模型自己的提示视为可检查、切片和递归查询的环境,直接结合了推理和工具使用。文章回顾了推理和工具使用的历史发展,从思维链到 ReAct,再到 OpenAI o1 和 Claude 的工具使用。最新研究显示,RLM 在长上下文、记忆和长推理任务中表现出色,克服了传统单次前向传播的局限。

技术 › LLM Raymond Weitekamp 2026-04-2147.3 KB 68K 513 65