Wiki 知识库

全部文档 / 标签: 蒸馏

11 篇
清除

Agent Evaluation:难以被 AI 取代的职业方向及 Hugging Face 学习资料推荐

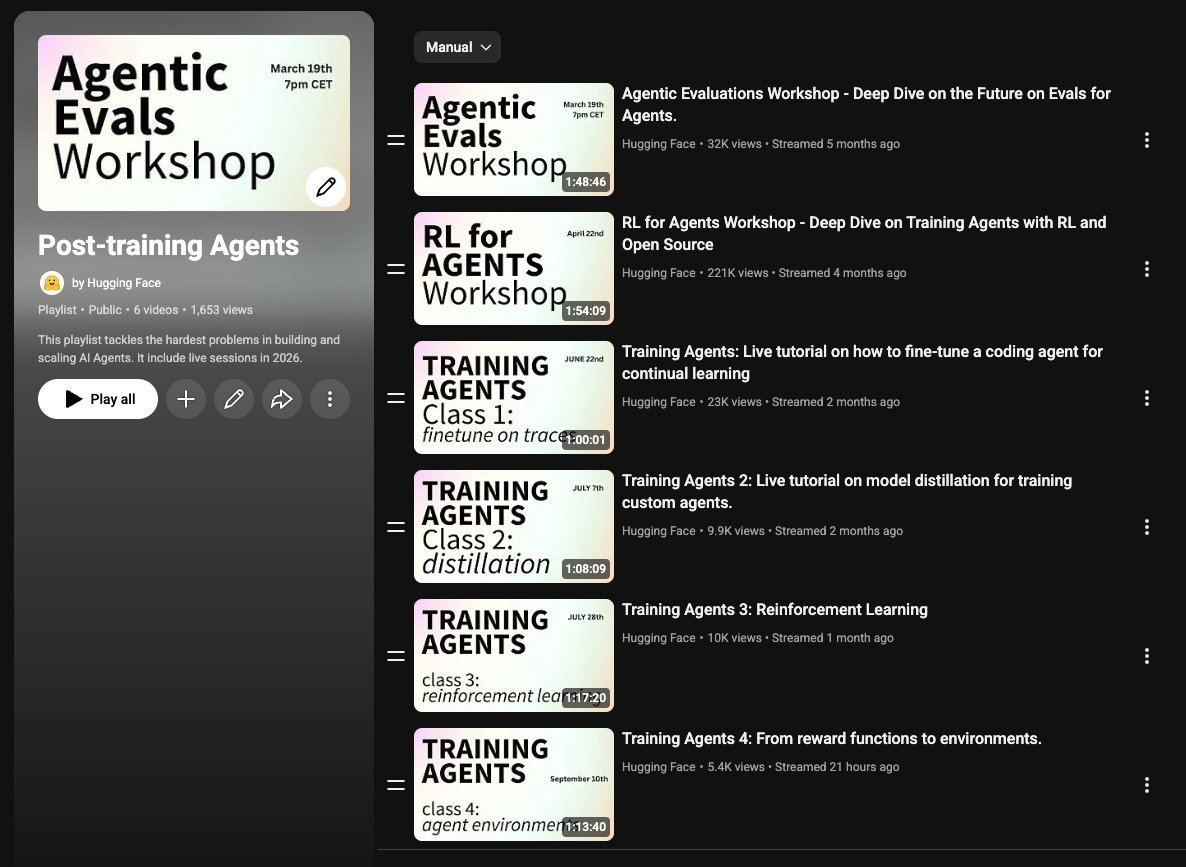
作者认为 Agent Evaluation 是少数仍需人力判断、未来难以被 AI 彻底取代的职业方向,并推荐了 Hugging Face 公开的 Training Agent 课程作为入门资料。课程共六节:1)Agentic Evaluations,讲解如何评估 Agent 及 benchmark 与真实体验的差异;2)Agent 强化学习的难点,包括环境搭建与 reward 设计;3)用 Agent 执行轨迹做 SFT 微调;4)将大模型能力蒸馏给小 Agent;5)SFT 后用 GRPO 继续 RL 训练;6)用 OpenEnv 搭建真实环境并训练 coding agent。视频公开在 YouTube,代码全部开源。

技术 › Agent 美研芒格君 (@Kay2289123) 2026-10-282.5 KB 74

Sebastian Raschka 免费视频课:从零构建推理模型

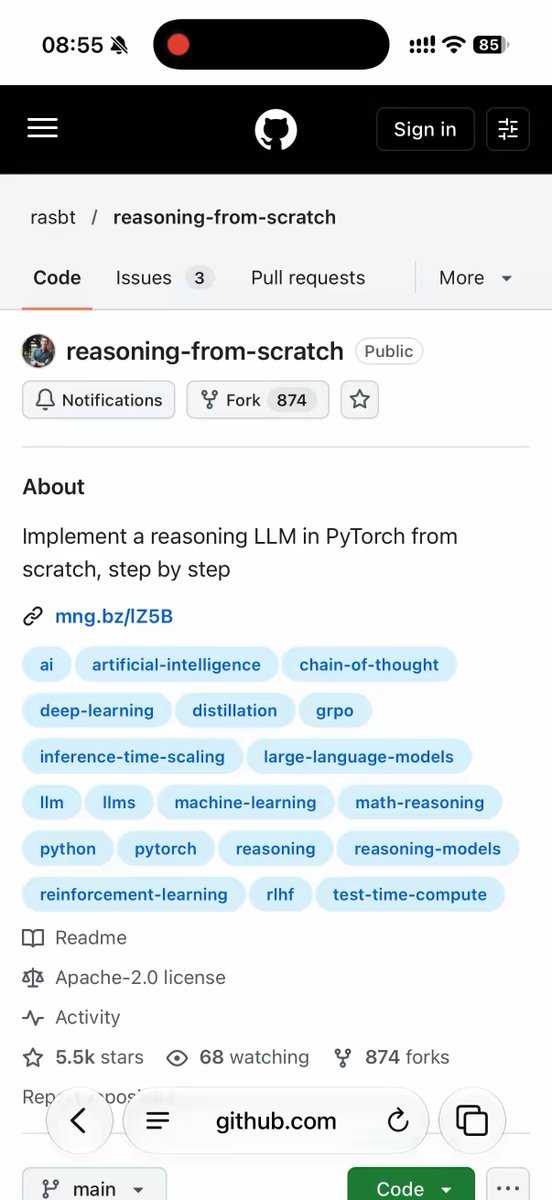
《从零构建大模型》作者 Sebastian Raschka 推出 8 集共 11 小时的免费视频课,配合新书《从零构建推理模型》,教你用 PyTorch 基于 Qwen3 0.6B 从零实现推理模型。课程内容涵盖 KV cache、数学答案验证器、self-consistency 多数投票、自我修正、简化版 GRPO(RLVR)训练、reward hacking 以及 DeepSeek R1 蒸馏。前几集 CPU 或 Mac Apple 芯片即可运行,只需会 Python 和 PyTorch 即可直接学习。视频与代码仓库均已开源。

技术 › LLM 耳朵 (@RookieRicardoR) 2026-10-252.5 KB 70

We're Thinking Too Small About Synthetic Data

本文指出合成数据远不止大规模推理或预训练数据配比设计,而是一个深度的数据研究问题。作者认为生成器本身就是研究课题:并非所有部分都需要 LLM,状态转移模型和离散事件仿真可以通过显式规则生成内部一致的世界历史。同时,人类知识与合成系统应结合——人类帮助设计训练分布、提升内容真实感、补充机器检查的判断盲区。作者以客服 agent 训练为例说明事件驱动仿真的优势,并展望自适应课程设计,认为物理/数学仿真 + LLM + 人类专家的组合将大有可为,应以固定预算下的训练提升来评判生成器。

技术 › LLM Yuhan Luo 2026-10-189.2 KB 33K 611 74

2026年刘韧身边的人怎样用 Claude

作者记录了2026年身边朋友使用Claude的经历:包括自己与两个儿子通过迪拜信用卡付费订阅,以及律师、设计师、编剧、程序员等朋友的使用和封号情况。文章梳理了各人的注册方式、付款途径、使用场景(写文章、法律Skill、PDF翻译等)与封号经过,并整理了X上关于防封的传言与Anthropic的官方规则。作者猜测封号主要与账号身份、付款方式和使用行为有关,而非IP线路。作者希望这份记录能像他早年的IT历史文章一样,为未来留下2026年中国用户使用Claude的真实样本。

技术 › Claude 刘韧 2026-10-1613.9 KB 5.5K 6 71

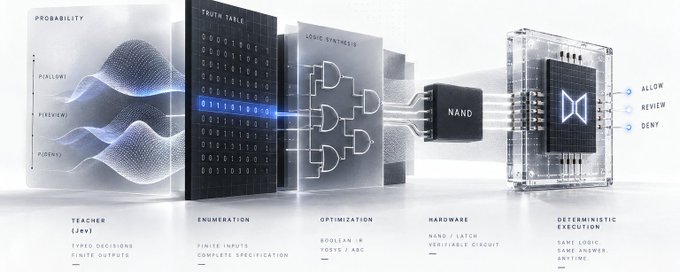
概率怎样变成机器|TapeOut x Jev 系列研究 ver 2.

本文探讨如何将概率决策转化为可验证的硬件电路。核心论点:当决策面可被完整枚举为有限输入输出时,应优先将函数表直接综合成逻辑电路,而非先训练学生模型。文章区分了真值表综合与 DiffLogic/LGN 近似蒸馏两条路线,分析了离散化落差、argmax 造成的概率语义损失、概率 codebook 设计,以及从硬门网络到 NAND 网表的完整编译链(Canonical Boolean IR、Yosys、ABC 等价验证)。通过 LoomEscape-16 案例展示了精确综合的纪律性优势,并指出五种失败条件:输入映射、教师保真、概率校准、实现等价与状态语义。

技术 › LLM BruceBlue 2026-09-2316.6 KB 2K 15 81

如何设计有效的知识库?

文章讨论了如何搭建真正对 AI 协作有用的个人知识库。作者认为对通用内容做无脑模板蒸馏价值有限,知识库的关键在于加入个人增量:聊天记录、人生经历、收藏的筛选理由与批注、任务复盘等。文章具体介绍了四套流程:微信聊天记录的本地脱敏与全量地图提取、AI 人生回顾式采访、收藏内容的分层入库与横向比对、按事实-原因-规则三层复盘。这些方法被封装为 lab-wx-distillation、lab-life-reviewer、lab-intake、lab-retrospective 四个 Skill,配合 Lab Ontology 系统组织检索,让知识库成为个人经历与判断的长期上下文。

技术 › Agent Lab 305 2026-09-1717.9 KB 8.5K 70 85

这个skill,可以复刻任意写作风格

前文字记者作者介绍了自己开发的「写作蒸馏器.skill」,一个可以复刻任意写作风格的 Claude Skill。该工具基于语言学研究方法,将写作风格拆解为六层:词汇统计、文章结构、选题逻辑、视角、认知世界观以及配图排版,通过量化统计和逐篇标注的方式蒸馏出可复用的风格规则档案。使用流程分三步:准备至少20-30篇同体裁完整文章作为素材、让agent自动蒸馏生成Writing-DNA等风格文档、写作时让agent重读风格文件并参考原材料来复现风格。作者对比了蒸馏与微调两种方案,认为小样本场景下蒸馏通过锚定模型注意力更有效。该skill已开源并被超6759人使用,作者也分享了基于它的新写作工作流。

技术 › Skill 躺在废墟里 Lieflat 2026-09-0311.6 KB 83

Own Your Intelligence: 企业自建 AI 能力实战指南

红杉资本团队撰文探讨企业是否应自建 AI 能力而非依赖前沿实验室。开源模型(如 Kimi K3、GLM 5.2)性能逼近前沿,后训练技术栈日益成熟,成本、速度、专有数据与自主掌控成为自建的核心动因。文章给出实践路线图:组建专职团队、公开研究成果,并系统介绍了评估(Evals)、Harness 与上下文工程、后训练(SFT/偏好调优/RL/蒸馏)以及在线学习四个技术步骤,帮助企业在特定领域超越通用前沿模型。

技术 › LLM Sonya Huang 2026-08-1811.2 KB 76.5K 352 79

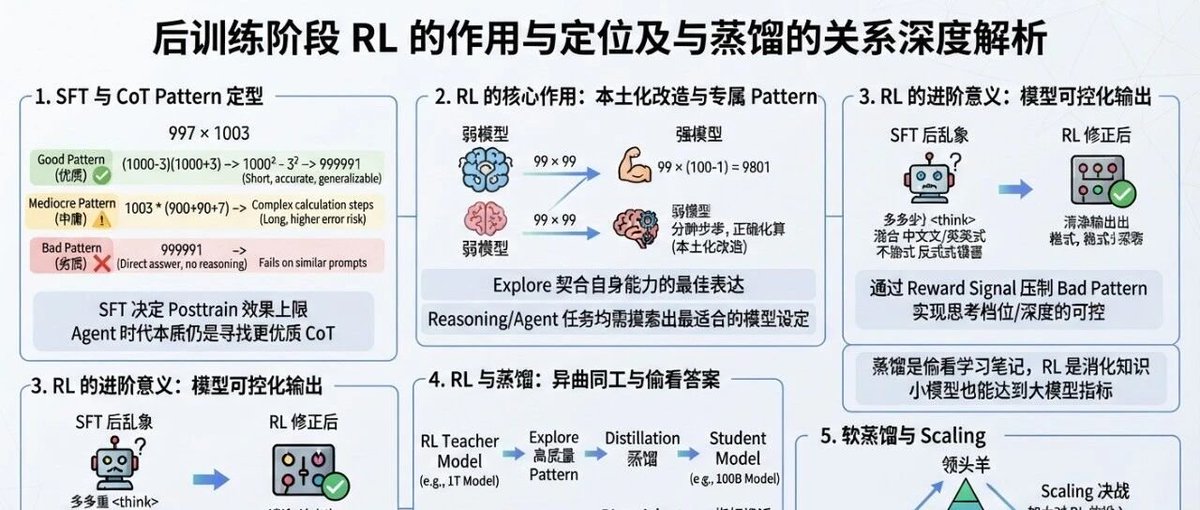
从 RL 到蒸馏,再到软蒸馏:Why RL Matters?

本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。

技术 › LLM ybq 2026-08-1611.6 KB 5.2K 43 73

硅谷AI产业内视角:中美模型竞争、闭源vs开源、Anthropic vs OpenAI

本文通过采访一位硅谷AI创业公司创始人,探讨了闭源与开源模型竞争、中美模型竞争以及Anthropic与OpenAI的竞争格局。受访者认为,闭源模型的壁垒在于数据、上下文和个性化带来的数据飞轮,而开源模型更适合低上下文、低记忆、价格敏感的场景。在高价值场景中,模型智能差异比价格更重要。开源模型目前主要靠蒸馏闭源模型,天花板受限,反超可能性较低。未来竞争的关键在于人才密度、资金和市场,以及是否出现范式突破。

技术 › LLM 憨厚的麦总 2026-08-1513.0 KB 50.4K 117 63

蒸馏风暴:AI 公司不愿公开谈论的技术竞赛

本文深入探讨了 AI 领域中备受争议的“蒸馏”技术。文章追溯了蒸馏从最初的模型压缩方法到如今被用于“蒸馏攻击”的演变过程,分析了其技术原理、规模化实现方式以及引发的伦理与竞争争议。通过访谈多位研究员,文章揭示了蒸馏并非简单的复制,而是涉及复杂系统工程,且不构成长期壁垒。同时,文章也讨论了蒸馏与数据飞轮的关系,以及行业对黑盒与白盒蒸馏的不同态度,呈现了这项技术背后的商业、伦理与竞争图景。

技术 › LLM 晚点 LatePost 2026-08-1329.5 KB 36.6K 75 78