Wiki 知识库

全部文档 / 标签: RL训练

2 篇
清除

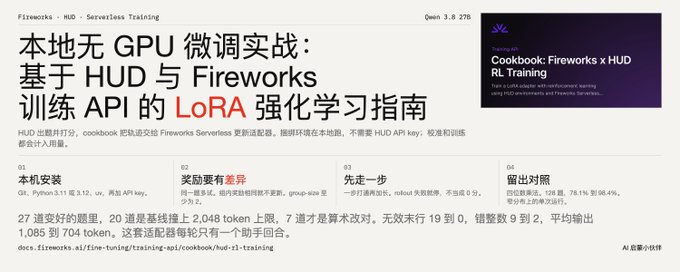
本地无 GPU 微调实战:基于 HUD 与 Fireworks 训练 API 的 LoRA 强化学习指南

本文解读 Fireworks AI 官方 Training API Cookbook 中一篇实战教程,讲解如何结合 HUD 框架与 Fireworks Serverless Training API,在无本地 GPU 条件下用 GRPO 风格强化学习微调 LoRA 适配器。文章详细拆解了四步工作流程:环境配置、任务校准、单步训练和长跑训练,重点阐释了快照隔离、trace 记录、loss masking、组内优势归一化等核心训练机制。实验结果显示四位数乘法任务准确率从 78.1% 提升至 98.4%,但作者指出收益主要来自输出格式和自我节制的优化,而非深层算术能力的提升。文章还提醒了 checkpoint 语义区分等实操要点,并对教程的严谨设计给予高度评价。

技术 › LLM meng shao 2026-09-2610.7 KB 4.7K 36 86

实测MiMo-V2.6:小米347万美元训出的开源模型深度评测

作者实测小米直播后训练的MiMo-V2.6模型。小米以直播方式公开后训练全过程,Flash和Pro合计花费347万美元,Pro在Artificial Analysis智能指数榜登上开源模型第一(46分)。作者通过五个真实任务测试:three.js程序化3D建模太和殿、高端旅行社官网前端审美、修复开源仓库真实bug、办公数据处理与核对、以及对发布仅七天的Jev模型做长程研究与幻觉控制。结果显示模型在agentic编程、审美、错误处理和事实核查上表现出色,且缓存命中率达95.7%、成本低廉,作者认为智能正走向普惠,计划将常用开源API迁移到MiMo-V2.6。

技术 › LLM 花叔 2026-09-2211.3 KB 14.5K 9 78
