Wiki 知识库

全部文档 / 标签: 微调

22 篇
清除

自己动手做LoRA 从 0 到 1 实战

作者详细记录了从零开始训练一个专属人物 LoRA 的完整实战流程。他使用 GPT Image 2 生成 56 张虚构人物训练数据,基于开源模型 MOSS-Image(5B 参数 Diffusion Transformer)进行微调,仅用一张 RTX 4090 训练约 65 分钟即获得稳定的人物形象生成能力。文章涵盖数据准备、Caption 标注、Checkpoint 选择、效果验收等关键环节,并指出了过拟合等常见问题。作者将整个流程开源到 GitHub,提供运行环境镜像、Jupyter Notebook 和 ComfyUI 工作流,建议初学者亲手跑一遍以真正理解 LoRA 训练原理,一通百通。

技术 › LLM 实践哥 Li 2026-10-2613.5 KB 3.3K 32 81

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。
技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

2小时从零看懂 AI:一篇文章建立AI认知体系(8000元企业内训同款)

本文是作者基于3家企业AI内训经验整理的AI入门长文,涵盖四大部分:大模型通识、提示词方法、智能体入门与实操。文章用通俗语言解释AIGC概念、大模型的定义与工作原理(概率预测文字接龙)、AI的优势(信息处理、知识覆盖、内容生成)与局限(幻觉、时效性、偏见、推理限制),并阐明AI软件=大模型+产品界面的本质,介绍提示词、微调、RAG三种大模型优化手段,帮助读者快速建立完整的AI认知框架。

技术 › LLM 龙井longjing 2026-10-1775.5 KB 583.4K 5.3K 73

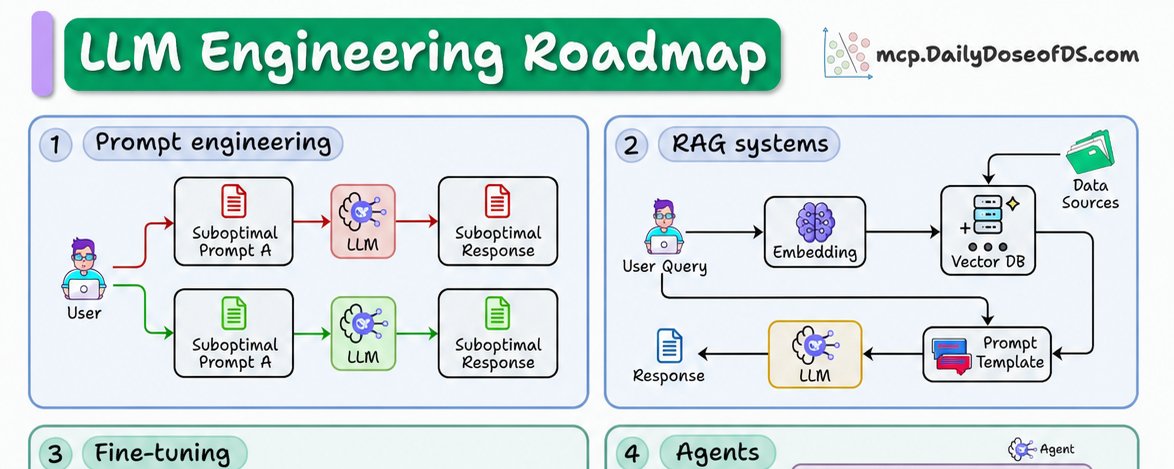
The 2026 LLM Engineering Roadmap

本文提出了2026年LLM工程路线图,指出与LLM工作不只是提示词,生产级系统需要对LLM的工程化、部署和优化有深入理解。文章总结八大支柱:提示工程(将prompt当作代码管理)、RAG系统(嵌入、检索、重排)、上下文工程(管理上下文窗口中各类信息的取舍)、微调(LoRA/QLoRA等技术)、Agent(工具调用循环与编排、状态管理、重试逻辑),并为每个领域提供了大量免费开源学习资源,如Anthropic、OpenAI官方指南及多个GitHub教程仓库。

技术 › LLM Avi Chawla 2026-10-0919.8 KB 403.3K 447 71

想转 FDE?一个干了 4 年多的人告诉你:这活从开会聊需求,到私有化部署,都得会

作者基于4年多车企AI落地经验,按项目全流程拆解FDE(Frontier Development Engineer)岗位的真实工作内容:售前阶段的客户预期管理、深入业务打磨几千个标签体系、模型开发(从BERT加规则演进到大模型抽取加检索链路,涉及微调、embedding、评测)、私有化部署的工程细节(驱动、CUDA、vLLM、压测、稳定性)、以及上线后的数据报告与可视化。作者强调模型只是最不用担心的部分,难的是模型前后的业务与工程,并介绍了AI coding如何让他一个人交付客户demo。

技术 › LLM Simon聊AI 2026-10-0929.3 KB 26.1K 87 86

Hugging Face 详细教程:从调用模型到微调与部署

本文是一篇 Hugging Face 平台的系统教程,从零讲解大模型开发的完整工作流:安装环境、登录 Hub、用 Pipeline 快速推理、理解 Tokenizer、加载模型、使用 Datasets 处理数据、用 Trainer 微调模型、通过 LoRA/PEFT 高效微调大模型、上传模型到 Hub,以及用 Spaces 部署 Gradio Demo。文章还涵盖模型选择要点、常见问题排查(如显存不足、tokenizer 配置、训练效果差)和分阶段学习路线,并附官方文档链接,适合想将大模型真正用起来的开发者入门与进阶。

技术 › 工具与效率 Mr Panda 2026-10-0712.1 KB 9.3K 40 80

Building an RL fine-tuning platform to train JEV-like decision models

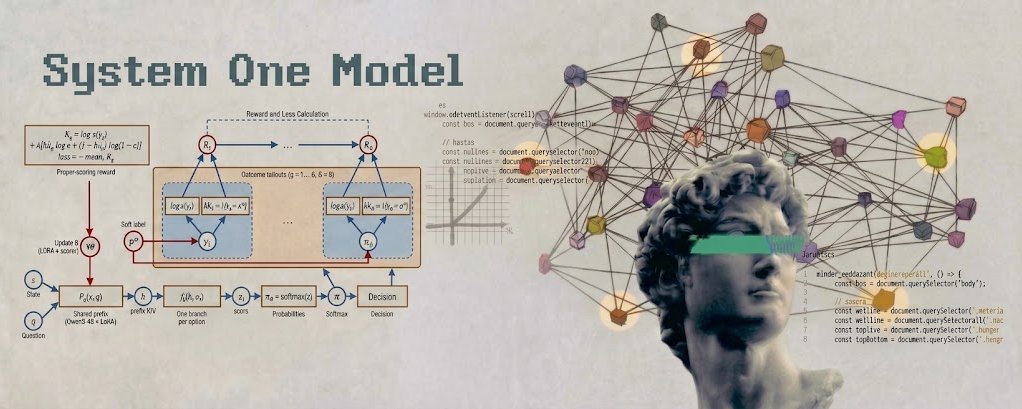
本文介绍如何将开源 LLM(Qwen3-4B)改造为决策模型,构建小规模训练平台并产出 Gero-4B。作者在 MacBook(M5 Pro, 24GB)上使用 Apple MLX 进行 LoRA 微调,分三个阶段:架构改造(将 LM head 替换为共享线性打分层)、结构训练(学习题目格式)、强化学习训练(实现校准的置信度输出)。核心设计是每个选项独立分支的打分架构,通过自定义 KV cache 共享前缀表示,并利用注意力掩码隔离各分支,从结构上消除位置偏差。最终模型输出数值化、校准良好的概率分布,可直接用于自动化决策(如高置信度自动处理、低置信度转人工)。文章附有完整可运行的代码实现。

技术 › LLM vixhal 2026-10-0426.6 KB 35.6K 299 86

Jeff:把 Jev 类决策模型压到 0.8B,跑在本地

Mathias Strasser(Scissero)基于 Qwen3.5 和 Gemma 4 微调出 Jeff 系列 0.8B/2B 决策模型,用于零样本分类:输入描述与选项,一次前向传播返回各选项校准概率。模型在 RTX PRO 6000 上约 22 毫秒、M4 Max 上 28 毫秒即可完成一次决策,0.8B 仅 1.7GB,可直接本地部署。整体基准分 Jeff-2B 达 83.1,几乎追平 Jev 的 83.0;Doom 零样本测试中 Jeff-0.8B 在无人提示规则下达到 6.55,追平 Jev 公布成绩。作者诚实列出局限:不能推理、最多 26 个选项、只支持英文文本等。代码 MIT、权重 Apache 2.0 开源。

技术 › LLM yibie 2026-09-3011.8 KB 8.5K 98 86

Is Jev overhyped? We tested it on 4 real enterprise tasks.

作者基于 Glean 的四个真实企业场景测试了 Jev——一个输出类型化决策(选项、分数、概率)而非生成文本的'System One'模型。文章梳理了通用 LLM、零样本分类器、微调分类器与 Jev 的替代方案权衡,并对比了 Qwen/SGLang、Kev 等开源复现。实验显示:查询分类上 Jev 零样本明显优于 Laya 但微调后反超;模型路由(专家转移)是最强结果,准确率更高且中位加速 8.1 倍;重排序中 Jev 的 Choice 表述最强,但平均 41 个候选中约 37 个分数相同需靠生产排序打破平局。结论是 Jev 在新任务或标签频繁变化时最具吸引力,是否被高估取决于具体场景。

技术 › LLM Tony Gentilcore 2026-09-2913.0 KB 196.4K 379 83

有人把 Jev 开源复刻了,还给出了「自己微调」的完整闭环

Jared Palmer(Cognition)开源了 Kev,一族建在 Qwen3.5/3.8 之上的 Jev 式小型决策模型(0.8B~27B,Apache-2.0)。文章介绍了 Kev 与 Jev 的对比数据:Kev-27B 在新数据源上与 Jev 相差一个点以内,但作者强调这不是受控比较。最有价值的部分是完整的微调闭环:通过 coding agent 的 skill,可自动从用户代码中找出问题、转换已有标签、在 Modal 上微调并部署,一次 Kev-4B 训练在 H100 上约 1 美元,示例中把准确率从 67.7% 提到 73.6%。文章还总结了校准温度、问题隔离设计等工程细节,以及作者诚实的自我限制态度。

技术 › LLM yibie 2026-09-289.8 KB 7.4K 78 88

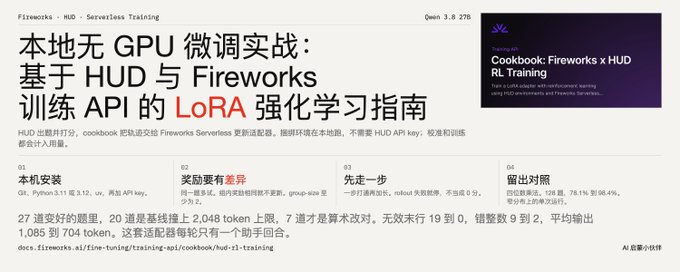
本地无 GPU 微调实战:基于 HUD 与 Fireworks 训练 API 的 LoRA 强化学习指南

本文解读 Fireworks AI 官方 Training API Cookbook 中一篇实战教程,讲解如何结合 HUD 框架与 Fireworks Serverless Training API,在无本地 GPU 条件下用 GRPO 风格强化学习微调 LoRA 适配器。文章详细拆解了四步工作流程:环境配置、任务校准、单步训练和长跑训练,重点阐释了快照隔离、trace 记录、loss masking、组内优势归一化等核心训练机制。实验结果显示四位数乘法任务准确率从 78.1% 提升至 98.4%,但作者指出收益主要来自输出格式和自我节制的优化,而非深层算术能力的提升。文章还提醒了 checkpoint 语义区分等实操要点,并对教程的严谨设计给予高度评价。

技术 › LLM meng shao 2026-09-2610.7 KB 4.7K 36 86

How to train your own Jev for $17

本文介绍如何以约17美元的成本微调一个类似Jev的高效分类模型。作者基于Qwen3.5 4B,从MultiNLI、BoolQ、Banking77、AG News、SST-5等多个Hugging Face数据集中采样约3.8万个样本,通过脚本归一化数据后,使用Together AI的Fine-tuning服务启动训练任务(约25分钟完成),再将模型部署到Together AI的专用端点(dedicated endpoint),并通过API查询模型完成分类任务。文中还发布了可直接使用的together/Tev1-4B-experimental模型,适用于客服意图识别、文本情感分析、论文分类等实际场景,涵盖从环境搭建、数据准备、训练到部署查询的完整流程。

技术 › LLM Hassan 2026-09-2412.4 KB 822.4K 2K 76

如何用自己的数据微调一个小模型

本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。

技术 › LLM yibie 2026-09-2010.3 KB 213.6K 1.1K 86

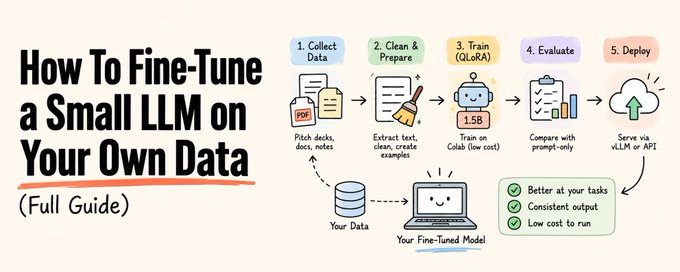
How To Fine-Tune a Small LLM on Your Own Data (Full Guide)

这是一篇关于微调小型LLM的完整实战指南。作者指出不需要70B大模型或昂贵算力,1.5B参数模型在200-500个优质样本上微调后,可在特定任务上超越通用提示的前沿模型。文章以商业融资文案生成为例,详细讲解了微调的实际目标、建立基线(纯提示、RAG、微调)的先后顺序,并分步骤介绍了小型基座模型选择(如Qwen2.5-1.5B)、数据权利合规、可复现数据下载、PDF文本提取与OCR、文本清洗、训练数据集构建、QLoRA训练、评估与部署,每一步均附完整代码。

技术 › LLM Rahul 2026-09-1926.1 KB 2.5M 2.7K 86

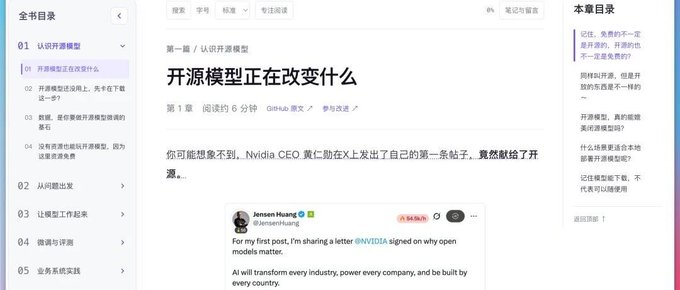
爆肝 30 天,我们开源了开源模型最全实践指南(建议收藏)

作者苍何与 AgentWork 开源社区历时 30 天打造了开源模型实践指南《魔搭紫皮书》,已被 ModelScope 魔搭开源组织收录。全书 8 章 34 节、40 余万字,涵盖开源模型选型、部署运行、微调与评测、业务系统实践(如 AI 健身教练、智能客服质检)、AIGC 特别篇及 Agent 特别篇(MCP、Skill、Claude Code 等)。所有实验步骤均人工实操验证,旨在帮助开发者从下载模型到真正用好的全过程,项目开源在 GitHub,欢迎社区共创。

技术 › LLM 苍何 2026-09-177.9 KB 15.8K 128 65

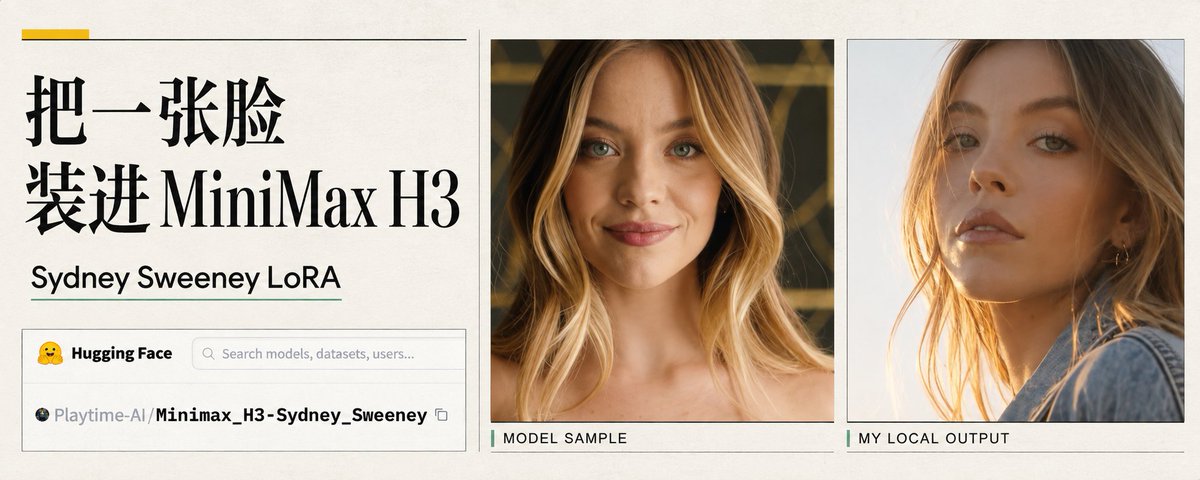
把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用

作者拆解了 Playtime-AI 发布的 Sydney Sweeney 人物 LoRA(仅 155MB)如何在 MiniMax H3 视频模型上无需参考图、仅凭名字生成人物视频。文章讲解 LoRA 低秩自适应原理:冻结基础模型,只训练小矩阵 A、B 记录人物身份差量;还原训练过程(3440 步、120 epoch、rank 16、约 5% caption dropout);并分享本地加载实践,包括底模版本兼容、量化格式、采样步数(6 步而非 30 步才清晰)和触发词拼写等常见坑。最后指出 LoRA 技术正在改变人物身份的传播方式。

技术 › LLM Michael Guo 2026-09-0813.8 KB 32.5K 183 87

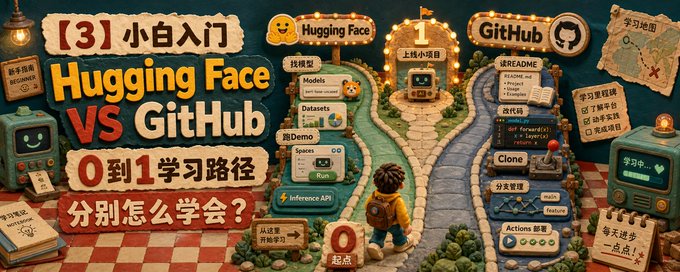
小白入门:Hugging Face vs GitHub 测评与零基础学习路径

本文为零基础学习者提供 GitHub 和 Hugging Face 两套可执行的学习路线。GitHub 路线分 3 阶段:第 1 周入门(核心概念与图形化工具操作)、第 2-3 周进阶(Git 命令、团队工作流、Pull Request 与开源参与)、第 4 周实战(搭建个人作品集)。Hugging Face 路线也分 3 阶段:第 1 周平台认知与在线体验、第 2-4 周本地调用 Transformers 库与简单微调、第 5-6 周开发并部署 AI 应用。文章还给出不同基础学习者的时间分配建议,所有推荐资源均免费,每天学习 1-1.5 小时即可从 0 到 1 完成入门。

技术 › 工具与效率 Modengsir AI 2026-09-068.0 KB 2K 16 72

让AI从新人变成长期的同事——硬核拆解Alloomi的三层技术路线

作者通过分析Alloomi的两篇技术报告,拆解了让AI具备长期工作能力的三层技术路线:记得住、学得会、做得成。第一层通过给信息打标签、时间有效期管理和连接强化构建持久化上下文记忆(OpenContext已开源);第二层通过经验池筛选、微调飞轮和Engram X设计将经验写入模型权重实现自我进化,并配有三裁判安全阀机制;第三层在SWE-Bench-CL、JobBench、GDPval等基准上验证端到端交付能力。三层构成可回滚的闭环,让AI每完成一次交付就变强一点。

技术 › Agent AI少年 2026-08-1815.9 KB 19K 73 74

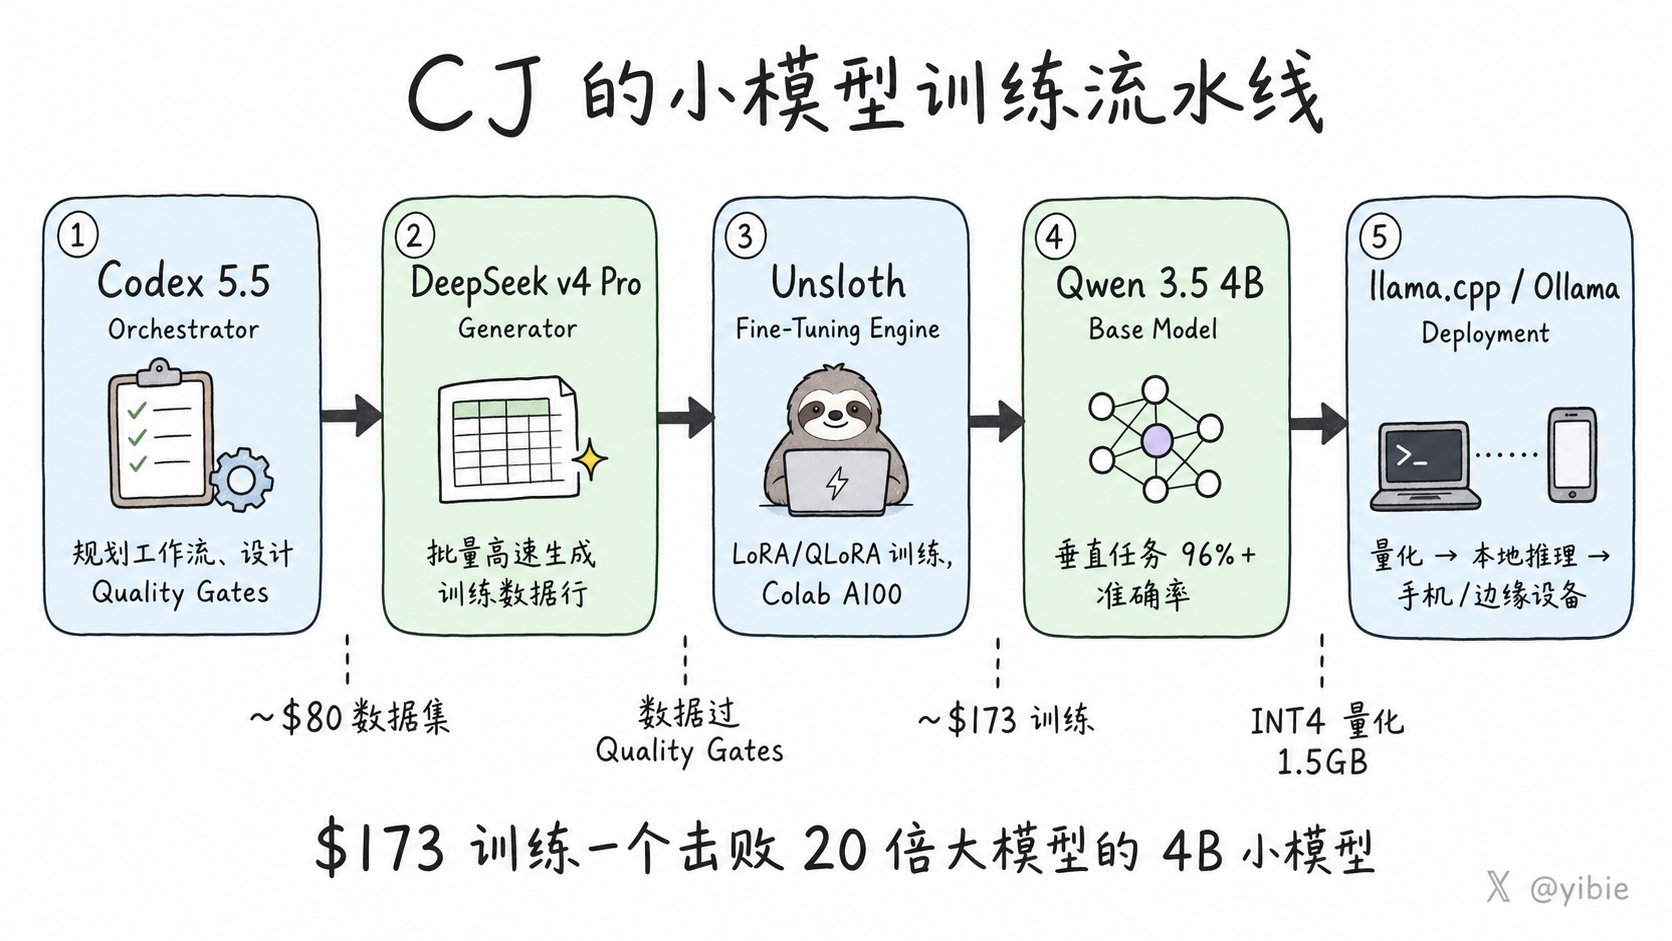
训练小模型:2026 年最被低估的 AI 技能

本文探讨了 2026 年 AI 领域的边缘趋势:个人开发者训练小模型(SLM)。文章详细介绍了 CJ Zafir 的方法论,即利用 Codex 和 DeepSeek 生成数据、Unsloth 进行训练、Qwen 作为基座,以极低成本(最低 11 美元)在垂直任务上超越大模型。文章指出,真正的护城河在于高质量数据集的生成工厂,而随着硬件门槛降低和工具成熟,模型微调正从企业军备竞赛转向个人技能。

技术 › LLM yibie 2026-06-028.1 KB 88

使用 Fireworks Agent 自动化 LLM 微调全流程

本文介绍了如何利用 Fireworks Agent 实现 LLM 微调(SFT)的全自动化。文章以 Andrej Karpathy 的“个人 LLM Wiki”理念为引,阐述了将知识注入模型权重比单纯依赖上下文窗口更高效。通过 Fireworks Agent,作者展示了从数据集检查、超参数搜索、模型训练到部署推理的完整闭环,无需人工干预繁琐步骤,仅需少量 GPU 时间和极低成本,即可训练出具有特定输出风格(如 Wiki 摘要风格)的模型,为构建自我进化的 Agent 铺平了道路。

技术 › Agent elvis 2026-05-2115.5 KB 46.8K 110 83

LoRA - LLMs 的低秩适配详解

文章详细介绍了 LoRA (Low-Rank Adaptation) 技术,这是一种用于高效微调大型语言模型的方法。通过冻结原始权重并学习两个极小的低秩矩阵,LoRA 能够在保持模型性能的同时,大幅降低显存占用、训练成本和存储空间。文章还解释了 LoRA 的核心数学原理、具体实施步骤以及为何全量微调成本高昂的原因。

技术 › LLM Amit Shekhar 2026-05-0814.9 KB 10.6K 186 69