Wiki 知识库

全部文档 / 标签: LoRA

30 篇
清除

自己动手做LoRA 从 0 到 1 实战

作者详细记录了从零开始训练一个专属人物 LoRA 的完整实战流程。他使用 GPT Image 2 生成 56 张虚构人物训练数据,基于开源模型 MOSS-Image(5B 参数 Diffusion Transformer)进行微调,仅用一张 RTX 4090 训练约 65 分钟即获得稳定的人物形象生成能力。文章涵盖数据准备、Caption 标注、Checkpoint 选择、效果验收等关键环节,并指出了过拟合等常见问题。作者将整个流程开源到 GitHub,提供运行环境镜像、Jupyter Notebook 和 ComfyUI 工作流,建议初学者亲手跑一遍以真正理解 LoRA 训练原理,一通百通。

技术 › LLM 实践哥 Li 2026-10-2613.5 KB 3.3K 32 81

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。

技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

指令微调:理解 Instruction Tuning

本文是后训练系列第二篇,介绍指令微调(SFT)。以斯坦福 Alpaca 用 52,000 条自动生成的数据微调 LLaMA 7B 为例,说明指令微调与预训练使用相同的下一个 token 预测损失,但数据和任务不同。文章详细讲解训练五步骤:收集、格式化、掩码、训练、评测,并通过 LIMA 和 FLAN 研究说明指令微调主要改变模型行为方式而非增加知识,少量数据即可泛化到新任务。还介绍了损失掩码原理、位置错开的实现细节、指令数据的三种来源及其局限:无法补充知识、比较回答优劣或检验正确性。

技术 › LLM Dongxi 东锡 NLP 2026-10-2312.4 KB 8.9K 59 83

一个指令→爆款视频:万物皆可360° Orbit环绕(免部署)

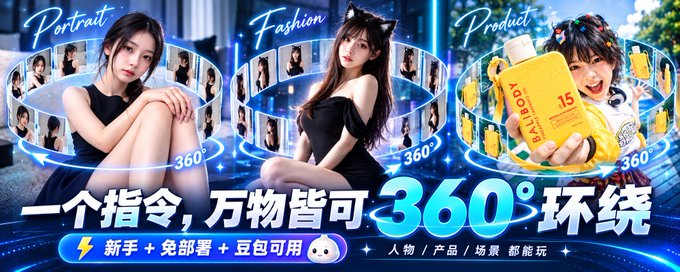
文章介绍了一种简单易上手的AI视频玩法:上传一张图片加一条指令,即可生成360°环绕(Bullet Time)效果的视频。作者展示了旅游、美食、美妆、商业摄影、产品展示、服装穿搭等多个应用场景及商业潜力。实现方法分为两种:一是免部署的Web端方案,使用豆包等可生成视频的模型,配合文中提供的通用短指令和完整10秒详细指令;二是适合进阶用户的ComfyUI本地部署方案,通过加载MiniMax H3 I2V模板和360° Orbit LoRA实现。作者以设计师视角分享了最低门槛、可复用的AI玩法。

技术 › TTS Dmiao豆苗啊 2026-10-1512.2 KB 298.6K 530 76

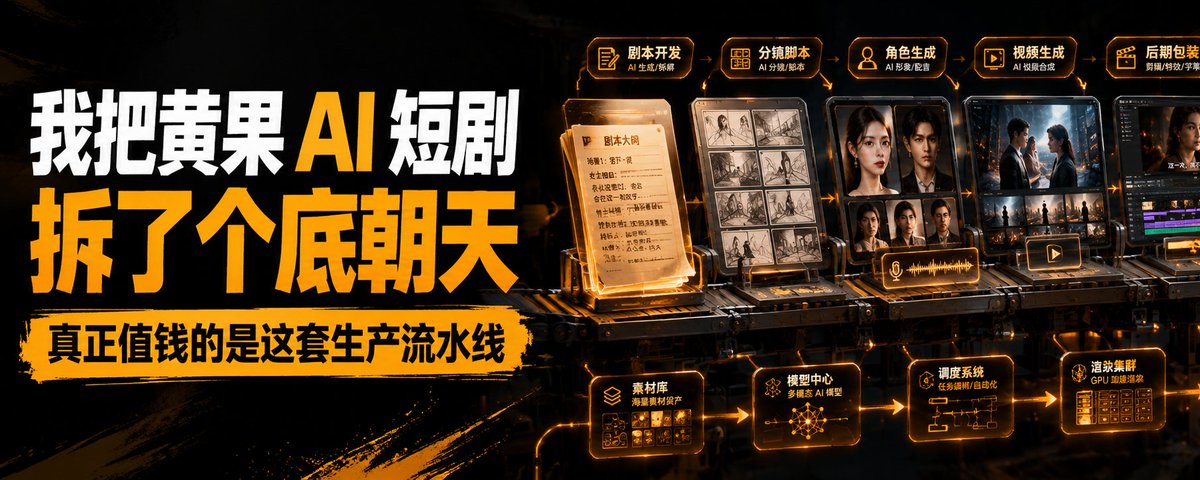
一个人、一台电脑、8分钟AI短剧:从《黄果》逆向拆出来的13步流水线(万字实操指南)

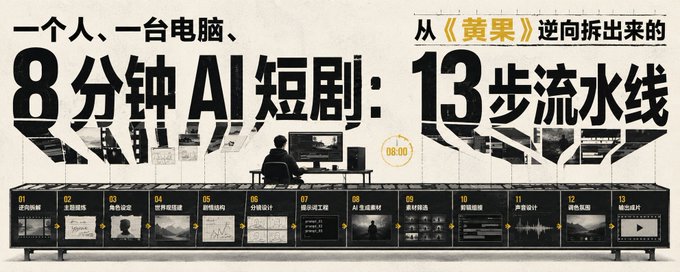
本文通过对8分钟AI短剧《黄果》成片(117个镜头)的逐帧逆向拆解,总结出一套可复现的13步AI短剧制作流水线。文章首先对比云端托管、本地开源、混合路线三条技术路径及成本考量,然后详解从LLM编写分镜脚本、角色LoRA训练、场景模板建立、关键帧生成、人工精修、I2V/TI2V视频生成、对口型处理,到后期超分补帧、TTS配音混音等每一步的操作要点、验证标准与错误应对方案。文末还总结了重复帧、短镜头策略、LoRA维护、精修比例等行业认知,以及模型在长动作、多人互动、文字生成等方面的能力边界。

技术 › 短剧 知识猫AI实验室 2026-10-1131.1 KB 137.9K 362 86

Hugging Face 详细教程:从调用模型到微调与部署

本文是一篇 Hugging Face 平台的系统教程,从零讲解大模型开发的完整工作流:安装环境、登录 Hub、用 Pipeline 快速推理、理解 Tokenizer、加载模型、使用 Datasets 处理数据、用 Trainer 微调模型、通过 LoRA/PEFT 高效微调大模型、上传模型到 Hub,以及用 Spaces 部署 Gradio Demo。文章还涵盖模型选择要点、常见问题排查(如显存不足、tokenizer 配置、训练效果差)和分阶段学习路线,并附官方文档链接,适合想将大模型真正用起来的开发者入门与进阶。

技术 › 工具与效率 Mr Panda 2026-10-0712.1 KB 9.3K 40 80

Building an RL fine-tuning platform to train JEV-like decision models

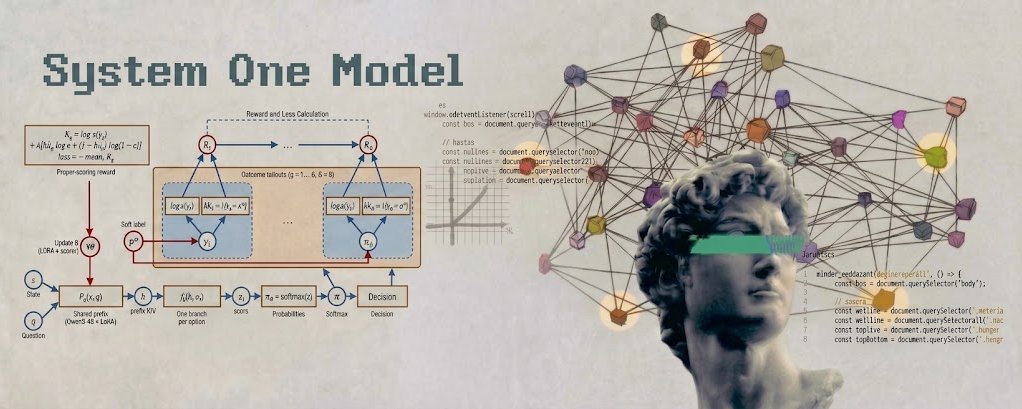
本文介绍如何将开源 LLM(Qwen3-4B)改造为决策模型,构建小规模训练平台并产出 Gero-4B。作者在 MacBook(M5 Pro, 24GB)上使用 Apple MLX 进行 LoRA 微调,分三个阶段:架构改造(将 LM head 替换为共享线性打分层)、结构训练(学习题目格式)、强化学习训练(实现校准的置信度输出)。核心设计是每个选项独立分支的打分架构,通过自定义 KV cache 共享前缀表示,并利用注意力掩码隔离各分支,从结构上消除位置偏差。最终模型输出数值化、校准良好的概率分布,可直接用于自动化决策(如高置信度自动处理、低置信度转人工)。文章附有完整可运行的代码实现。

技术 › LLM vixhal 2026-10-0426.6 KB 35.6K 299 86

用 MiniMax H3 打造 AI 影片創作工作流:分鏡、動作與聲音一體化設計

作者分享了以 MiniMax H3 為核心的本地 AI 影片製作工作流,強調人物不僅要長得對,還要具備空間、道具與互動邏輯。流程包括:確立參考素材、撰寫結構化分鏡 Prompt(含 subject_definitions、retention_analysis、detailed_description 等模組)、加入 T8 ActionLogic 語義橋強化動作因果理解,並依題材搭配加速、寫實、格鬥、電影質感等 LoRA。生成後經放大銳化第二階段精修,遵循「寫分鏡→生成→檢查→修改→重拍」的創作循環。文末附完整模型、語義橋與 LoRA 資源清單。

技术 › 短剧 Tom𝕎 2026-09-2910.4 KB 23.5K 281 83

本地无 GPU 微调实战:基于 HUD 与 Fireworks 训练 API 的 LoRA 强化学习指南

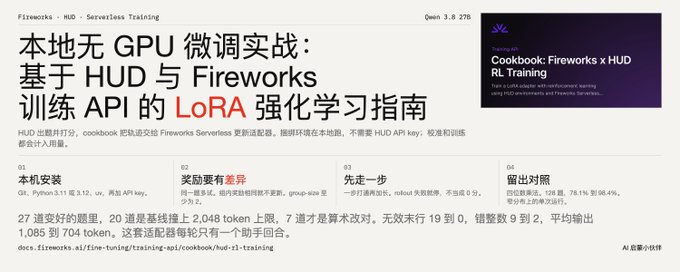
本文解读 Fireworks AI 官方 Training API Cookbook 中一篇实战教程,讲解如何结合 HUD 框架与 Fireworks Serverless Training API,在无本地 GPU 条件下用 GRPO 风格强化学习微调 LoRA 适配器。文章详细拆解了四步工作流程:环境配置、任务校准、单步训练和长跑训练,重点阐释了快照隔离、trace 记录、loss masking、组内优势归一化等核心训练机制。实验结果显示四位数乘法任务准确率从 78.1% 提升至 98.4%,但作者指出收益主要来自输出格式和自我节制的优化,而非深层算术能力的提升。文章还提醒了 checkpoint 语义区分等实操要点,并对教程的严谨设计给予高度评价。

技术 › LLM meng shao 2026-09-2610.7 KB 4.7K 36 86

如何用 AI 视频模型创建高质量镜头运动

本文是 LTX-2.5 AI 视频模型的镜头运动指导教程。文章介绍了该 220 亿参数开源音视频基础模型的架构原理,指出良好的镜头运动需具备时间连贯性、意图匹配和画面完整性。作者强调使用官方文档化的镜头词汇(如 pushes in、pulls back、pans across 等),并给出最关键的提示词技巧:描述运动完成后主体在画面中的状态,为模型提供'目的地'而非仅方向。文章还讲解了帧数约束((F-1)%8==0)、提示词修复案例、多镜头剪辑中的镜头规划方法,以及复杂运动可使用 IC-LoRA 深度条件控制等确定性手段。

技术 › AI视频 LTX.io 2026-09-2214.4 KB 137K 162 84

如何在一张 GPU 上服务 100 个微调模型

文章介绍如何在单张 GPU 上高效服务大量 LoRA 微调模型。将适配器合并进基座会为每个变体生成 15.2GB 的完整模型副本,而分开保存适配器只需约 40MB,共享基座后 100 个变体仅占 19.3GB。作者对比了四种部署形态(合并独立 endpoint、启动时注册、请求时解析、托管按租户),并在 Runpod 上用 Qwen 1.5B 训练三个 LoRA 适配器做实验。结果显示共享 endpoint 复用 worker 池,显著减少冷启动与显存浪费;同时强调应分开记录等待时间与执行时间,并通过镜像缓存优化冷启动延迟。

技术 › LLM yibie 2026-09-1611.8 KB 5.4K 38 86

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86

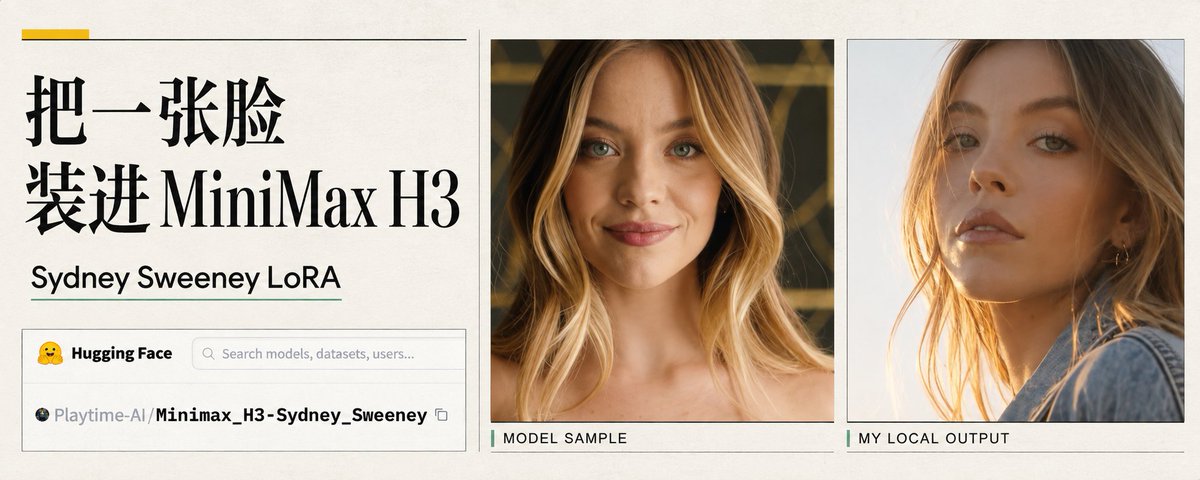
把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用

作者拆解了 Playtime-AI 发布的 Sydney Sweeney 人物 LoRA(仅 155MB)如何在 MiniMax H3 视频模型上无需参考图、仅凭名字生成人物视频。文章讲解 LoRA 低秩自适应原理:冻结基础模型,只训练小矩阵 A、B 记录人物身份差量;还原训练过程(3440 步、120 epoch、rank 16、约 5% caption dropout);并分享本地加载实践,包括底模版本兼容、量化格式、采样步数(6 步而非 30 步才清晰)和触发词拼写等常见坑。最后指出 LoRA 技术正在改变人物身份的传播方式。

技术 › LLM Michael Guo 2026-09-0813.8 KB 32.5K 183 87

大模型微调实操教程:手把手带你训练人物LoRA

本文是一篇面向零基础读者的大模型微调实操教程,作者详细演示了如何在云端租用RTX 4090显卡,使用LoRA技术对SDXL图像生成模型进行人物微调。教程涵盖数据集准备(用IP-Adapter生成24张训练图并配描述)、训练环境搭建、20步冒烟测试、1200步正式训练、不同checkpoint的对照评测及成果保存与重新加载等完整流程。整轮实验仅花费2.71元、约78分钟,最终得到可复用的人物LoRA权重,可稳定生成不同造型、场景下的同一人物写真。

技术 › LLM 静静学AI 2026-09-0717.8 KB 32.6K 61 85

Hugging Face从入门到精通:万字长文详解

本文是一篇关于Hugging Face平台的详尽入门指南,旨在帮助初学者快速上手。文章首先介绍了Hugging Face的价值,即可以自由选择模型、试用在线演示并下载到本地。随后,文章详细讲解了平台首页的五大核心区域(搜索框、Models、Datasets、Spaces、更多菜单),并指导读者如何通过Spaces体验AI应用、通过Models查找和下载模型、通过Datasets预览和获取数据。文章还深入解析了模型页面的关键信息(如模型卡、文件版本、社区讨论、许可),以及模型下载和本地使用的具体方法,包括量化版本的选择和硬件要求。最后,文章强调了数据集的预览功能,帮助用户做出明智的下载决策。全文语言通俗,步骤清晰,适合所有对AI感兴趣的读者。

技术 › 工具与效率 Miles Ma 2026-09-0127.1 KB 119.7K 472 79

万字长文!读懂模型微调的基本概念和名词

本文系统梳理了模型微调的核心概念与术语。作者首先解释了微调的意义:在预训练模型基础上,用任务相关数据继续训练,使模型更适应特定表达、任务或指令,减少幻觉。随后从五个层面展开:模型训练阶段(预训练、基础模型、后训练、微调);训练原理(SFT、指令微调、下一个token预测);训练框架与工具(PyTorch、容器、训练方案);LoRA相关技术(PEFT、QLoRA、rank、alpha、target modules);数据与训练参数(语料、数据集、batch size、学习率、过拟合、eval loss等)。文章以DGX Spark本地微调Gemma为例,帮助读者理解微调全流程。

技术 › LLM Roland.W 2026-09-0120.3 KB 32.5K 85 71

别再研究提示词了,我把黄果批量生产短剧的技术栈扒出来了

作者对一张流传甚广的AI短剧《黄果》制作流水线图进行逐帧验证与修正,提出三个关键判断:黄果并非一部剧而是一个多创作者投稿制内容平台;24fps补帧痕迹不能锁定Wan模型,Seedance同为24fps输出;真正的护城河不是13步工序,而是平台持有的'破限模型'。作者进而提出'双轨模型+后期统一'的技术假说,给出五条可证伪预测,并分析了成本结构、法律风险及工艺向合规赛道的迁移价值,强调分析框架比结论更重要。

技术 › 短剧 王大锤 2026-08-3020.1 KB 646.5K 1.2K 82

这可能是全网最好的二次元 AI 绘图教学

文章系统梳理了二次元 AI 绘图中最常用的十类画风提示词写法,包括平涂、厚涂、油画/水彩、游戏画风、动漫画风、水墨/线稿、3D/写实、像素、漫画和Q版。作者强调先掌握提示词结构(画师串、画风词、光线色调、质量词、人物动作、场景),并针对不同风格给出了可直接复制的 Prompt、适配模型建议(如 NovelAI、Anima)以及与 LoRA、画师串的搭配注意事项。文中还展示了实战效果,称质感逼真到可媲美真人画师作品。

技术 › AI绘画 Musolsol.0xU (@MMMusol) 2026-08-304.2 KB 76

本地部署MiniMax H3生成视频全流程揭秘:硬件配置、工作流与提示词

作者分享了在RTX 4070 16G显存电脑上本地部署MiniMax H3视频生成模型的完整经验:使用精简版ComfyUI和turbo lora模型(6步生成480P,超分至1080P),并让AI工具搭建了手机可远程调用的自动化系统,支持文生视频、图生视频、首尾帧等功能。文章详细说明不同分辨率下的时长与耗时数据,总结了低分辨率视频的美学要点(适合风景、特写、慢镜头),并附上完整的30秒电影复刻级英文对白短片提示词,涵盖镜头设计、人物一致性、声音设计与避坑指南。

技术 › 工具与效率 PixelAIGC 2026-08-2913.0 KB 81

普通人做 AI 视频必懂基础概念

面向 AI 视频制作新手的入门科普文章,去繁就简地讲解了四大模块的基础概念:音频部分(TTS、ASR、SRT 字幕、声音克隆等)、视频底层工具(ffmpeg、帧率、补帧、超分、人脸修复)、AI 生成画面核心概念(Prompt、Seed、LoRA、时序一致性、图生视频等)以及流水线工程概念(推理、量化、ComfyUI、智能体等)。每个概念只讲是什么与实操重点,并给出新手避坑建议:先跑通最小流水线、显存决定速度、理解文件流转逻辑,最后附完整专有名词速查表。

技术 › 短剧 Modengsir AI 2026-08-296.8 KB 8K 71 78

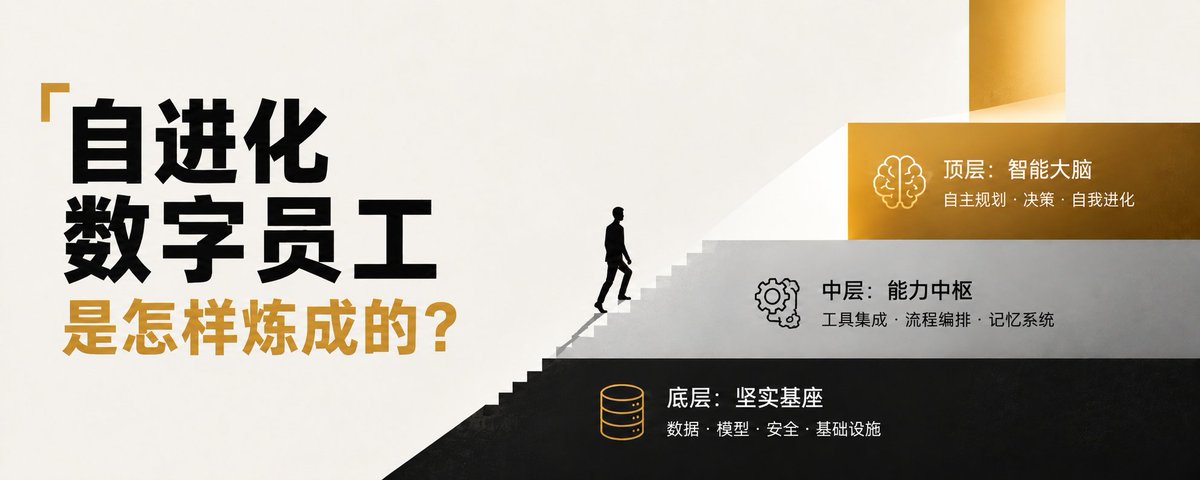
「自进化数字员工」是怎样炼成的?拆解 Alloomi 的三层技术路线

本文深入探讨了AI Agent从“记忆”到“学习”的进化路径,指出传统RAG方案在长周期业务中的局限性,并详细拆解了Alloomi提出的三层技术路线:任务层(Holistic Context)、脚手架层(MAPE控制环)和模型层(Self-Evolving Agent)。通过九项Benchmark验证,展示了该方案在长期记忆、持续学习和真实任务交付上的显著提升,提出了数字员工应具备“记得住、学得会、做得成”三类能力的观点。

技术 › Agent Lonely 2026-08-1312.0 KB 53.2K 101 73

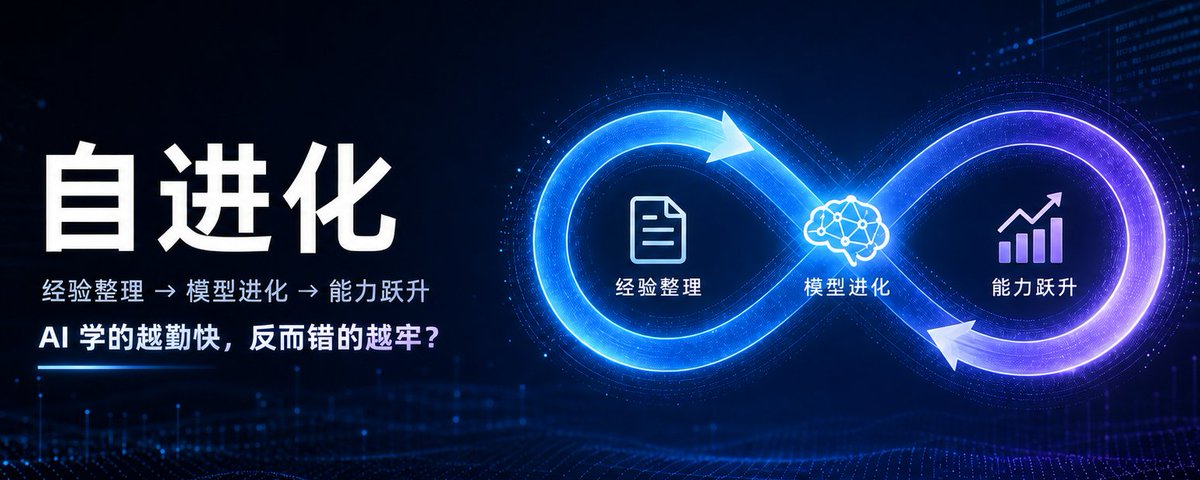
AI 学的越勤快,反而错的越牢?

本文探讨了AI Agent的“自进化”能力,指出若训练数据包含过期或错误的历史信息,模型会越学越错。作者以Alloomi公司的两份技术报告为例,介绍了Holistic Context如何通过实体归因、时间线和关系学习清理混乱的工作历史,以及Self-Evolving Agent如何通过质量过滤、LoRA微调、跨任务回放和稀疏权重单元(Engram X)将整理后的经验安全地融入模型。实验显示,在CL-Bench上,完整SEA机制比无记忆基线提升26.1个百分点。文章强调,AI公司的下一道分水岭在于能否构建受控的经验积累与更新链路,而非单纯扩大上下文窗口。

技术 › Agent Rachel 2026-08-137.6 KB 52.5K 80 67

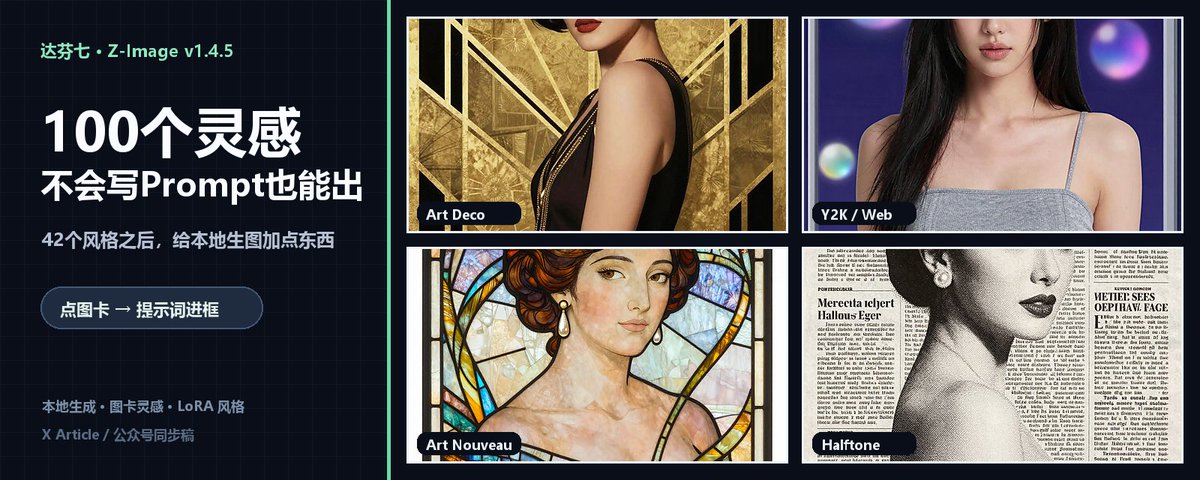
42个风格之后,我又给本地生图塞了100个灵感

本文介绍了达芬七·Z-Image v1.4.5版本的更新,重点在于为本地生图工具新增100个提示词灵感卡,解决用户“不知道画什么”的痛点。文章详细说明了灵感卡与LoRA风格的区别、使用方法和实际案例,并提供了升级补丁和完整包的安装指引。作者强调灵感卡帮助用户快速开始创作,并通过实际演示展示了如何修改提示词生成个性化图像。

技术 › 工具与效率 达芬七Seven 2026-08-129.3 KB 144.9K 189 77

8G显卡本地未审查生图,42个风格我都替你测好了

作者分享了基于8G显存的本地AI生图整合包Z-Image v1.4.0,包含42种预测风格和FP8/GGUF/BF16三种档位。该工具旨在降低小白使用门槛,通过一键式操作实现未审查的本地生图,保障隐私且支持参数复用,适用于封面制作、分镜设计等场景。

技术 › 工具与效率 达芬七Seven 2026-08-0111.4 KB 469.2K 839

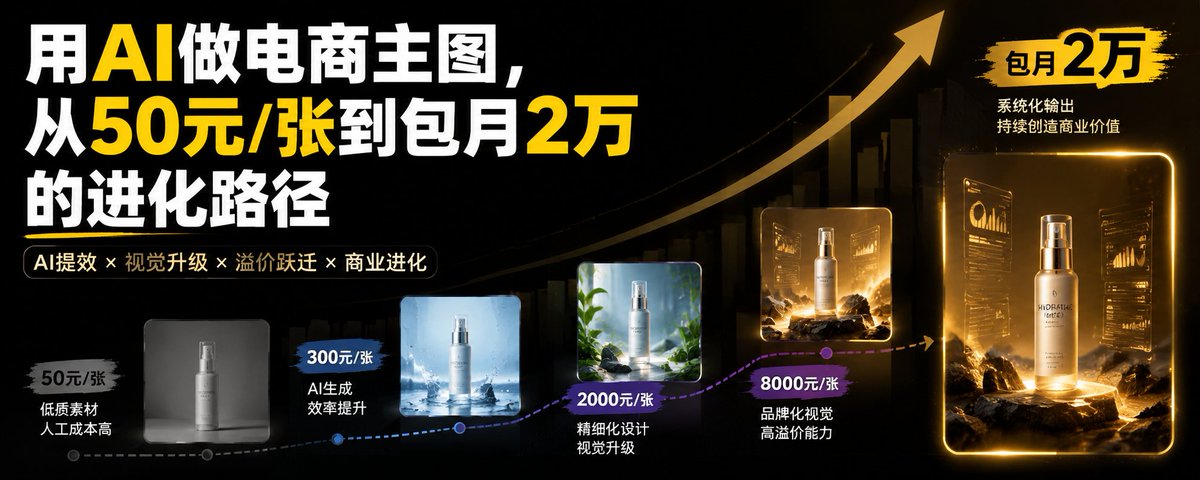
AI电商主图设计变现:从50元/张到月入2万的实战路径

文章详细拆解了作者如何利用AI工具(如Midjourney、Stable Diffusion)从事电商主图设计,从最初的“50元/张”低价接单,逐步进化为“2万/月”的高端视觉顾问的全过程。通过三个阶段(跑通交付、打包方案、卖结果)的迭代,结合LoRA模型提效与商业思维升级,展示了AI时代个体副业的变现进化路径。

技术 › AI应用 梨 梨汁儿 2026-05-175.9 KB 89

LoRA - LLMs 的低秩适配详解

文章详细介绍了 LoRA (Low-Rank Adaptation) 技术,这是一种用于高效微调大型语言模型的方法。通过冻结原始权重并学习两个极小的低秩矩阵,LoRA 能够在保持模型性能的同时,大幅降低显存占用、训练成本和存储空间。文章还解释了 LoRA 的核心数学原理、具体实施步骤以及为何全量微调成本高昂的原因。

技术 › LLM Amit Shekhar 2026-05-0814.9 KB 10.6K 186 69

AI 是真的在进化,还是看起来在进化

文章探讨了 AI 进化的方向已从单纯的模型参数优化转向 Agent 的自我进化。分析了 Hermes Agent、OpenClaw 等基于 Skill 和 Context 的技术路径,指出从 LoRA 参数更新转向 SKILL.md 的范式转移降低了工程门槛。同时,作者提出了构建 EvoAgentBench 评测标准的必要性,以量化评估 Agent 的自进化能力,并展望了参数空间与 Context 空间未来合流的架构趋势。

技术 › Agent 艾略特 2026-04-1911.9 KB 84

LLM 工程师必读的 12 篇研究论文

文章列出了每位 LLM 工程师必须阅读的 12 篇核心论文清单,涵盖了从 Transformer 架构、BERT、GPT-3 等基础模型,到扩展定律、Chinchilla 训练法则、RLHF 对齐技术,以及 LoRA 高效微调和 FlashAttention 等工程优化技术。这些论文构成了现代大模型理解、训练和部署的理论基石。

技术 › LLM Amit Shekhar 2026-04-187.5 KB 236.4K 1.3K 39

一张图如何变成 IP 资产:从角色锚点到标志性动作

本文探讨了 AI 创作中将单张图转化为持久 IP 资产的方法。作者指出,90% 的初学者因混淆“类型介绍”与“人物指认”而导致角色不一致。文章提出“角色锚点”理论(硬、软、场景三层),并结合微表情与标志性动作确立角色辨识度。此外,对比了 AI 资产库(主体模式)与 LoRA 训练的优劣,提供了一套从快速迭代到商业量产的最佳实践路径。

技术 › AI 波妞PONYO 2026-04-1011.3 KB 6.6K 69 84