从罗福莉晋升小米最高职级看顶尖AI人才的核心特质
文章从罗福莉升任小米最高职级(20/22级)的新闻切入,回顾她研二时发表8篇ACL顶会论文的出色学术经历,并总结顶尖AI人才的四大核心特质:极强的快速学习能力、坚持做难而正确的事、关键时刻做出关键选择的能力、极致专注与快速进入心流的能力。作者还指出优秀人才在软技能上几乎没有短板,建议普通人拆解并模仿这些优秀特质,以实现持续进步。
文章从罗福莉升任小米最高职级(20/22级)的新闻切入,回顾她研二时发表8篇ACL顶会论文的出色学术经历,并总结顶尖AI人才的四大核心特质:极强的快速学习能力、坚持做难而正确的事、关键时刻做出关键选择的能力、极致专注与快速进入心流的能力。作者还指出优秀人才在软技能上几乎没有短板,建议普通人拆解并模仿这些优秀特质,以实现持续进步。
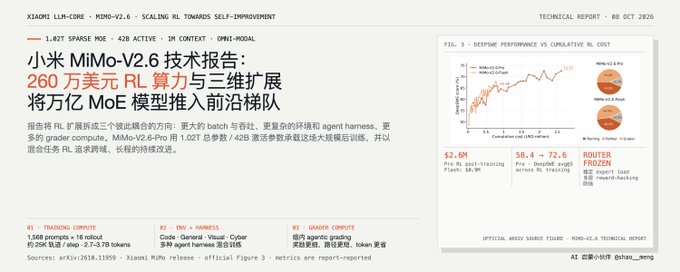
文章解读小米 LLM-Core 团队发布的 MiMo-V2.6 技术报告。核心主张是通过系统性扩展强化学习算力提升模型智能,需同时扩展训练批次、环境多样性和评分器三个维度。模型有 Pro(1.02T MoE)和 Flash(310B)两个规格,RL 后训练成本分别 260 万和 90 万美元。报告详述了中期训练优化、GRPO 训练细节、多 harness 训练、四层 reward hacking 防御、Groupwise Agentic Grading 评分体系、router 冻结发现及基础设施设计,最终性能进入与 Claude Opus 5 / GPT-5.6 同一梯队,并开源蒸馏模型、环境与 RL 框架。
作者实测小米直播后训练的MiMo-V2.6模型。小米以直播方式公开后训练全过程,Flash和Pro合计花费347万美元,Pro在Artificial Analysis智能指数榜登上开源模型第一(46分)。作者通过五个真实任务测试:three.js程序化3D建模太和殿、高端旅行社官网前端审美、修复开源仓库真实bug、办公数据处理与核对、以及对发布仅七天的Jev模型做长程研究与幻觉控制。结果显示模型在agentic编程、审美、错误处理和事实核查上表现出色,且缓存命中率达95.7%、成本低廉,作者认为智能正走向普惠,计划将常用开源API迁移到MiMo-V2.6。
文章解读小米罗福莉关于 MiMo-V2.6 的 RL 复盘,探讨 RL 能否像预训练一样规模化。MiMo-V2.6 单次更新抽取 1568 个任务、每任务 16 条 rollout,一个 Step 生成约 2.5 万条 Agent trajectory。文章指出 Agent RL Scale 的三大难点:需要 7000 多个 RL Task Environment 供模型进入;将 Harness 混入训练实现跨 Harness 迁移能力(You Only RL Once);以及需要强大的 Grader 评估轨迹质量并对抗 Reward Hacking。作者认为未来模型公司的核心能力是建造 Experience Factory,让模型通过大量真实经历实现下一轮 Scaling。
文章对比评测了同日凌晨发布的Grok 4.7与小米MiMo V2.6两款大模型。作者提出大模型的"不可能三角"——性能、价格、速度难以同时满足。Grok 4.7表现低于预期,前端能力崩盘,Coding Agent评测得分惨淡;而MiMo V2.6则超出预期,AA指数46分与Grok 4.7打平,位列开源与国产第一,CritPt科研推理仅次于GPT和Claude,价格极低(缓存输入0.025元/百万Token),输出速度达130 Token/s,成为作者心中解决不可能三角的版本答案。作者还介绍了小米公开直播强化学习训练过程的创新做法及其技术报告。
文章介绍了如何利用小米官方活动免费申请大量 Token 的教程。针对开发者和普通用户提供了两种申请路线:开发者版需如实填写项目信息和上传账单截图;小白版则强调描述真实的学习或办公需求。审核门槛低,通过率高,适合需要大量处理长文本和知识库构建的用户。
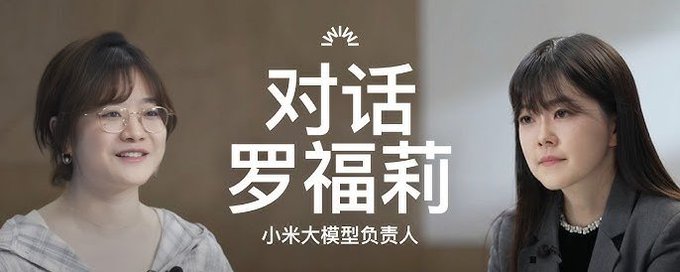
本文详细介绍了小米大模型负责人罗福莉关于 AI 行业发展趋势的深度见解。罗福莉指出,2026 年 AI 的核心已从预训练主导的 Chatbot 时代转向后训练主导的 Agent 时代。文章重点分析了 OpenClaw 框架的划时代意义,其通过分层记忆和模型编排弥补了短板,实现了极致的生产力提升。此外,还探讨了后训练算力权重的增加、团队组织方式的变革以及未来 AGI 的实现路径。
本文是一位拥有15年从业经验的金融人士为普通人撰写的投资指南。文章通过小米投资的案例,指出了散户常犯的错误,如高仓位、加杠杆和情绪化交易。作者提出了三条核心原则:绝不使用杠杆、严格控制持仓集中度、设定合理的收益预期。文章强调投资是与人性的对话,旨在帮助投资者建立系统化的投资框架,避免毁灭性亏损。