Wiki 知识库

全部文档 / 标签: Tensor Core

3 篇
清除

NVIDIA RTX 20/30/40 显卡隐藏 Tensor Core 算力被破解解锁

民间开发者破解了 NVIDIA RTX 20、30、40 三代显卡被锁定的 Tensor Core 算力,无需更换硬件、刷 BIOS 或魔改驱动,通过底层方式解除性能限制。RTX 4090 算力从 165.6 翻倍至 331.6 TFLOPS,RTX 3090 Ti BF16 提升约 80%,部分老显卡如 RTX 2080 Ti 也接近翻倍。社区已发布多个 GitHub 开源项目和安装教程,Windows 11 上也有成功复现案例。不过有用户实测发现 token 输出速度反而下降,实际效果仍待验证。

技术 › 硬件 Max For AI (@MaxForAI) 2026-10-263.2 KB 76

手把手带你解锁 N 卡隐藏算力(Linux|RTX 30 系部分型号、4090、4070 Ti SUPER)

作者分享了 Linux 下使用 gpu-unlock 项目解锁 NVIDIA 显卡 Tensor Core 算力限制的实践。该项目通过在驱动加载前修改控制运算速度的寄存器,解除 FP16/BF16 输入、FP32 累加运算的限速。作者在 RTX 4070 Ti SUPER 上用 Codex 辅助完成兼容性检查、编译模块、创建实验启动项和断电重启等步骤,实测 8192×8192 矩阵 FP16 乘法耗时从 12.15ms 降至 6.49ms,吞吐接近翻倍至约 190 TFLOPS,且数值校验通过。社区反馈该解锁可使本地大模型 prefill 提速 30%–50%,decode 速度基本不变。

技术 › 工具与效率 铁锤人 2026-10-259.3 KB 57.9K 105 83

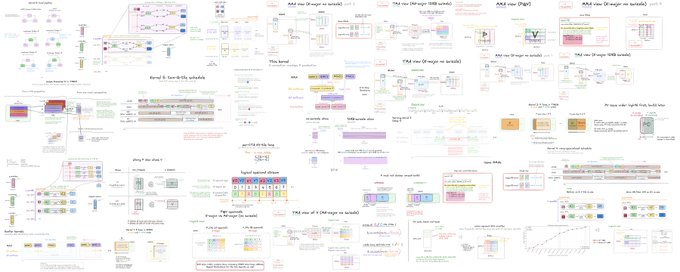
FlashAttention-4 from Scratch to Near-SOTA in 60 Diagrams (cuda/ptx)

作者以60张图解的方式,从零开始在CUDA和少量PTX上构建B200的dense attention kernel,最终达到FlashAttention-4在4K/8K/16K序列长度下94.4%的性能。文章从baseline kernel讲起,逐步介绍每个优化,包含14个kernel的渐进式实现,重点分析Blackwell硬件上softmax与tensor core不对称扩展带来的瓶颈,并通过将softmax开销降低和与matmul重叠来优化。最后将kernel接入视频生成模型作为capstone项目。代码开源,适合GPU kernel研究入门。

技术 › 编程语言 Iaroslav Elistratov 2026-09-1566.6 KB 23.3K 316 92