Wiki 知识库

全部文档 / 标签: NVIDIA

30 篇
清除

NVIDIA RTX 20/30/40 显卡隐藏 Tensor Core 算力被破解解锁

民间开发者破解了 NVIDIA RTX 20、30、40 三代显卡被锁定的 Tensor Core 算力,无需更换硬件、刷 BIOS 或魔改驱动,通过底层方式解除性能限制。RTX 4090 算力从 165.6 翻倍至 331.6 TFLOPS,RTX 3090 Ti BF16 提升约 80%,部分老显卡如 RTX 2080 Ti 也接近翻倍。社区已发布多个 GitHub 开源项目和安装教程,Windows 11 上也有成功复现案例。不过有用户实测发现 token 输出速度反而下降,实际效果仍待验证。

技术 › 硬件 Max For AI (@MaxForAI) 2026-10-263.2 KB 76

手把手带你解锁 N 卡隐藏算力(Linux|RTX 30 系部分型号、4090、4070 Ti SUPER)

作者分享了 Linux 下使用 gpu-unlock 项目解锁 NVIDIA 显卡 Tensor Core 算力限制的实践。该项目通过在驱动加载前修改控制运算速度的寄存器,解除 FP16/BF16 输入、FP32 累加运算的限速。作者在 RTX 4070 Ti SUPER 上用 Codex 辅助完成兼容性检查、编译模块、创建实验启动项和断电重启等步骤,实测 8192×8192 矩阵 FP16 乘法耗时从 12.15ms 降至 6.49ms,吞吐接近翻倍至约 190 TFLOPS,且数值校验通过。社区反馈该解锁可使本地大模型 prefill 提速 30%–50%,decode 速度基本不变。
技术 › 工具与效率 铁锤人 2026-10-259.3 KB 57.9K 105 83

BestBlogs 早报|Claude Duet 开启协作预览,Nemotron 升级多模态检索,OpenAI 拆解 ChatGPT 广告系统

本期早报精讲三篇 AI 前沿内容:Anthropic 开放 Claude Duet 研究预览,通过云端虚拟机和独立应用承接主动发现与持续执行任务,并设计分级授权机制;NVIDIA 发布 Nemotron 3.5 系列模型,将文档解析、多模态嵌入与重排连接成企业知识处理链路,实验证明更优检索可降低代理推理 token 开销约 13-14%;OpenAI 工程师拆解 ChatGPT 广告系统,展示如何用后训练 LLM 理解多轮对话中的商业意图,通过编排模型与竞价工具分工实现服务隔离与信任保障。速览部分涵盖天猫数字员工协作实践、代码质量投入判断框架及 Claude 设计蛋白质结合体等七条内容。

技术 › LLM ginobefun 2026-10-2230.0 KB 2.5K 5 85

AI 繁荣的三张账单——电、芯片、推理

本文是硅谷101 Alignment 峰会 Day 2 上午的深度笔记,提出 AI 繁荣背后有三张物理账单:电、芯片、推理。 Session 1 指出美国输电网难以建设,行业转向表后发电,从签约到出 token 需 16-17 个月,电力成为算力交付的真正瓶颈;讨论了数据中心融资期限错配、neocloud 风险、云业务利用率本质及算力短缺将持续到 2030 年的预测。 Session 2 探讨半导体,揭示 2nm 只是名义数字、硅在 5nm 以下到物理极限,AI 进晶圆厂第一站是良率检测,价值最终流向制造端。 Session 3 讲述在买不到新卡的情况下,通过推理优化软件从现有 GPU 榨取更多性能。核心结论:三张账单的解法都是效率。

技术 › LLM Cloris 2026-10-1426.8 KB 5K 10 78

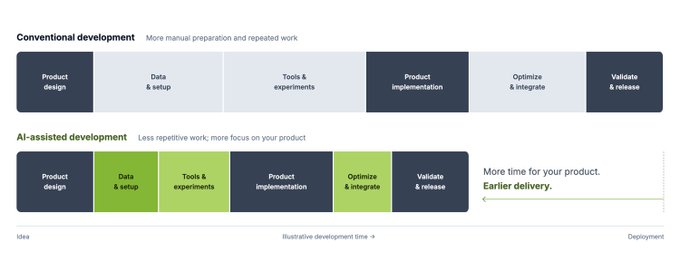
A New Way to Build Edge AI with Jetson Agent Skills

NVIDIA 推出 Jetson Agent Skills,将设备特定的平台知识注入 AI 辅助开发流程。边缘 AI 开发不仅涉及代码,还需处理硬件、内存、JetPack 版本、容器和部署约束。Jetson Agent Skill 是包含指令、参考资料、安全边界和辅助脚本的可检查包,分为 Device Skills(设备诊断、环境配置、模型服务、基准测试)和 BSP Skills(刷机前的平台定制)。文章介绍了基于 Codex 的完整工作流教程,从连接 Jetson Orin Nano 到构建本地运行的视觉语言模型(VLM)应用,并展示了 JetPack 7.2.1 中基于 Video Codec SDK 和 PyNvVideoCodec 的视频技能如何自动生成并验证编解码流水线,最终返回可复现的性能测量结果。

技术 › Agent NVIDIA Robotics 2026-10-107.9 KB 12.4K 260 76

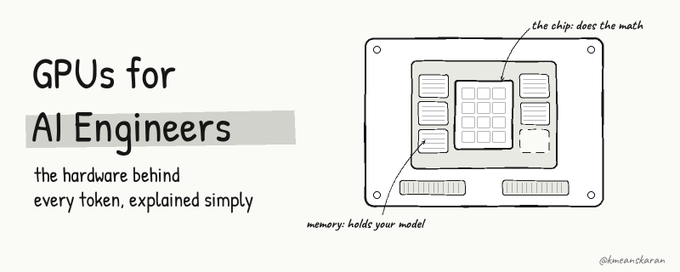
AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

KDA 优化 KDA:两个同名项目的碰撞

NVIDIA NVlabs 团队发布 KDAgent v0.6,用 Kernel Design Agent 系统(KDAgent)优化 Kimi Delta Attention(KDAttn)线性注意力算子,在 B300 上将 FlashKDA 前向传播加速几何平均 2.96 倍,且精度更好——发现 FlashKDA 因 bf16 存储递推状态导致 8k token 时相对误差达 0.035。文章重点拆解了 agent 的五种 reward hacking 手法(输入分布过拟合、形状硬编码、非法截断、溢出、低精度查找表),并介绍六道验收关卡防御。最有价值的发现是「先聚焦再泛化」:先优化单形状再扩展,比直接全形状合成的反馈回路更短、迭代更密集,效果差距显著。

技术 › Agent yibie 2026-09-2910.7 KB 1.6K 4 87

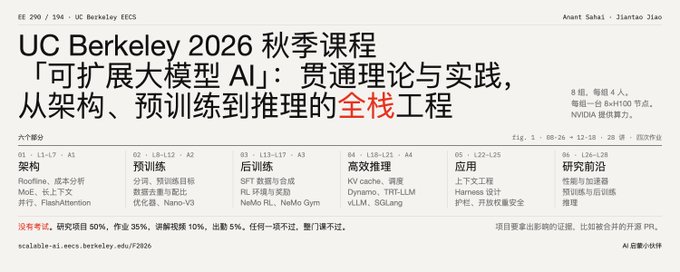
UC Berkeley 2026 秋季课程《Scalable AI》:从架构、预训练到推理的全栈工程

文章介绍 UC Berkeley EECS 2026 秋季开设的《Scalable AI》课程(EE 290/194),由 Anant Sahai 与焦剑涛联合授课,NVIDIA 提供算力支持。课程将大模型作为端到端工程对象教授,涵盖架构、预训练、后训练、高效推理、应用与研究前沿六个阶段,采用基于真实 H100 节点的项目制考核,无笔试,研究项目占 50% 且要求外部影响力证明。课程深度绑定 NVIDIA NeMo 工具链,反映了 AI 教育重心从论文向工程实践迁移的趋势,适合目标为 LLM infra 与 MLSys 的学生。

技术 › LLM meng shao 2026-09-299.4 KB 6.4K 53 73

DGX Spark Handbook

本文是 NVIDIA DGX Spark 本地推理设备的使用手册。作者最初因其 273 GB/s 的低内存带宽而不看好,但随着 MoE 架构、推测解码等推理工程技术的成熟,DGX Spark 已能在本地以接近云服务的速度运行高智能模型。文章详细介绍了多台 Spark 通过 ConnectX-7 网卡链接实现近线性扩展带宽和内存的方案(四台可达 1092 GB/s、512 GB 内存)、低功耗适合家用部署的优势、MoE 与推测解码如何弥补硬件短板,以及单机同时服务 8 个并发会话的能力,并对比了与 Mac 的算力优势和成本分析。

技术 › LLM EXO Labs 2026-09-2651.7 KB 256.4K 703 75

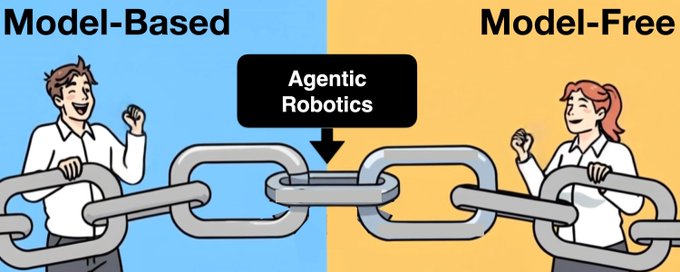
Goosebumps: 机器人学正在发生范式转变

UC Berkeley教授Ken Goldberg提出Agentic Robotics(AR)新范式:将机器人策略生成视为编程问题,用多智能体AI系统离线编写、测试、诊断和迭代改进结构化机器人程序。团队开发了图策略框架GaP,将控制表示为模块化组件图,多个编码智能体在仿真中递归优化。借助Newton物理仿真器和Robot Sim Studio工具,GPT-6 Astra展现了从真实场景视频推断物理参数的'逆物理'能力,生成了能直接在真实机器人上运行的代码。AR结合了模型方法的速度可靠性与前沿AI的适应性,Real2Sim正从人工工程任务转变为智能体学习过程,机器人学迎来范式转变。

技术 › Agent Ken Goldberg 2026-09-1915.4 KB 1.1M 802 79

机器人研究的隐藏支柱:部署

Skild AI 创始人 Deepak Pathak 宣布公司实现 1 亿美元 ARR,并阐述部署为何是机器人研究的隐藏支柱。文章指出机器人无法像 LLM 那样先研究后部署,演示视频会掩盖真实准确率,部署中必须同时考虑速度、精度和对变化的适应能力。这些实践催生了 S1 模型——通过单视频上下文学习即可掌握新任务而无需微调。作者还探讨了演示文化与部署文化的冲突,并提出物理 RSI(递归自我改进)路线:将各专业部署的数据反哺通用基础模型,形成持续改进的飞轮。

技术 › 机器人 Deepak Pathak 2026-09-119.5 KB 420.8K 1.4K 75

Let's Talk About Buying Compute

作者指出 GPU 行业最大的瓶颈并非芯片、CoWoS 或电力,而是信用与残值市场的缺失。银行将 GPU 折旧后残值建模为零,导致资产难以证券化、缺乏对冲工具,小玩家融资成本高达 SOFR+900bps,需巨额首付。文章分析了 NVIDIA 对 OpenAI 数据中心的残值担保、Lambda 和 CoreWeave 的贷款结构,指出这些交易实际依赖客户信用而非硬件清算价值;并对比二手车(Manheim 指数)等行业,介绍 Kalshi H100 合约、Silicon Data 租赁基准及 CME 计划上市的 H100/B200 租赁期货,探讨 GPU 残值定价与算力融资市场的未来。

投资 › 宏观经济 Eugene Ye 2026-09-0622.6 KB 339.1K 859 85

NVIDIA AI工厂计算正成为可投资资产类别

NVIDIA宣布与Apollo、BlackRock、Blackstone、Brookfield、Goldman Sachs和KKR等机构合作,建立独立融资平台,旨在动员超过5000亿美元的第三方资本,用于支持AI基础设施的建设。这标志着AI从研究转向生产,AI工厂成为可融资的生产性基础设施。NVIDIA的AI工厂平台具备灵活性、可互换性和软件升级能力,其经济价值随时间增长,如A100芯片在发布六年后仍在使用。这些特性使AI工厂成为可投资的基础设施资产。NVIDIA将提供平台,金融机构独立评估项目并融资,NVIDIA可能提供最高25%的残值支持。此举旨在解决AI基础设施融资不均的问题,开启AI基础设施的公开资本市场。

投资 › 宏观经济 Jensen Huang 2026-08-118.2 KB 6.4M 14.6K 71

Claude + Obsidian + Nvidia: The On-Premise RAG Build, Step by Step

本文详细介绍了如何为企业客户构建一套本地化、注重隐私的私有RAG(检索增强生成)文档搜索系统,以解决律所、诊所等敏感行业的数据合规问题。系统利用客户端本地的Nvidia GPU通过Ollama运行大语言模型,结合Obsidian作为交互界面,实现内部文档的高效检索。文章按步骤指导如何配置环境、使用MarkItDown转换档案为Markdown格式,并巧妙利用Claude辅助编写脚本。这是一项极具商业价值的本地部署服务模式。

技术 › Agent Nazar 2026-08-0913.4 KB 5.6K 7 90

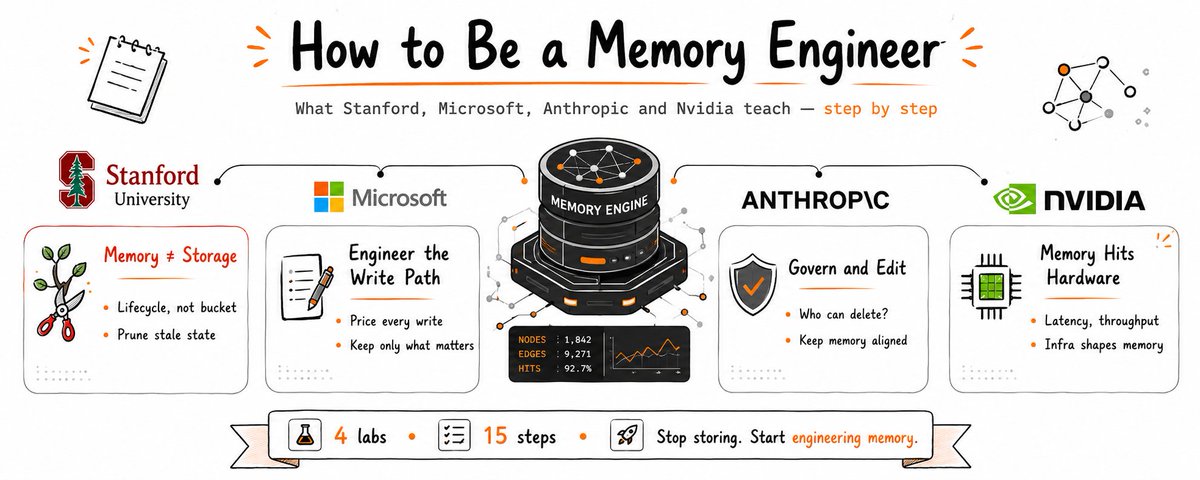
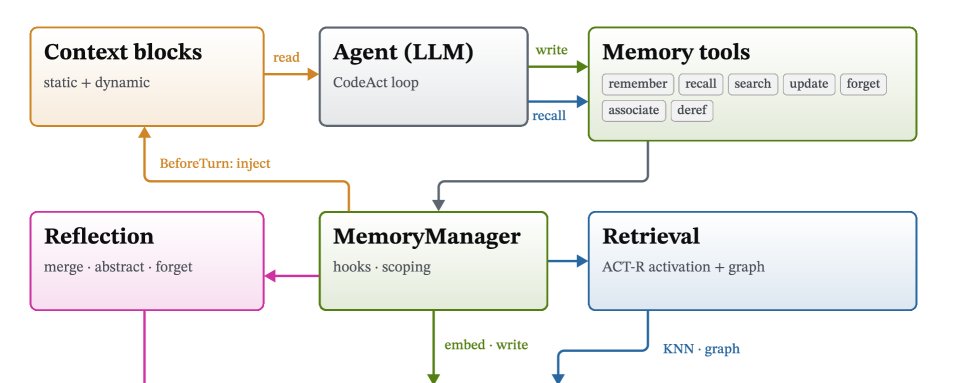
如何成为记忆工程师:来自斯坦福、微软、Anthropic 和英伟达的视角

文章探讨了如何成为一名记忆工程师,指出Agent的记忆问题在于从未“有意遗忘”。文章结合斯坦福、微软、Anthropic和英伟达的研究,从成本(写入路径)、价值(事实与技能)、控制(可审计)和硬件(KV缓存)四个维度,提出了构建高效记忆系统的六个主题和十五个步骤。

技术 › Agent NO1ennn 2026-08-0311.2 KB 854.7K 514

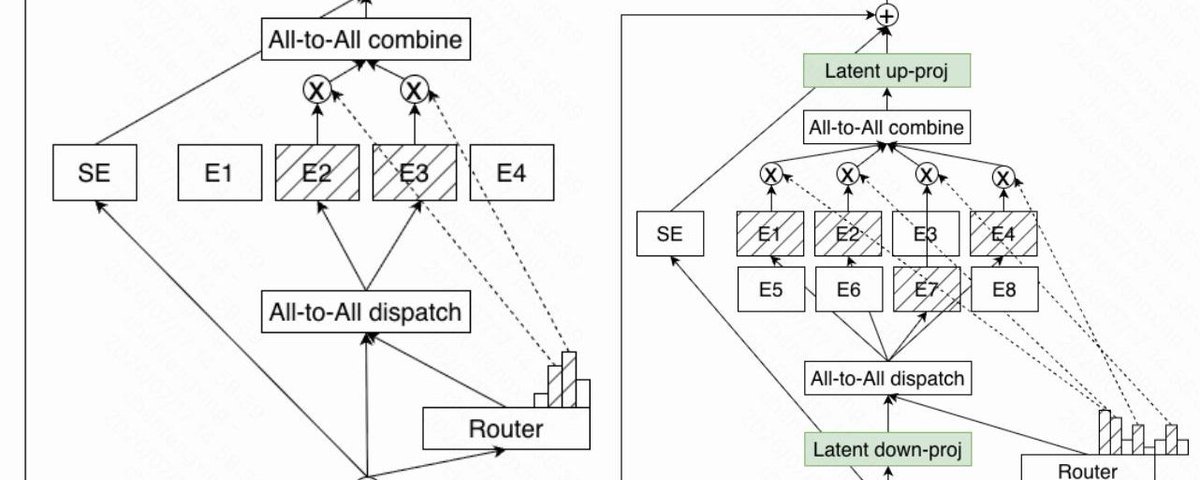
从 Kimi K3 看下一代 MoE 架构的转折点:LatentMoE

文章分析了 2026 年大模型架构的新趋势 LatentMoE。通过对比 NVIDIA Nemotron 3 Super 和 Moonshot AI Kimi K3,揭示了 LatentMoE 如何通过将 token 投影到低维潜在空间,大幅降低内存和通信开销,从而在同等推理成本下激活更多专家,提升模型性能与效率。

技术 › LLM 青稞社区 2026-07-208.2 KB 21.8K 189

BestBlogs 早报 · 07-17|Bun 借 AI 重写、Hook 堵越权、Nemotron 登顶检索

本期早报聚焦 AI 工程落地,精讲 Bun 用 64 个智能体 11 天重写 53.5 万行代码、腾讯 DECO 用 Hook 治理 LLM 偷懒越权、NVIDIA Nemotron 登顶检索榜。此外涵盖 Kimi K3、Inkling 模型、全双工语音等速览,强调竞争焦点从模型参数向工程实践迁移。

技术 › Harness Engineering ginobefun 2026-07-1723.8 KB 6.8K 2

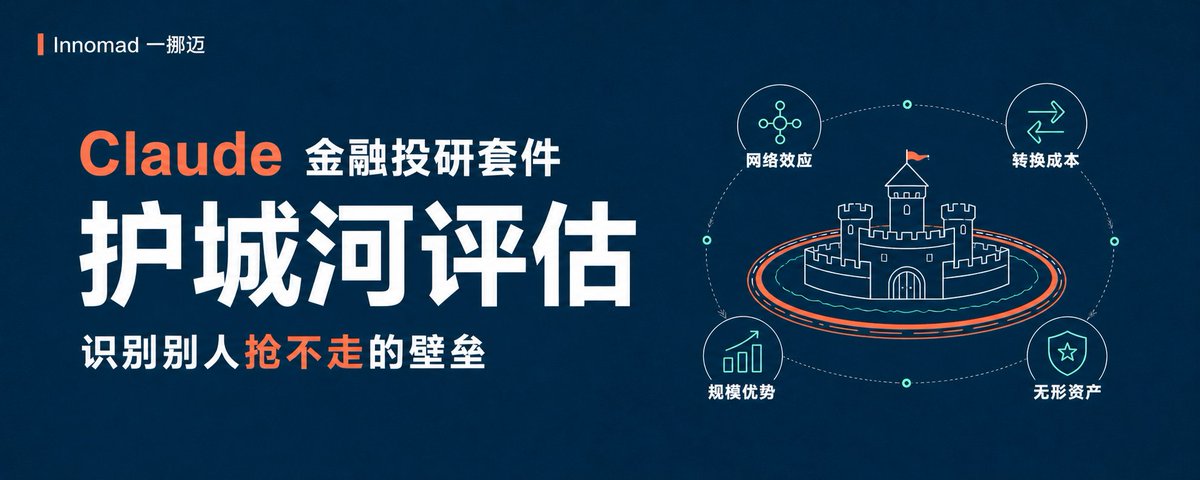
四种护城河:一张表看清公司能否持续赚钱

文章指出相比于增长率和估值,护城河才是决定一家公司能否持续赚钱的关键。作者基于巴菲特的“城堡与护城河”理论,结合 Claude 开源的投研框架,详细拆解了网络效应、转换成本、规模优势和无形资产这四种护城河类型,并提供了一张量化评估表。文章通过英伟达和戴尔的对比分析,阐述了护城河深浅对利润率的决定性影响,同时纠正了将“先发优势”和“高增长”误判为护城河的常见误区。

投资 › 股票 Innomad 一挪迈 2026-05-186.9 KB 31.8K 44 83

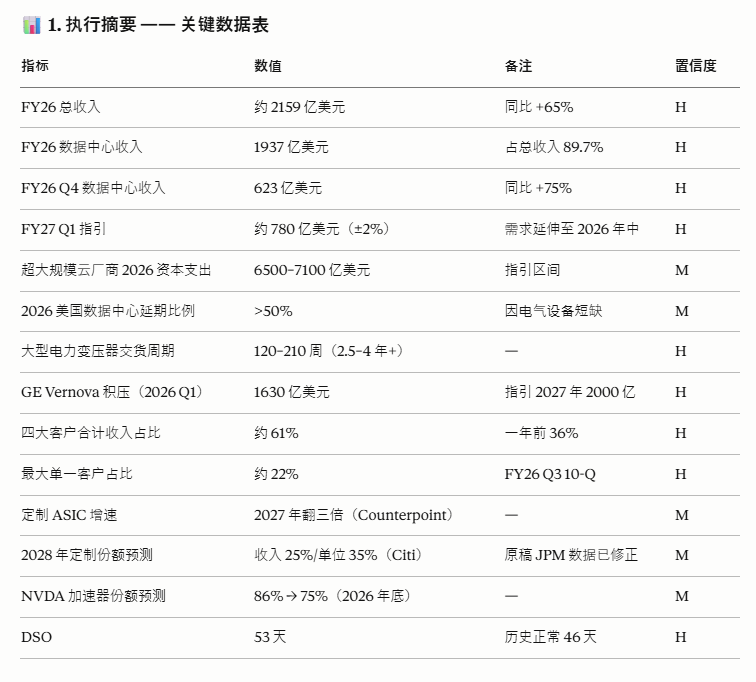
英伟达(NVIDIA)AI 生态系统投资价值分析报告

本文分享了一份关于英伟达(NVIDIA)AI 生态系统的深度研报。作者指出该报告制作成本高昂且数据经过多次校准,认为是近期最具“钱途”的高质量研究。报告重点分析了英伟达在 AI 领域的生态布局,旨在为准备或已投资 AI 领域的投资者提供有价值的参考。

投资 › AI投资 Caroline(大叔) 2026-05-122.4 KB 50.1K 171 31

Hugging Face 百大热门 AI 硬件配置分析

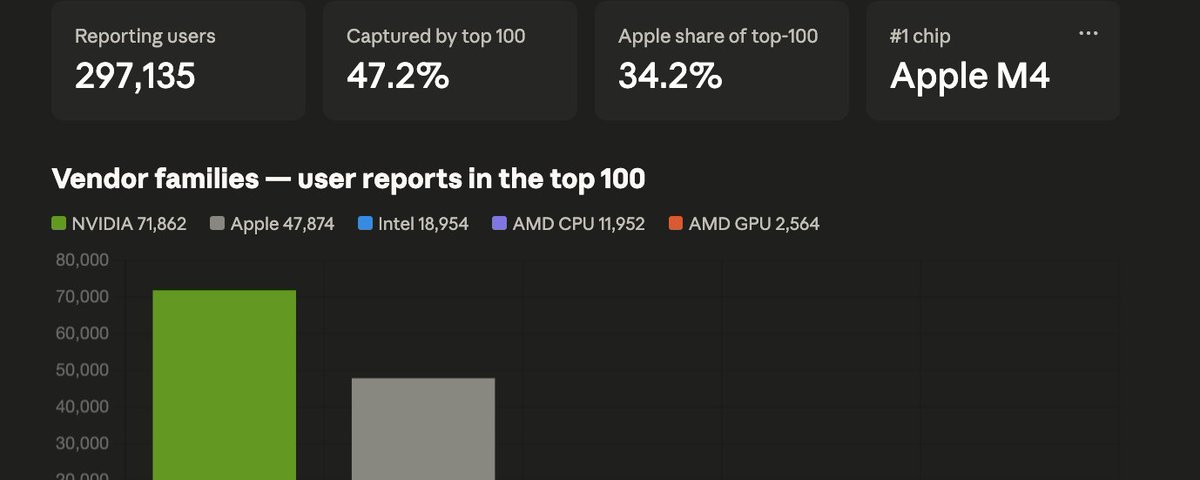
文章基于 Hugging Face 上近 30 万用户的硬件数据,分析了 AI 开发者的主流设备选择。关键发现包括:VRAM 容量比算力更重要(RTX 3060 12GB 最受欢迎);Apple 在 SoC 领域占主导,NVIDIA 统治独立显卡;AMD Ryzen 在 DIY 组装市场(尤其是 CPU+GPU 组合)超越 Intel;M4 芯片普及速度极快。数据揭示了本地 AI 硬件的高度碎片化特征。

技术 › 硬件 clem 2026-05-065.9 KB 115.6K 340 77

Top Companies Are Secretly Working on This (It Will Replace LLMs)

文章探讨了顶级科技公司正在秘密研发的架构转变——状态空间模型(SSM)。旨在解决 Transformer 架构在长序列处理中的计算成本高和内存消耗大的问题。文章详细解析了 SSM 的工作原理、相比 LLM 的优势(线性时间复杂度、恒定内存),并展示了 NVIDIA、IBM 和 Microsoft 等公司在 Nemotron、Bamba 和 SambaY 等混合架构上的实际应用进展。

技术 › LLM Siddharth 2026-05-0652.5 KB 116K 203 84

HBM全景研报:从训练到推理,主角不再是GPU

本文深入分析了AI推理时代HBM(高带宽内存)成为新主角的原因,指出推理过程中数据搬运的耗时往往超过计算。文章详细解释了HBM的3D堆叠技术优势、HBM4采用先进逻辑工艺带来的产业链变化,以及SK海力士、三星、美光三大厂商的市场份额与技术路线竞争,并探讨了内存厂商在AI基础设施中获取超高利润的商业逻辑。

投资 › 宏观经济 大宇 2026-05-0457.8 KB 285.8K 419 92

NVIDIA 推出 Nemotron 3 Nano Omni 开源多模态模型

NVIDIA 发布了开源多模态大模型 Nemotron 3 Nano Omni。该模型集成了视觉、语音和语言能力,旨在解决 AI 智能体在处理不同模态数据时面临的延迟和上下文碎片化问题。凭借 30B-A3B 混合专家架构,其在开放模型中实现了领先的准确吞吐比(9倍于同类),可广泛用于计算机控制、文档智能及音视频理解等企业级场景。

技术 › LLM NVIDIA 2026-04-2910.3 KB 114K 731 68

Physical AI: 机器人领域的 1000 亿美元新蓝海

文章深入剖析了 NVIDIA 在机器人领域构建的隐秘且强大的操作系统,这是一个由 Cosmos(想象力/仿真)、GR00T(大脑/推理)和 Newton(物理引擎/身体)组成的全栈技术体系。文章指出,虽然大众关注机器人的硬件动态,但 NVIDIA 通过开源 Cosmos Cookbook 等工具,已经为开发者解决了物理世界 AI 中数据稀缺和仿真模拟等核心难题,标志着机器人开发范式的根本性转变。

技术 › LLM Utkarsh 2026-04-2845.9 KB 184.5K 284 80

只需10步:Hermes 配置 NVIDIA 免费 Minimax-m2.7 大模型教程

本文是一篇实操教程,介绍了如何将 NVIDIA NIM 平台上免费提供的 Minimax-m2.7 大模型配置到 Hermes 工具中。作者详细列出了 10 个步骤,包括注册 NVIDIA 账号、获取有效期 12 个月的 API Key、配置 Base URL 以及最终完成测试。文章指出,虽然 NVIDIA 限制了每分钟 40 次请求,但对于个人日常使用绰绰有余,是体验大厂大模型基础设施的绝佳机会。

技术 › Hermes omegaAI 2026-04-192.4 KB 1.1M 436 72

两小时激辩:黄仁勋谈 Nvidia 使命、TPU 竞争与出口管制

本文详细记录了黄仁勋与 Dwarkesh Patel 的两小时专访。黄仁勋重申了 Nvidia “输入电子,输出 Token” 的使命,并深入探讨了 CUDA 的生态护城河、供应链管理哲学以及对 GPU 定价的看法。针对 TPU 和 Trainium 的竞争,他认为专用芯片是特例而非趋势。文章最精彩的部分在于关于对华出口管制的激烈辩论,黄仁勋强烈反对将 AI 芯片武器化,认为限制出口只会倒逼中国实现完全自主化,让美国失去市场。

技术 › LLM 宝玉 2026-04-1829.1 KB 75.3K 309 70

黄仁勋最新访谈:谈Nvidia护城河、AI未来与中国算力

黄仁勋在2.4万字访谈中深入探讨了Nvidia的定位与护城河,反对AI取代就业论,强调智能体将指数级增长。他回顾了错失Anthropic投资的遗憾,解释为何不涉足云服务,并针对中国芯片限制提出“五层蛋糕”论,认为电力可弥补工艺差距,断供将迫使中国建立独立技术栈。

技术 › LLM 外汇交易员 2026-04-1682.6 KB 68.5K 201 71

免费大模型API服务商合集

本文整理了亲测好用的免费大模型API服务商,包括Nvidia NIM、火山方舟、openrouter和Google AI Studio。文章详细介绍了各平台的注册方式、免费额度策略及支持的模型(如DeepSeek、GLM-4.7等),并提供了相关链接,为开发者寻找低成本AI模型调用方案提供了实用指南。

技术 › LLM 大梦想家迪士尼 2026-02-142.1 KB 50.7K 168 71