Knowledge Flywheels Yisong Yue 2026-08-06 5.6 KB 138.3K 944 ☆ 收藏 𝕏 文章列表 文章提出了一个新的扩展维度——知识扩展。通过将代理的经验转化为可复用的知识,形成知识飞轮,从而提升智能体的性能和自我改进能力。知识扩展不仅能简化代理,还能训练更明智的模型,为递归自我改进提供新路径。 Knowledge FlywheelAgentLLMSelf-ImprovementAI # Knowledge Flywheels **作者**: Yisong Yue **日期**: 2026-08-05T16:42:27.000Z **来源**: [https://x.com/yisongyue/status/2085043769297277114](https://x.com/yisongyue/status/2085043769297277114) --- 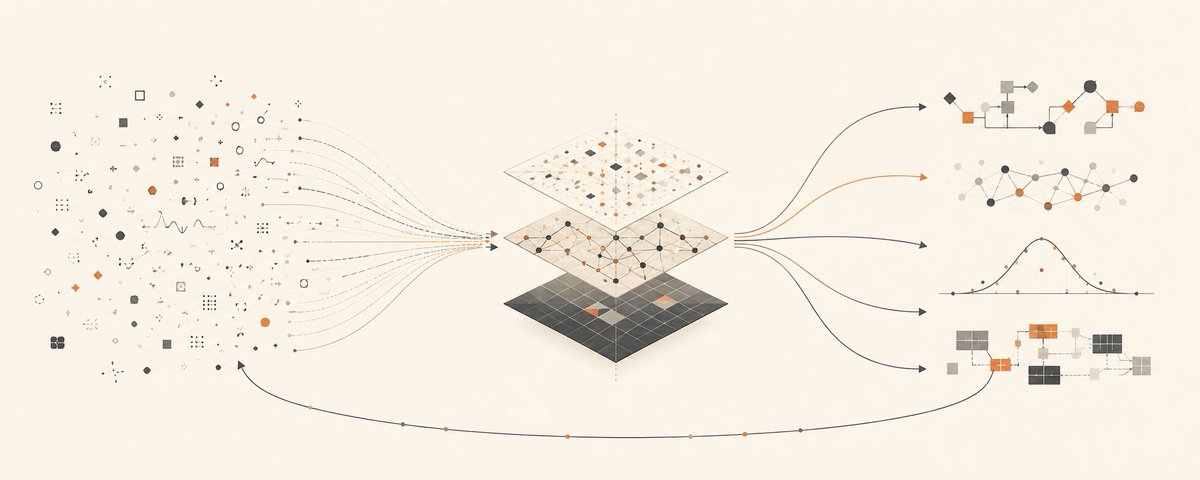 ## A new scaling dimension is emerging Today, we scale models through better data, architectures, and compute. We scale agents through better tools, search, verification, and harnesses. Tomorrow, we will also scale knowledge. Here, knowledge means reusable insights distilled from agent experience: what works, what fails, when, and why. Model scaling improves the reasoner. Agent scaling expands what it can do on a task. Knowledge scaling improves what the next task can build on. ## From experience to knowledge AI systems generate far more experience than they convert into reusable knowledge. Agents discover architectural constraints, recurring failures, better search and verification strategies, and relationships across datasets or experiments. Without curation, these lessons remain tied to individual runs and must be rediscovered. A knowledge flywheel works in two directions: it turns repeated experience into reusable abstractions, then applies them back to new situations. Software work can yield principles for modifying large codebases or optimizing complex stacks; scientific analyses can yield skills for combining evidence, deciding what generalizes, and choosing what to measure next. 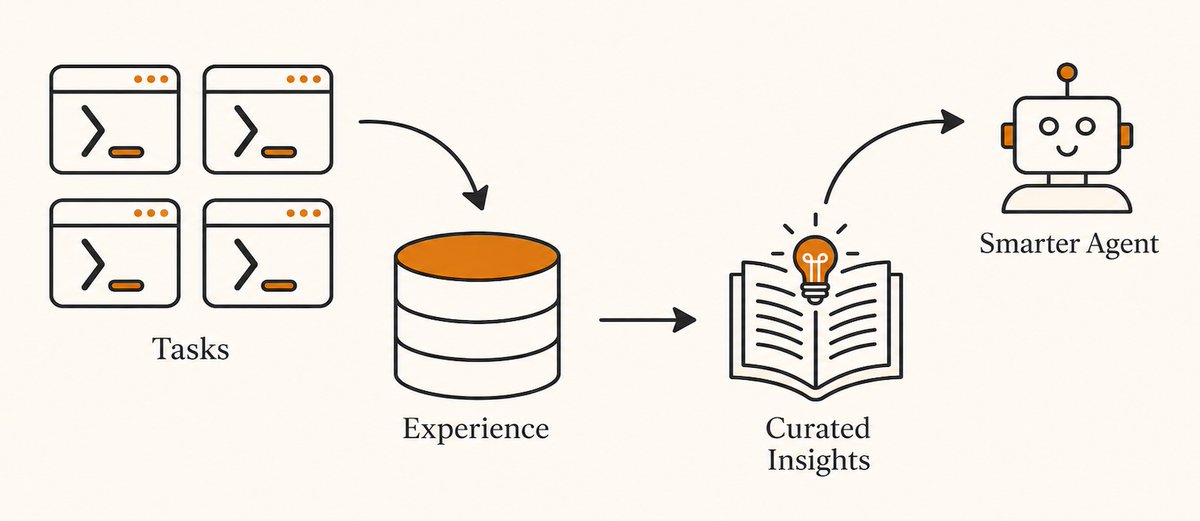 Knowledge flywheels distill experience into insights, which leads to smarter agents. Our recent work on knowledge-centric self-improvement tests this idea in a controlled experiment. Generic, disposable agents contribute and critique evidence, which is distilled into a shared knowledge base for future agents. Across reasoning, coding, and terminal tasks, this approach improves performance at substantially lower cost than more elaborate agent-centric self-improvement systems. Early versions of this idea are already emerging in the wild. EinsteinArena lets agents tackle open mathematical problems through repeated submissions, verifier feedback, and refinement of one another’s ideas. This process has already produced new state-of-the-art results, showing how persistent shared artifacts can turn isolated agent runs into cumulative discovery. ## Knowledge simplifies agents Knowledge scaling can move reusable structure out of runtime search. Rather than rediscovering task representations, decompositions, checks, and failure modes on every run, automated harness engineering can begin from accumulated knowledge: task + model + tools + knowledge → task-specific harness The persistent asset is not one harness, but the knowledge from which many harnesses can be constructed. One example is Trace2Skill, which distills lessons from pools of execution traces into transferable, declarative skills. This pattern is also appearing in production. At Asari AI, agents optimize the entire inference stack through repeated cycles of implementation, evaluation, and verification. Each campaign leaves behind improved code and reusable lessons, so later agents inherit a better process and not just a better result. ## Knowledge can train wiser models Knowledge curation also enables on-policy distillation. Models near the edge of their competence generate experience that exposes their weaknesses. Instead of training on raw traces, a knowledge flywheel can compare runs and extract what generalizes: which strategies transfer, which failures recur, what evidence changes the conclusion, and where a rule breaks. That curated knowledge can become targeted supervision for the next model, or be encoded into reusable learned memory through systems such as Cartridges or MeMo. The goal is to teach models something closer to judgment: not just what worked, but when, why, and how broadly the lesson should be trusted. ## A new path to recursive self-improvement Knowledge flywheels offer a different path to recursive self-improvement: the system improves not only its solutions, but how it extracts, tests, and organizes knowledge. Those improvements produce stronger agents, leading to more effective future curation. The need is clearest where evidence exceeds what any one person or agent can synthesize. HuBMAP, the DANDI Archive, and Gaia span vast bodies of scientific evidence; large software ecosystems distribute knowledge across code, hardware, tests, logs, and operational experience. Progress depends on abstractions that connect these pieces. The payoff is compounding synthesis: each analysis improves the next, each failure sharpens future tests, and each abstraction enables a higher level of synthesis. The next scaling frontier is not only larger models or more elaborate agents. It is systems that get better at turning experience into knowledge. ## 相关链接 - [Yisong Yue](https://x.com/yisongyue) - [@yisongyue](https://x.com/yisongyue) - [11K](https://x.com/yisongyue/status/2085043769297277114/analytics) - [EinsteinArena](https://einsteinarena.com/) - [Trace2Skill](https://arxiv.org/abs/2603.25158) - [Cartridges](https://arxiv.org/abs/2506.06266) - [MeMo](https://arxiv.org/abs/2605.15156) - [Upgrade to Premium](https://x.com/i/premium_sign_up) - [12:42 AM · Aug 6, 2026](https://x.com/yisongyue/status/2085043769297277114) - [11.5K Views](https://x.com/yisongyue/status/2085043769297277114/analytics) - [View quotes](https://x.com/yisongyue/status/2085043769297277114/quotes) --- *导出时间: 2026/8/6 18:08:49* --- ## 中文翻译 # 知识飞轮 **作者**: Yisong Yue **日期**: 2026-08-05T16:42:27.000Z **来源**: [https://x.com/yisongyue/status/2085043769297277114](https://x.com/yisongyue/status/2085043769297277114) ---  ## 一个新的扩展维度正在出现 今天,我们通过更好的数据、架构和算力来扩展模型。我们通过更好的工具、搜索、验证和约束来扩展智能体。 明天,我们还将扩展知识。 在这里,知识指的是从智能体经验中提炼出来的可重用见解:什么有效、什么无效、何时有效以及为何有效。 模型扩展提升了推理者。智能体扩展扩展了其在任务上能做的事情。知识扩展提升了下一个任务所能构建的基础。 ## 从经验到知识 AI 系统产生的经验远多于其转化为可重用知识的部分。智能体发现了架构约束、反复出现的失败、更好的搜索和验证策略,以及跨数据集或实验的关系。如果没有整理,这些经验仍然局限于单独的运行中,必须被重新发现。 知识飞轮在两个方向上起作用:它将重复的经验转化为可重用的抽象,然后将其应用回新的情况。软件工作可以产生修改大型代码库或优化复杂堆栈的原则;科学分析可以产生结合证据、决定什么具有普遍性以及选择接下来测量什么的技能。  知识飞轮将经验提炼为见解,从而产生更智能的智能体。 我们最近关于以知识为中心的自我改进工作在一个受控实验中测试了这个想法。通用的、一次性的智能体贡献并评判证据,这些证据被提炼成供未来智能体使用的共享知识库。在推理、编码和终端任务中,这种方法以比更复杂的以智能体为中心的自我改进系统低得多的成本提高了性能。 这个想法的早期版本已经在现实中出现。EinsteinArena 允许智能体通过反复提交、验证器反馈和改进彼此的想法来解决开放的数学问题。这个过程已经产生了新的最先进结果,展示了持久的共享工件如何将孤立的智能体运行转化为累积发现。 ## 知识简化了智能体 知识扩展可以将可重用的结构从运行时搜索中移出。自动化约束工程可以从积累的知识开始,而不是在每次运行中重新发现任务表示、分解、检查和失败模式: 任务 + 模型 + 工具 + 知识 → 特定任务的约束 持久的资产不是某一个约束,而是可以构建许多约束的知识。一个例子是 Trace2Skill,它将执行轨迹池中的经验教训提炼为可迁移的、声明式的技能。 这种模式也出现在生产环境中。在 Asari AI,智能体通过实施、评估和验证的重复周期来优化整个推理堆栈。每次活动都会留下改进的代码和可重用的经验教训,因此后来的智能体继承的是一个更好的过程,而不仅仅是一个更好的结果。 ## 知识可以训练更明智的模型 知识整理还支持在策略蒸馏。处于其能力边缘附近的模型产生的经验暴露了它们的弱点。知识飞轮可以比较运行并提取具有普遍性的内容:哪些策略可迁移,哪些失败会反复出现,什么证据会改变结论,以及规则在哪里失效,而不是在原始轨迹上进行训练。 那些整理过的知识可以成为下一个模型的有针对性的监督,或者通过 Cartridges 或 MeMo 等系统编码到可重用的学习记忆中。目标是教给模型更接近判断力的东西:不仅仅是什么有效,还包括应该在何时、何地以及多大程度上信任这个经验教训。 ## 递归自我改进的新路径 知识飞轮为递归自我改进提供了一条不同的路径:系统不仅改进其解决方案,还改进其提取、测试和组织知识的方式。这些改进产生更强的智能体,从而带来更有效的未来整理。 在证据超过任何一个人或智能体所能综合的范围时,这种需求最为明显。HuBMAP、DANDI Archive 和 Gaia 涵盖了大量的科学证据;大型软件生态系统将知识分布在代码、硬件、测试、日志和运营经验中。进步取决于连接这些部分的抽象。 回报是复合的综合:每次分析都改善下一次分析,每次失败都完善未来的测试,每个抽象都使更高层次的综合成为可能。 下一个扩展前沿不仅是更大的模型或更复杂的智能体。而是那些更善于将经验转化为知识的系统。 ## 相关链接 - [Yisong Yue](https://x.com/yisongyue) - [@yisongyue](https://x.com/yisongyue) - [11K](https://x.com/yisongyue/status/2085043769297277114/analytics) - [EinsteinArena](https://einsteinarena.com/) - [Trace2Skill](https://arxiv.org/abs/2603.25158) - [Cartridges](https://arxiv.org/abs/2506.06266) - [MeMo](https://arxiv.org/abs/2605.15156) - [Upgrade to Premium](https://x.com/i/premium_sign_up) - [12:42 AM · Aug 6, 2026](https://x.com/yisongyue/status/2085043769297277114) - [11.5K Views](https://x.com/yisongyue/status/2085043769297277114/analytics) - [View quotes](https://x.com/yisongyue/status/2085043769297277114/quotes) --- *导出时间: 2026/8/6 18:08:49*
在 在加州待了快两周,聊聊 AI,也聊聊生活 作者受 AWS 邀请赴加州参加活动,从北加到南加待了近两周。文章分享了对 AI 圈的观察:华人众多、双语优势明显但英文口语仍是刚需;理解 LLM agent 架构和模型能力边界的重要性;湾区活动多但需选择性参与;常刷 X 可保持信息不落后。生活方面,作者感受了湾区高昂的生活成本与房租,认为加州不能代表美国全貌,同时对美国的物价、小费文化和 Waymo 无人驾驶体验发表了看法。 生活 › 随笔 E Elliot 艾略特 2026-10-12 AI加州湾区LLMAgent英文学习Waymo生活成本小费创业
T The Future of Software Development 作者展望了未来5-10年软件开发的变化:AI模型正以每半年约10倍的速度变强,未来将极其智能、快速且廉价。开发模式将从IDE自动补全,演进到终端中的AI编码代理,最终只需用自然语言或语音告诉计算机想要什么,AI代理即可自动完成构建、测试、修复和上线。文章还探讨了为AI代理设计的意图式操作系统(无需UI)、为每个用户动态生成的应用界面、面向AI代理的新协议(如MCP),以及未来5-10年最抢手的技能,强调经验与意图表达能力将比手写代码更重要。 技术 › LLM Amit Shekhar 2026-09-27 AI软件开发LLMAgent操作系统意图驱动MCP未来趋势编程自动化
高 高级 Skill 不是更长的提示词,而是一套组合技 文章探讨了高级 AI Skill 的本质:不是把更多指令塞进一份文件,而是把多个单点能力按任务关系编排组合。作者通过分析 GitHub 上多个热门 Skill 仓库,总结出五种组合模式:路由(判断调用哪个 Skill)、顺序(强制工作流程)、选择(按需分诊组合)、流水线(专业能力交接)和分层(Skill 与系统能力分工)。文章提出组合 Skill 的五个核心零件:路由、输入输出契约、顺序与并行、上下文状态、验证反馈,并建议从真实返工中逐步长出组合关系。核心观点:Prompt 让 AI 听懂一次需求,Skill 固化一类做法,而组合 Skill 才能把复杂任务交付出来。 技术 › Skill Wattter 2026-09-16 SkillAgentLLM提示词工作流编排Claude自动化GitHubAI
月 月入百万的电商全流程(北大研发)是如何搭建的(完全开源) 作者分享了其搭建的AI跨境电商指挥中心系统的完整架构与实践。系统涵盖客户发现、调研、SEO、客服、报价、订单分析等模块,通过统一的AI网关接入多个AI项目,实现成本、Token、延迟、错误率的统一监控,并提供预算预警、Prompt版本管理和API Key安全等能力。文章还讲解了电商财务模型(毛利、获客成本、复购)和业务流程拆解方法,强调把AI项目从黑盒变成可管理、可复盘的经营数据,最终形成一套每天自动运转的电商业务机器。 技术 › Agent Dean 2026-09-06 AI跨境电商AgentLLM成本管理自动化电商系统Prompt管理创业开源
H Huashu-Excel正式发布:也许是最好用的Excel数据处理和分析skill 花叔开源了名为huashu-excel的AI数据处理分析skill,用户丢入Excel或CSV即可用自然语言完成体检、清洗、对齐、分析、对账、交付、验图、质控八步流程,输出HTML/Excel/Word等格式报告。该skill针对大模型算错不报错的缺陷设计了合计对账、外部基准校验、独立agent复核等机制,并借鉴Anthropic角色激发研究提升分析质量。经十份真实公开数据(106万行电商明细、纽约市政预算等)压测,能独立拆解辛普森悖论、识别脏数据并给出可审计的业务结论。兼容Claude Code、Codex等多种agent,MIT协议开源。 技术 › Skill 花叔 2026-08-24 Excel数据分析AgentAI开源数据清洗数据可视化LLMClaude自动化报告
A AI界天花板ponytail:让AI学懒人工程师思维,代码量砍半 本文介绍了开源项目ponytail,该项目在GitHub上拥有91.6k star,其核心哲学是让AI模仿资深工程师的“懒人思维”,优先寻找现成方案或修改配置,避免不必要的代码编写。作者实测发现,ponytail能让AI先思考再动手,自动拆分复杂需求为最小改动,重构老模块时代码量减少近一半。此外,它强制AI编写“为什么这么改”的注释,相当于免费代码审计,对维护老项目尤其有用。作者认为该项目思路独特,不追求跑分,专治AI写码落地难的问题,并推荐给AI方向的开发者。 技术 › 工具与效率 sunmer 2026-08-20 AIponytail代码生成代码重构开源项目效率工具LLMAgent代码审计懒人思维
3 30个开源仓库,助力AI业务自动化 本文介绍了30个开源仓库,用于构建自动化AI业务的各个层面,包括市场研究、潜在客户生成、内容创作、销售、支持、自动化、分析和安全。作者强调,没有单一工具能完全自动化业务,而是需要组合多个工具形成系统。文章按功能分类列出每个仓库的GitHub星标、用途和典型应用场景,并提醒读者开源不等于免费,且需注意合规性。 技术 › 工具与效率 Rexei 2026-08-20 开源AI自动化业务LLMAgentCRM爬虫TTS工作流
2 2026年你必须掌握的25个AI核心概念 文章详细列出了2026年理解和构建现代AI系统所必需的25个核心概念。内容涵盖从基础原理(如Tokens、Embeddings)到高级应用(如Agents、RAG),旨在帮助开发者掌握关键技术,忽略无用的营销术语,构建更可靠的AI系统。 技术 › LLM Kanika 2026-08-17 AILLMAgentRAGEmbeddings基础概念系统设计技术教程
H Hermes 登顶背后:一个 Web3 团队的进阶之路 本文深度剖析了 Hermes Agent 在 OpenRouter 上登顶的现象,指出其成功并非源于技术代差,而是精准闭合了“挑战者增长系统”:承接 OpenClaw 教育成熟的用户池,建立“可委托性”体验差异。文章对比了 Hermes 与 OpenClaw 在 Crypto 问题上的不同取向,阐述了 Hermes 作为任务总控层与 Claude Code 等专业 Agent 的分层协作关系,并分析了其商业模式与用户价值公式,揭示了 Web3 背景在组织层面提供的独特优势。 技术 › Agent Jacob Zhao 2026-08-11 HermesOpenClawAgentWeb3AILLM产品分析商业模式增长策略技术架构
A AI 名词小白入门白皮书 本文专为缺乏技术背景的AI初学者撰写,旨在理清AI领域的常见名词。作者将AI系统划分为七个层级,详细拆解了从大模型、产品、Token、RAG、MCP到Agent、Workflow、Loop和Graph等核心概念。文章指出新手常犯的认知混淆,并通过具体的任务案例展示AI系统的工作流程。最后,为初学者提供了从分清对象到理解工具执行的实用学习路径,帮助读者建立完整的AI概念地图。 技术 › LLM Kimberly 2026-08-09 AI名词解释LLMAgentRAGMCPWorkflow小白入门技术科普
L Loop Engineering:如何构建能自我改进的AI智能体 本文探讨了从手动提示AI向“循环工程”转变的新一代工作流。作者指出,真正的循环工程依赖于廉价的长上下文模型来控制Token成本。文章详细对比了旧的手动工作流与新的自动化循环工作流,并深入剖析了单智能体循环与舰队循环(多智能体协同)的区别。同时,强调了在实际应用中应优先采用边界清晰、易于控制的闭环。最后,拆解了构建高效循环系统的六个核心基石:自动化、工作树、技能复用、外部插件、子智能体和检查器,帮助开发者打造可自我迭代和修复的AI系统。 技术 › Agent elune 2026-08-07 AIAgentLoop EngineeringClaude CodeLLM自动化工作流
L Loop Engineering: 11 Steps From Prompting to Loops 文章指出,AI使用的未来在于构建“循环”而非单纯编写提示词。作者以Karpathy的AutoResearch项目为例,阐述了AI如何通过循环自主进行实验和优化。一个有效的循环必须包含验证器、状态记录和停止条件。文章强调,当任务具备可自动化的验证机制且需要重复执行时,应让AI在循环中自我迭代以移除人类瓶颈。最后,文章分享了构建基础AI循环和有效验证器的核心代码模式。 技术 › Agent 0xRafy 2026-08-07 AIAgentLoop Engineering自动化LLMHarness EngineeringKarpathy Loop自动验证