Wiki 知识库

全部文档 / 标签: Embeddings

4 篇
清除

How to Build Agent Memory: Search & Retrieval

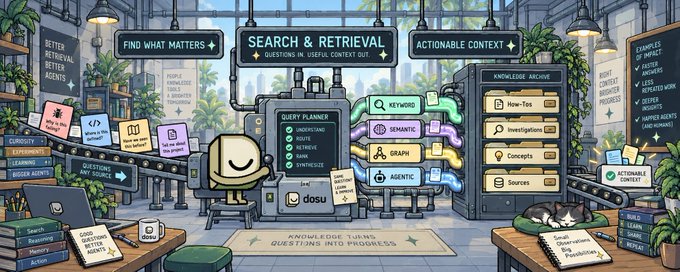
本文是构建 Agent 记忆系统系列的第四篇,聚焦读取路径:如何检索已保存的知识并加以利用。文章首先强调根据问题类型选择检索方式——精确查找、相似案例识别或项目概览各有不同需求。接着对比了四种搜索方法:关键词匹配、语义搜索、图遍历和 Agentic 检索,指出 Agentic 检索能综合运用其他方法并随信息获取调整调查策略。文章还强调检索结果应具备可操作性,一条包含复现步骤和验证方式的笔记远比泛泛的描述更有价值。最后提醒要注重精确度,避免给 Agent 返回过多无关信息造成干扰,因为它可能将小问题扩大成大改动。
技术 › Agent Devin Stein 2026-09-1512.0 KB 6.2K 105 82

How we built our knowledge base

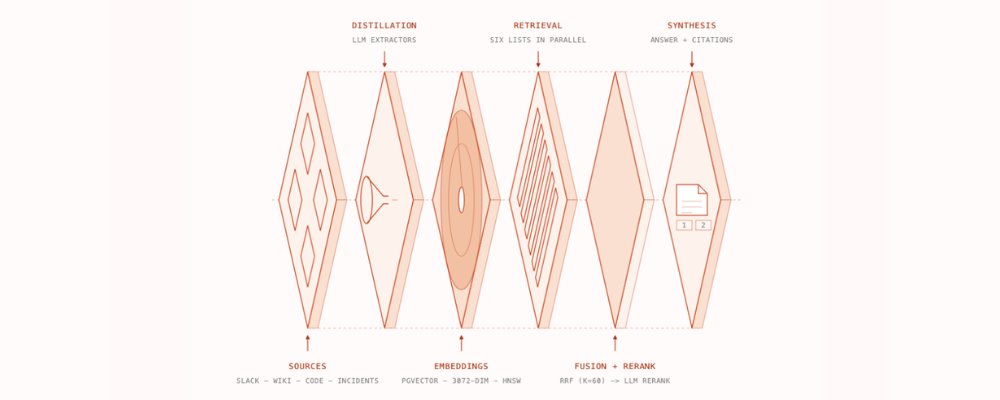
Cerebras 分享了构建其内部知识库的经验。该知识库每天处理超过 15,000 个问题,集成了 Slack、GitHub 等多种数据源。文章详细介绍了如何通过 Postgres 存储 embeddings,并采用混合搜索策略(全文搜索、向量搜索、IDF 加权、时间衰减)来高效检索非结构化对话数据,解决了信息分散和匹配精度的问题。

技术 › DevOps Cerebras 2026-07-18311.2 KB 3.6M 5.6K

开发者在写代码前必须理解的 10 个 AI 核心概念

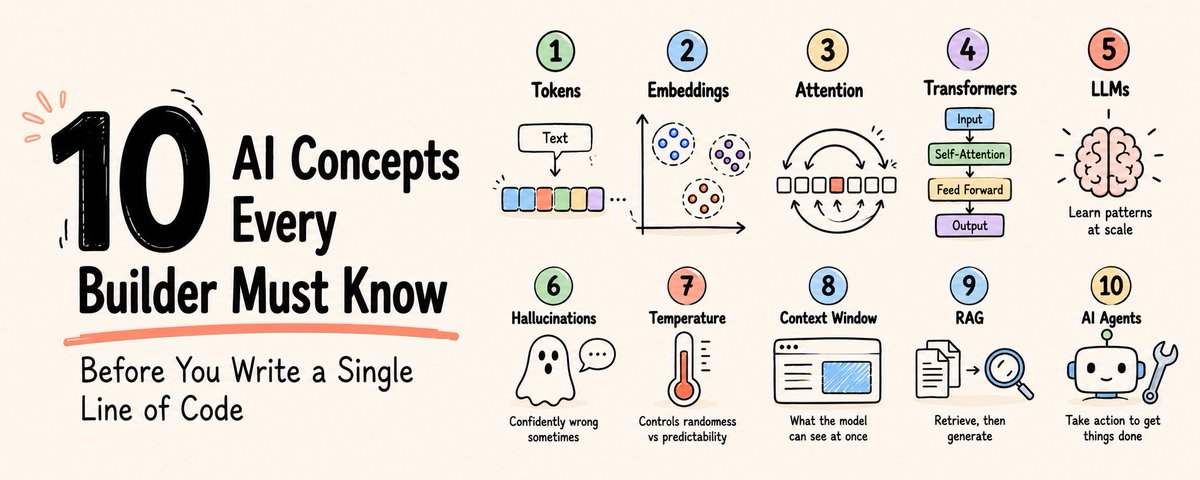
本文阐述了 AI 开发者在编写代码前必须掌握的 10 个核心概念,而非急于动手写代码。文章解释了 Tokens(计费基础)、Embeddings(语义理解)、Attention(上下文机制)以及 Transformers(模型引擎)等原理,深入剖析了 LLM 的本质、幻觉产生的原因、Temperature 对输出的控制作用以及上下文窗口的重要性。理解这些心智模型,能帮助开发者避免盲目调试,构建出更稳定、高效的 AI 应用。

技术 › LLM Rahul 2026-06-0412.8 KB 584.7K 402 76