Wiki 知识库

全部文档 / 标签: 数据清洗

12 篇
清除

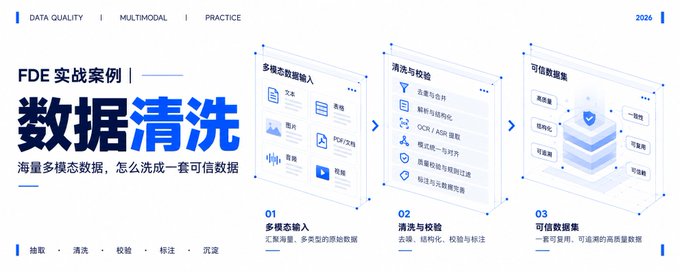
FDE 实战案例:海量多模态数据清洗成可信数据的八步方法

作者以美妆企业 FDE 落地项目为例,讲解如何将小红书、抖音、视频号、微博等平台采集的多模态数据(文字、图片、音频、视频)清洗成一套可信、可查询的结构化数据。文章提出八步通用链路:定数据规范、保留原始内容、梳理用户/帖子/评论关系、多模态归一处理、冲突与质量清洗(含证据分级)、生成结构化数据、执行验收、按规则和版本入库。文中还给出 OCR/ASR 工具选型建议(FFmpeg、PaddleOCR、Whisper 等)以及大模型结构化输出的实践经验。

技术 › 后端 Miles Ma 2026-10-2712.9 KB 5.8K 61 86

高阶教程:如何合规榨干 Muse 2核8G 虚拟机的算力?

本文是一份手把手教程,教读者如何合规充分利用 Muse 平台赠送的 2核8G/100G Linux 虚拟机算力。作者通过真机测试证明反弹 Shell 等黑客手段会被 Sentinel 拦截封号,转而介绍合规方案:在 /home/hatch/pdata 持久化目录搭建工作区,编写 Python 数据清洗脚本(Z-Score 异动分析),配置官方 Scheduled Task 实现关机后云端自动唤醒执行任务,并利用 Artifact 功能一键生成交互式数据看板。最后给出三条防封铁律:不碰反向 Shell、代码数据存入持久化目录、用定时任务代替本地挂机,实现零成本拥有 7×24 小时云端数据中枢。

技术 › 工具与效率 梭哈.AI 2026-09-2712.3 KB 115.3K 241 80

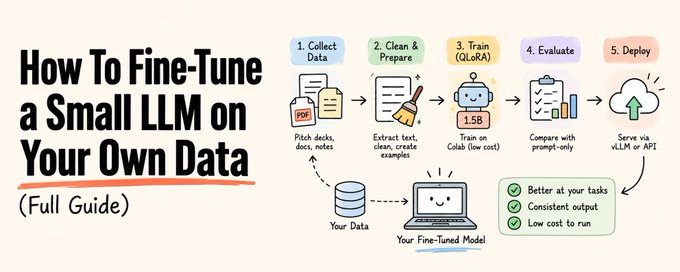
How To Fine-Tune a Small LLM on Your Own Data (Full Guide)

这是一篇关于微调小型LLM的完整实战指南。作者指出不需要70B大模型或昂贵算力,1.5B参数模型在200-500个优质样本上微调后,可在特定任务上超越通用提示的前沿模型。文章以商业融资文案生成为例,详细讲解了微调的实际目标、建立基线(纯提示、RAG、微调)的先后顺序,并分步骤介绍了小型基座模型选择(如Qwen2.5-1.5B)、数据权利合规、可复现数据下载、PDF文本提取与OCR、文本清洗、训练数据集构建、QLoRA训练、评估与部署,每一步均附完整代码。

技术 › LLM Rahul 2026-09-1926.1 KB 2.5M 2.7K 86

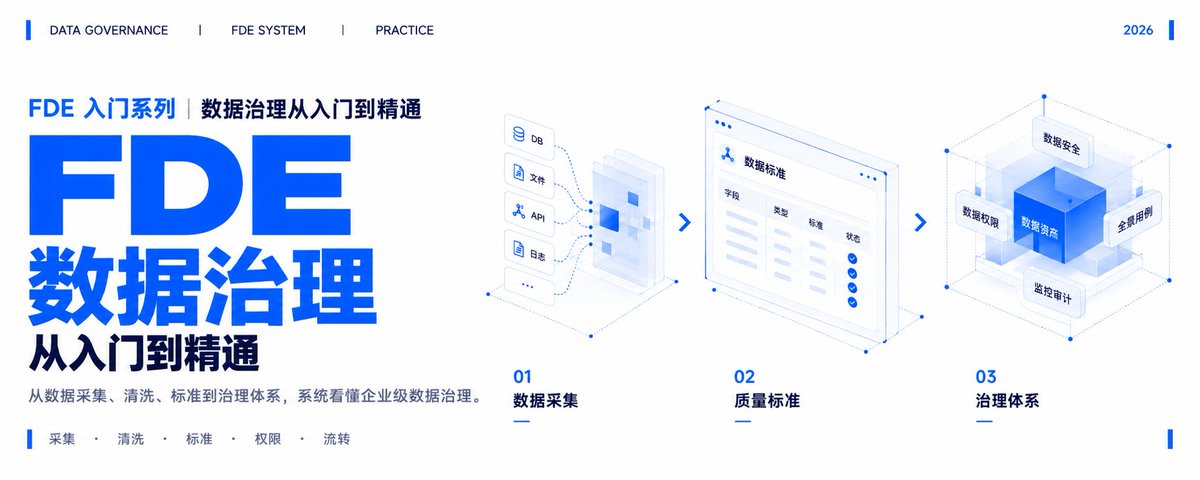
FDE 系列教程|数据治理从入门到精通

本文是 FDE(前沿部署工程师)系列教程,强调企业上 AI 的前提是做好数据治理。作者以纸质维修单、扫描产品手册和 Excel 配件表为例,讲解完整流程:确认用途、盘点原件、扫描采集、OCR 与解析、清洗核对、验收发布、持续维护。文章介绍了 OCRmyPDF、PaddleOCR、OpenRefine、DuckDB 等开源工具的组合使用,涵盖表格解析、字段口径统一、重复与版本处理、权限管理、人工抽查验收等实操细节,并指出 AI 应先进入待核队列而非直接覆盖正式数据。数据理顺后,再接入知识库和 AI 才能真正落地。

技术 › 数据治理 Miles Ma 2026-09-0915.7 KB 58.1K 249 91

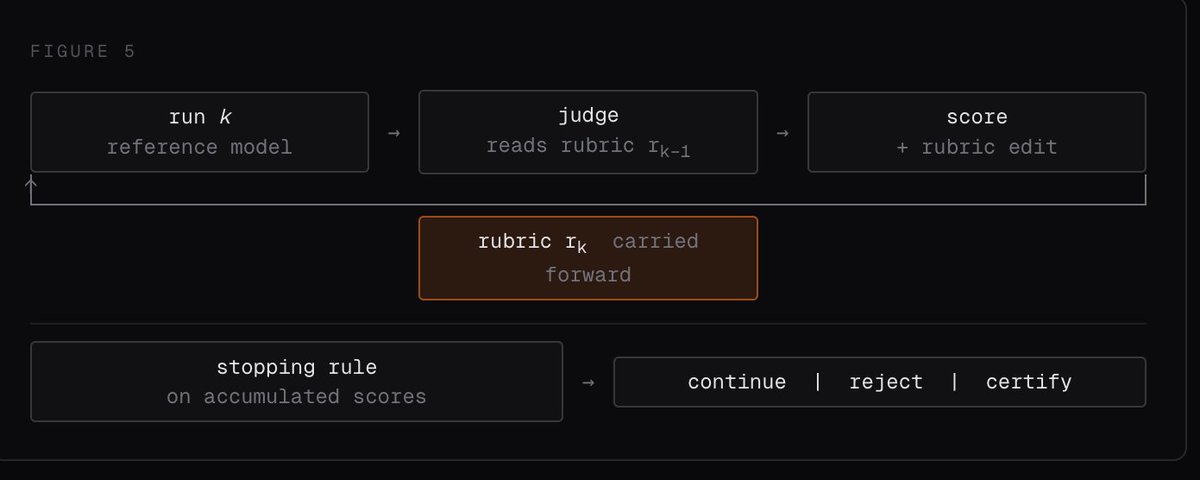
如何基于真实用户流量构建可扩展的长时程浏览器 RL 环境

本文介绍如何从数亿条真实生产环境的浏览器代理任务流量中构建可扩展的强化学习环境。方法包括:去重与过滤不当任务、用对齐的标注代理(Gemini 3 Flash)筛选适合的任务、以标准虚拟身份替换个人数据、通过参考模型执行验证任务可行性与难度。文章还探讨了评判问题的核心思路:评分模型无需比代理更聪明,只需看到同一任务的大量尝试分布,从而构建公平稳定的奖励机制。

技术 › Agent Alexander Yue 2026-08-2718.3 KB 24.8K 93 77

Huashu-Excel正式发布:也许是最好用的Excel数据处理和分析skill

花叔开源了名为huashu-excel的AI数据处理分析skill,用户丢入Excel或CSV即可用自然语言完成体检、清洗、对齐、分析、对账、交付、验图、质控八步流程,输出HTML/Excel/Word等格式报告。该skill针对大模型算错不报错的缺陷设计了合计对账、外部基准校验、独立agent复核等机制,并借鉴Anthropic角色激发研究提升分析质量。经十份真实公开数据(106万行电商明细、纽约市政预算等)压测,能独立拆解辛普森悖论、识别脏数据并给出可审计的业务结论。兼容Claude Code、Codex等多种agent,MIT协议开源。

技术 › Skill 花叔 2026-08-2414.3 KB 36.2K 261 89

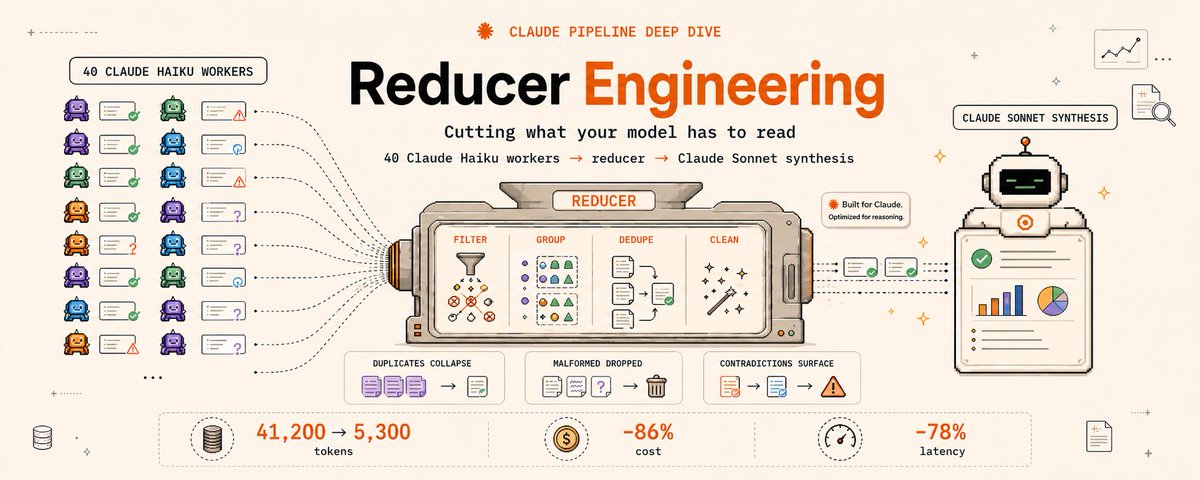
Reducer Engineering: Cutting What Your Model Has To Read (Full Guide)

本文介绍了在多智能体流水线中,通过引入确定性Reducer层来优化成本与延迟的实践。作者以40个Claude Haiku worker并行处理、Claude Sonnet汇总的架构为例,指出原始输出包含大量重复、格式错误和冗余信息,导致昂贵的合成模型浪费在数据清洗上。通过代码实现去重、过滤和分组,成本降低86%,延迟降低78%,并意外发现23处矛盾。文章强调结构化归约不仅是成本优化,更是质量保障,并提供了代码示例、防护措施和操作指南。

技术 › LLM Gipp 2026-08-119.1 KB 330.8K 323 82

如何把聊天记录变成可检索知识库(2026版)

文章探讨了如何将微信、Telegram等平台的聊天记录转化为可用的个人知识库。作者从数据获取、清洗降噪(语义分块、去重、上下文修复)到存储检索(Embedding选型、GraphRAG)提供了全流程的技术指导,并提出了数字分身、知识传承等多种应用场景。

技术 › LLM AI最严厉的父亲 2026-05-1226.8 KB 59K 158 91

为了让 AI 管家学会交易,我直接爬取了 42万字投资大佬的文章喂给它

作者尝试通过向 AI 管家“贾维斯”投喂 42 万字 Web3 投资大佬的文章,来提升其投资分析能力。文章详细记录了使用爬虫工具 XCrawl 配合 OpenClaw,快速抓取 Chris Dixon 博客并清洗成 Markdown 格式喂给 AI 的全过程。最终,AI 成功学习并输出了具有专业框架的投资策略。文中还探讨了 XCrawl 在反爬、清洗和集成方面的技术优势。

技术 › Openclaw 我真的没有拼多多 2026-04-1510.7 KB 84.3K 334 72

零代码克隆纳瓦尔数字分身保姆级教程

本文是一份详尽的零代码教程,指导如何利用 NotebookLM 和 Gemini 构建纳瓦尔的 AI 数字分身。全流程无需编程,涵盖了使用 Deep Research 寻找数据源、通过网页源码提取链接、利用 NotebookLM 搭建静态知识库(RAG),以及通过 Gemini 注入个性化灵魂并设置 System Prompt 的完整步骤。文末还提供了具体的验证测试用例及现成的资源包。

技术 › Agent 实践哥MinLi 2026-02-198.1 KB 356.7K 1K 90