Wiki 知识库

全部文档 / 标签: 爬虫

21 篇
清除

MediaCrawler:约 65K Star,七个平台公开数据一键采

文章介绍了开源爬虫项目 MediaCrawler(约 64.8K Star),该项目自 2023 年 6 月持续维护至今。其核心思路是绕开接口签名加密,基于 Playwright 浏览器自动化,在登录态下让浏览器自行计算签名,并默认使用 CDP 模式连接用户本机 Chrome,复用已有登录状态。项目支持小红书、抖音、快手、B站、微博、贴吧、知乎七个平台,可按关键词搜索、指定 ID 采集,支持评论楼中楼、作者主页监控、词云生成、多格式存储(CSV/JSON/SQLite/MySQL 等)及 WebUI。作者提醒注意账号风控、开源版功能边界、非商用协议及平台改版风险,认为该工具适合做选题素材采集和学习浏览器自动化,但强调只采公开数据、合规使用。

技术 › 工具与效率 北衡 2026-10-185.3 KB 1.2K 18 82

Agent Reach:89K Star,给 AI 装上读遍全网的眼睛

文章介绍了开源项目 Agent Reach(约8.9万Star),它为 AI Agent 提供读取全网信息的能力。项目不重复造工具,而是负责为16个平台(含B站、小红书、V2EX、雪球等国内平台)做工具选型、安装、健康体检和路由,每个平台配备首选加备选方案,接口被封时自动切换。安装只需一句话交给 AI 完成,使用时用自然语言即可让 AI 搜索、读取各平台内容并总结。作者提示 Cookie 登录平台存在封号风险,建议使用小号。文章强调其核心价值在于'先把会坏想到前面'的工程设计思路,让 AI 站在真实信息上回答问题。

技术 › Agent 北 北衡 2026-10-176.8 KB 862 9 81

数据接口生意:一个可抓取全球社媒数据的暴利API平台

作者分享了一个通过API接口出售全球数据的平台,称其为除AI中转站外最暴利的生意。该平台提供数千个数据接口,可抓取TikTok、亚马逊、Reddit、抖音、领英等全球社媒和电商数据。作者实测了三个场景:跨境电商选品(抓取商品记录和评论)、AI产品MVP需求验证(分析市场缺口)、获取客户联系方式(找到97个MCN创始人并邮件触达,12人回复)。作者认为该产品潜力巨大,并分享了视频教程。评论区有网友质疑这是广告,作者予以否认。

开源小红书相关搜索词爬虫Skill

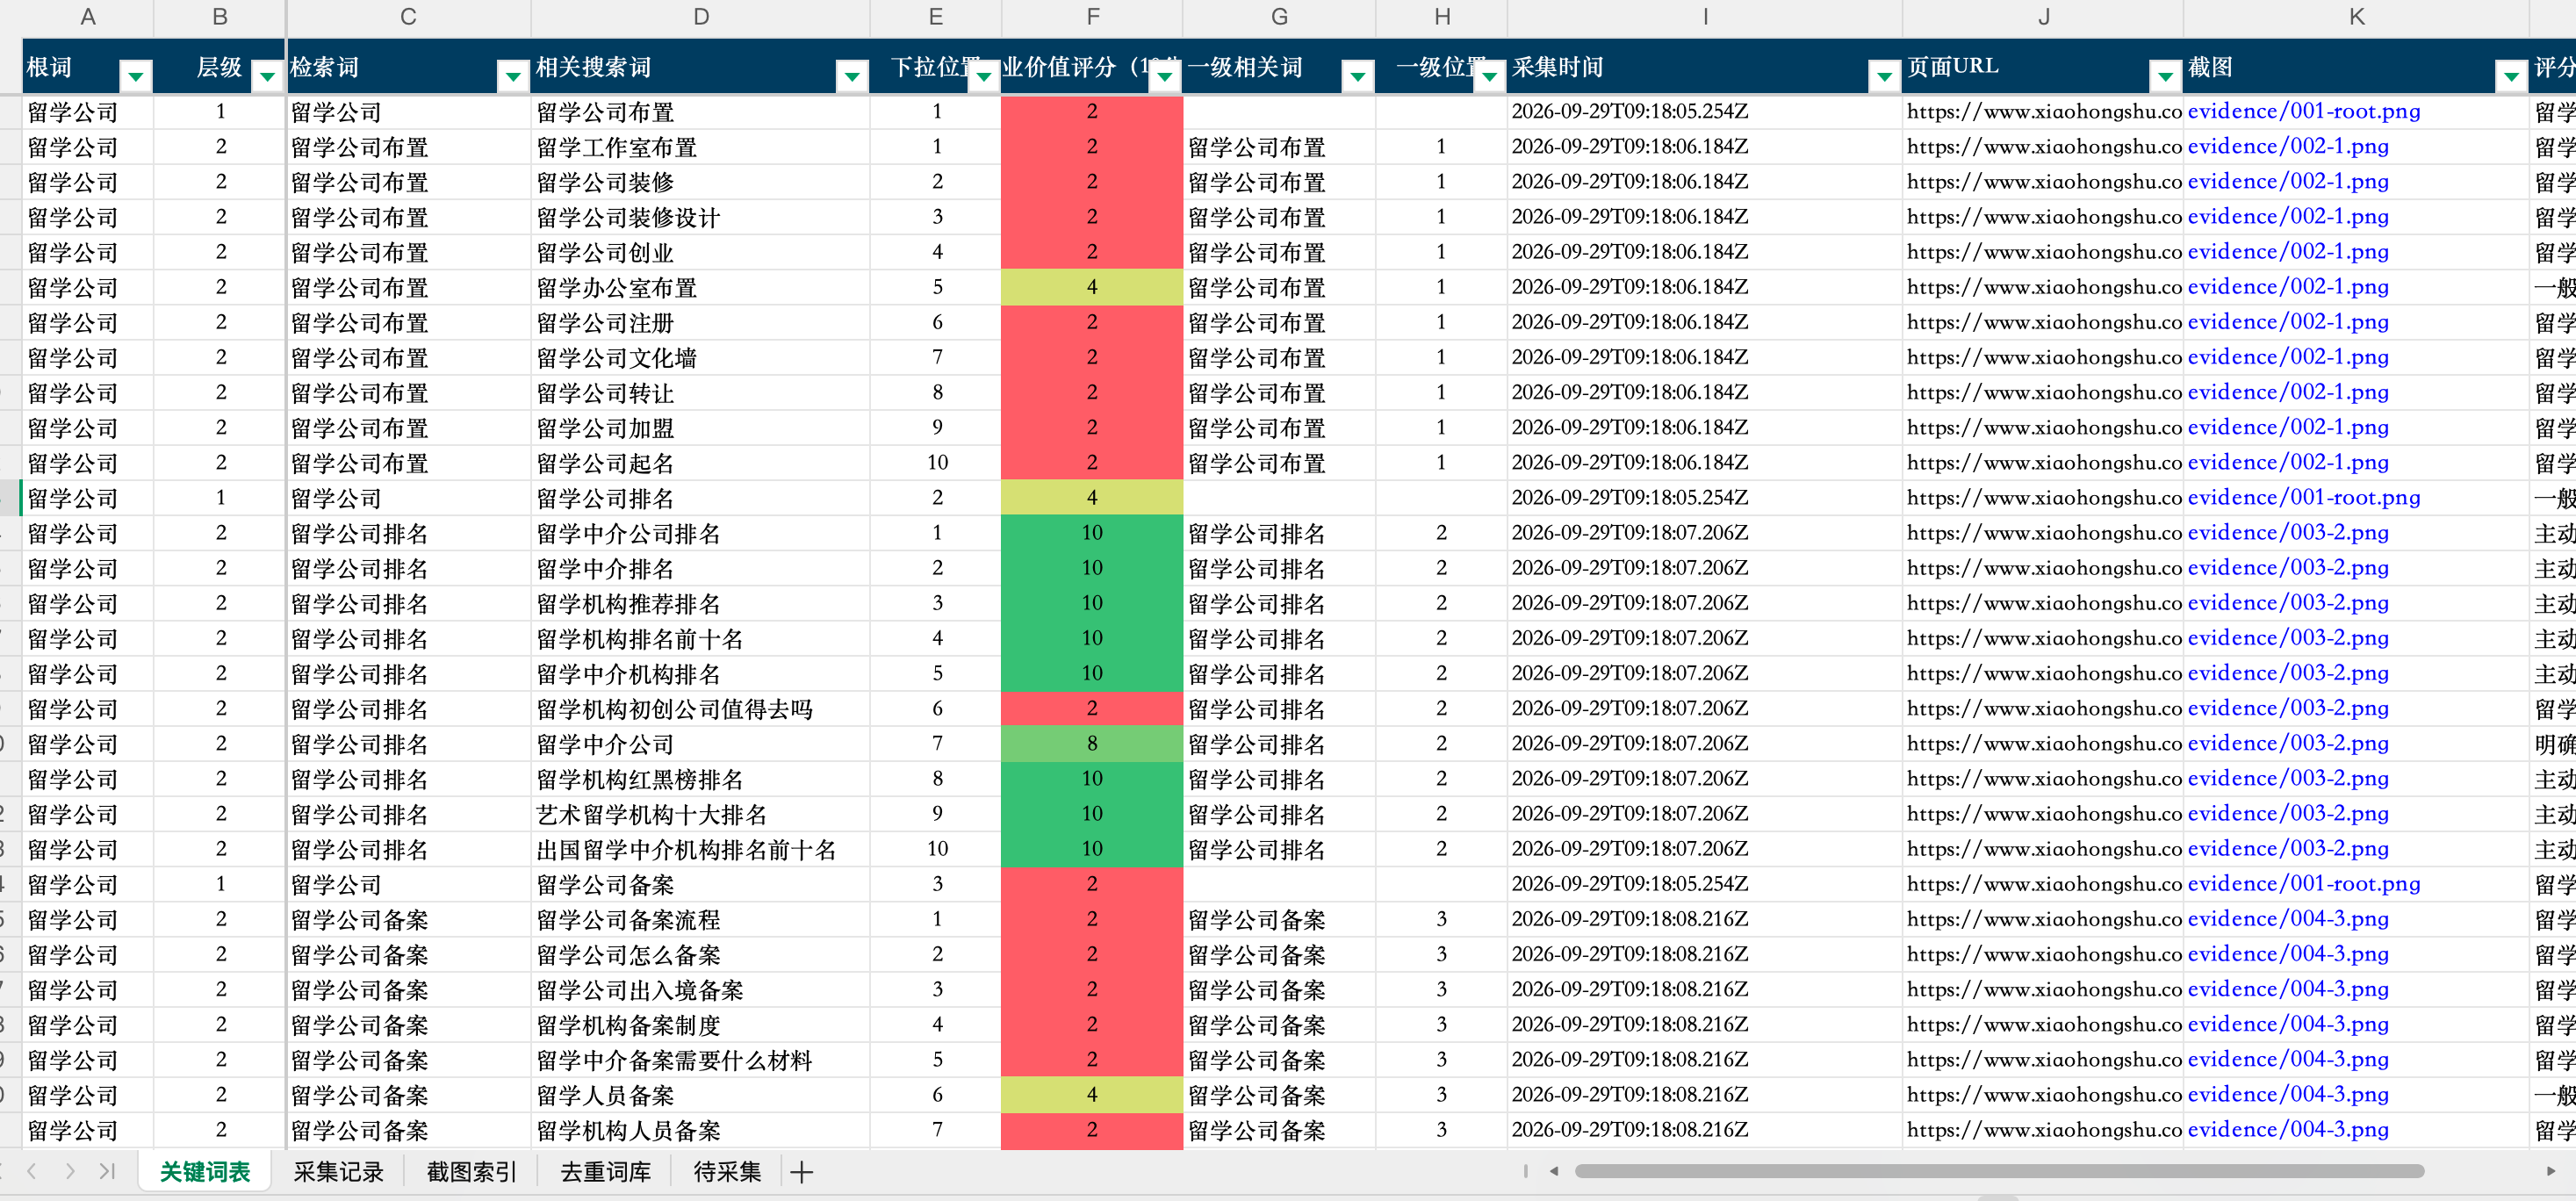
作者开源了一个用于采集小红书相关搜索词的Skill,部署到Codex后,输入一个或多个词根,AI自动抓取搜索框下拉词,并逐层扩展得到二级相关词。每条词保留截图、展示位置和来源路径,去重后按行业评分商业价值(1到10分),最终汇总为Excel文件。用「留学公司」测试获得110条路径、93个去重词。作者还回应了账号风险问题:该Skill不刷页面、无点击动作,抓取数千词量未触发风控。

技术 › Skill 姚金刚 (@yaojingang) 2026-10-011.8 KB 69

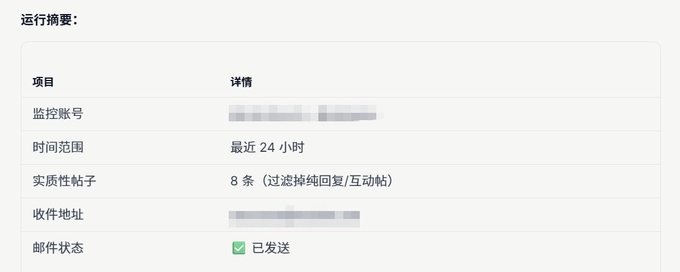
别再手刷AI热点了:我把多个来源做成了一个自动情报系统

作者分享了从想法到上线不足一天完成的 AI 热点情报系统 AIDayHot 的实践过程。系统核心流程为:多来源采集 → 领域筛选 → 72小时时效过滤 → 链接指纹去重 → 看板展示 → 定时邮件推送。文章重点讲解了几个关键决策:第一版不做用户系统,只做公开看板和管理后台;数据源优先使用官方 API 或 RSS,避免硬爬;通过链接指纹实现去重保证数据质量;定时调度独立于 Vercel 部署,避免套餐限制并解耦系统。作者强调信息过剩时代稀缺的是可靠筛选,产品第一版应保证核心闭环稳定而非功能堆砌。

技术 › 工具与效率 云析 2026-09-197.8 KB 1.7K 12 73

用谷歌搜索构建百万美元级B2B销售线索名单

作者介绍如何利用谷歌搜索运算符(site:、引号、OR、减号、intitle:等)免费挖掘LinkedIn公开资料、公司官网和招聘板,构建B2B销售线索名单,突破Sales Navigator的结果上限。核心策略是从信号而非头衔出发,如招聘信息意味着预算与痛点并存。规模化方法包括跨城市/行业批量运行搜索词、爬取结果、设置谷歌提醒。最后通过清洗、数据补全、ICP筛选、邮箱验证和去重,将搜索结果转化为可用名单,并追踪哪些搜索词真正带来会议而非线索数量。

职场 › 销售 Din 2026-08-225.7 KB 20.1K 50 73

30个开源仓库,助力AI业务自动化

本文介绍了30个开源仓库,用于构建自动化AI业务的各个层面,包括市场研究、潜在客户生成、内容创作、销售、支持、自动化、分析和安全。作者强调,没有单一工具能完全自动化业务,而是需要组合多个工具形成系统。文章按功能分类列出每个仓库的GitHub星标、用途和典型应用场景,并提醒读者开源不等于免费,且需注意合规性。

技术 › 工具与效率 Rexei 2026-08-2012.9 KB 111.7K 129 81

10个强大的开源GitHub网络爬虫仓库推荐

本文分享了10个极其强大的GitHub开源爬虫与数据采集项目,如Firecrawl、Crawl4ai、Browser-use和Scrapy等。这些工具涵盖了自动化渲染、网页转Markdown、AI智能体操控浏览器、隐形反反爬及移动端数据抓取等功能。借助这些免费开源的工业级框架,开发者能够高效、低门槛地获取互联网各处的结构化数据,实现媲美昂贵商业付费API的采集效果。

Crawl4AI:7万星开源神器把网页秒变LLM能吃的干净Markdown

文章介绍了一款名为 Crawl4AI 的开源爬虫工具,GitHub 星标超 7 万。该工具专为 RAG 和 Agent 设计,能将网页快速转换为干净的结构化 Markdown 数据。其特点包括零 API Key、异步浏览器池、智能去噪、支持 CLI/Docker 部署以及强大的反爬策略,被视为构建 LLM 数据管道的利器。

技术 › LLM 开发者Hailey 2026-07-101.9 KB

价值1万刀的稳定小红书“API”工具拆解:Airtap Agent实战评测

文章介绍并评测了一款名为 Airtap 的云端 AI Agent 工具,该工具通过操控真实安卓手机 App 来解决小红书缺乏官方 API 的问题。文章详细拆解了其架构模型、Task 执行流程(包括搜索、点击、截图及节点树提取)、稳定性实测结果以及 SDK 使用边界。结论表明,虽然数据层受推荐算法影响,但在接口契约和结构层上,它为开发者提供了一个高可用的“类 API”解决方案。

技术 › Agent WquGuru 2026-05-1511.0 KB 137.9K 820 87

使用 Hermes Agent 自动化制作 TikTok 幻灯片内容指南

本文介绍如何利用 Hermes Agent 自动化 TikTok 幻灯片(Slideshow)内容的生成与发布流程。文章分析了幻灯片流量红利与手动制作痛点,详细讲解了 Hermes 的安装配置、基于 Skill 和 Cron 的管道模型设计,以及 Hook 研究、图片路由、Pinterest 爬取和合成等核心技能的实现方法。

技术 › Hermes Alex Nguyen 2026-05-1442.3 KB 291.6K 790 89

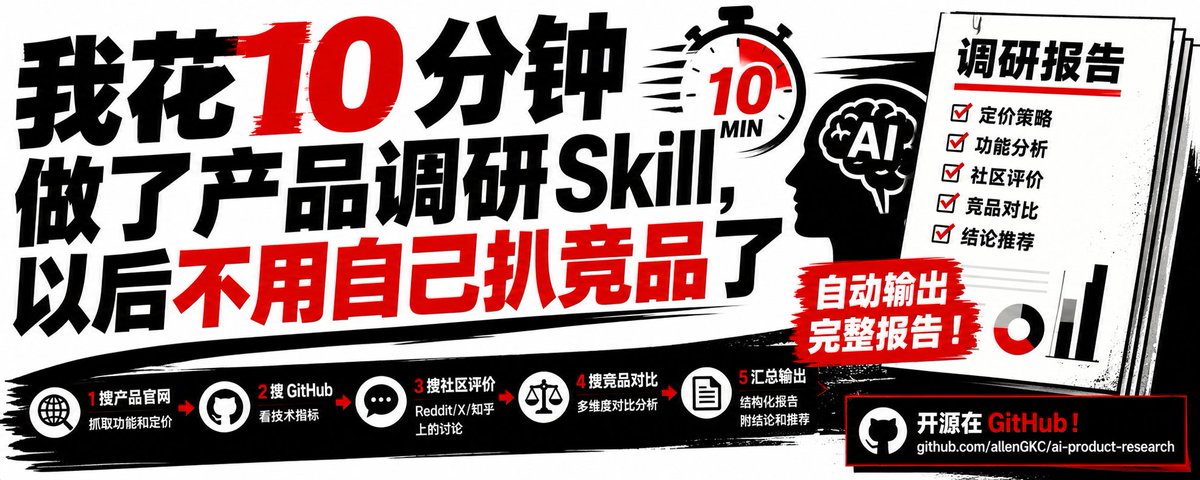
我花10分钟做了产品调研Skill,以后不用自己扒竞品了

针对运营同事使用通用AI生成竞品报告出现数据失真的问题,作者开发了一款名为 'ai-product-research' 的自动化调研 Skill。该工具利用 XCrawl 的 Search 和 Scrape API,模拟人类“先搜再抓”的逻辑,自动获取产品官网、GitHub 数据及社区评价,并在 2 分钟内输出包含定价、技术指标和竞品对比的结构化报告。文章实测了 Cursor 和 AIHOT,效果精准且成本极低。

技术 › Agent 木马人 2026-05-126.7 KB 14.6K 90 81

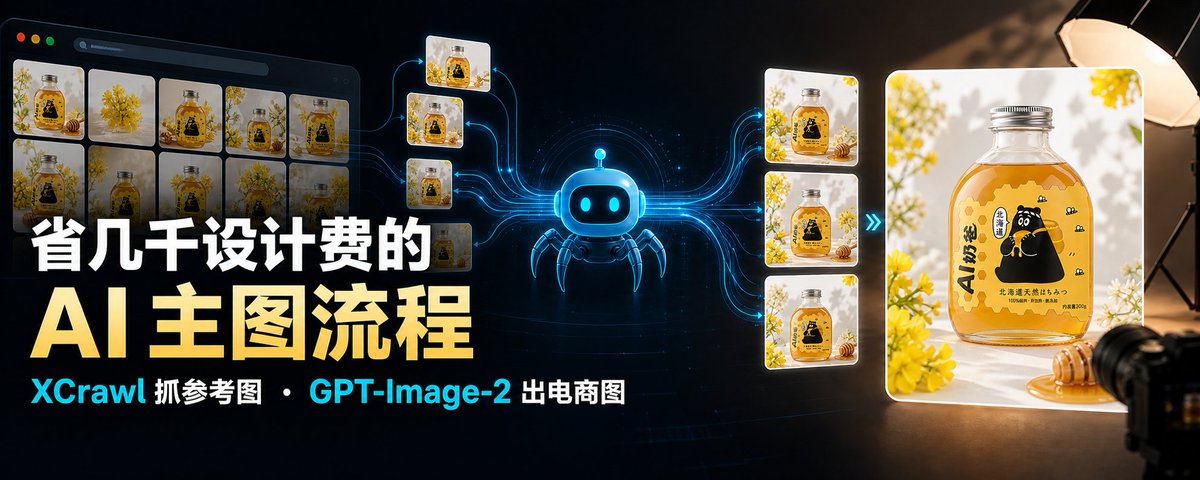
朋友想省几千块设计费,我用 GPT-Image-2 + XCrawl 搭了一套 AI 主图流程

文章讲述了作者如何利用 GPT-Image-2 和 XCrawl 工具构建一套自动化电商主图设计流程。通过 XCrawl 抓取 Behance 上的高质量设计参考图,并结合 Claude Code 进行数据清洗与结构化,解决了单纯依靠 Prompt 效果不佳的问题。该方法不仅能大幅降低设计探索成本,还能提升商品图的视觉溢价,展示了参考图在 AI 绘图中的决定性作用。
技术 › Agent AI奶爸 2026-05-0615.9 KB 21.5K 205 91

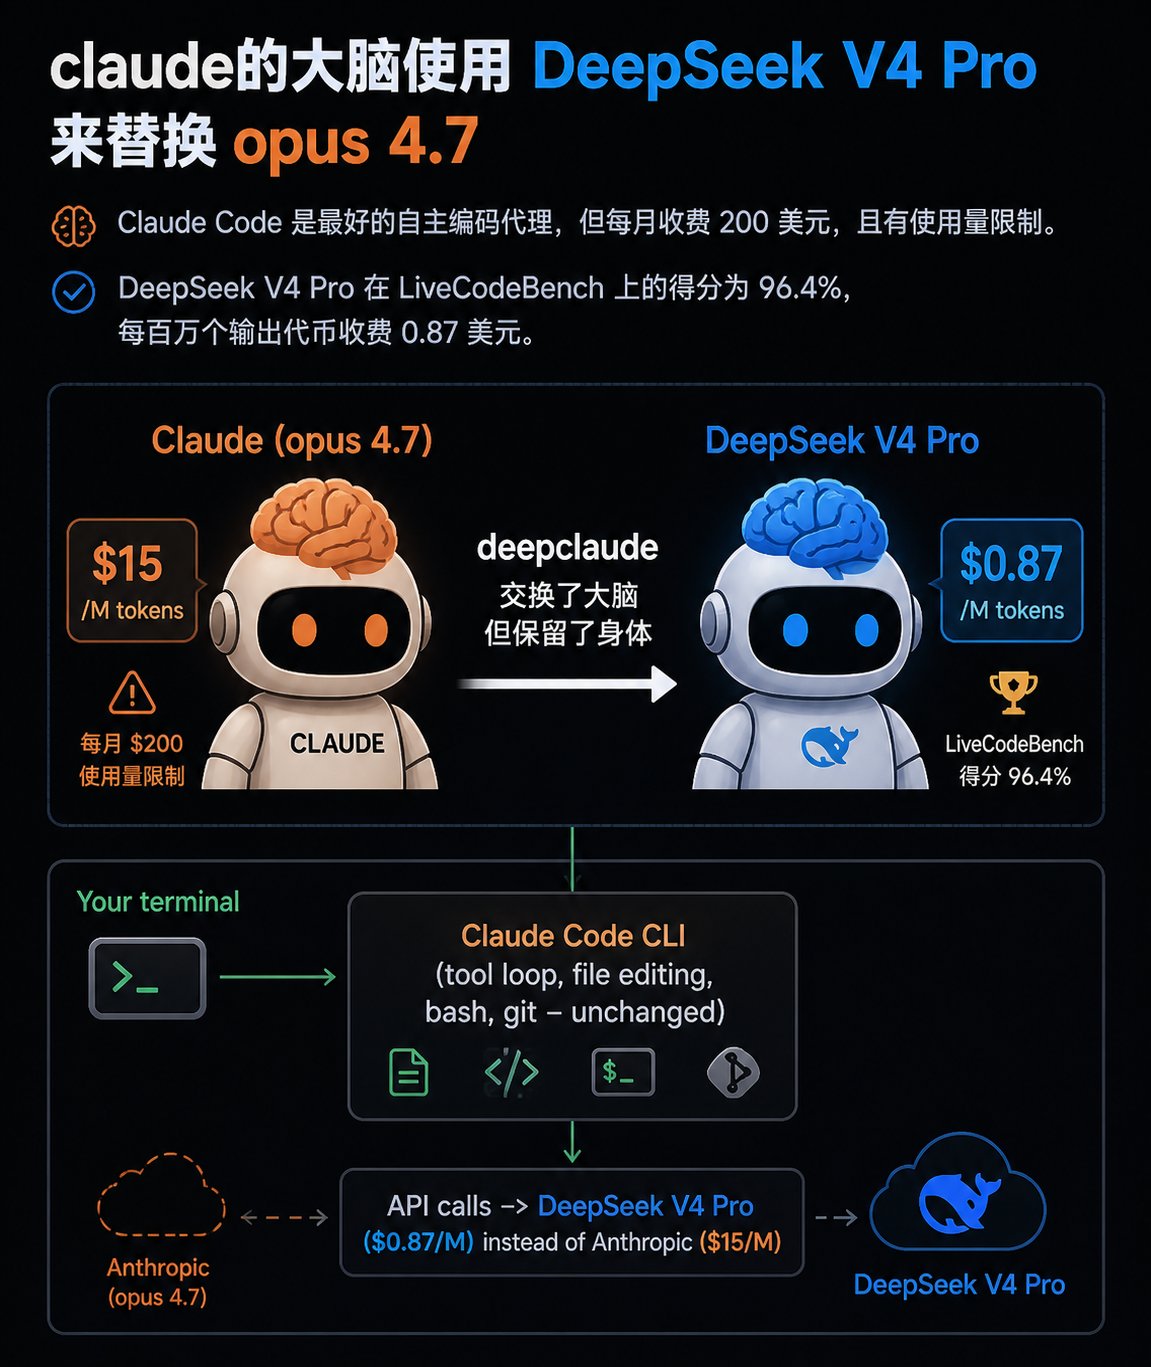
DeepSeek 替代 Claude Code 降本方案 & 18款浏览器自动化工具评测

文章首先介绍了 GitHub 项目 deepclaude,通过将 Claude Code 的内核 API 替换为 DeepSeek V4 Pro,实现了在保持性能的同时将 API 成本降低至 1/17,并支持无缝切换后端。随后,文章详细测评了目前主流的 18 款 AI Agent 浏览器和数据采集工具,按功能分为王者派、Rust 派、MCP 派等,并提供了针对不同场景(如自动化、MCP 接入、社媒爬虫)的选型建议。

技术 › 工具与效率 未 未知 2026-05-046.3 KB 80

AI 创作者的选题外挂:中英信息差工作流

本文介绍了利用 Claude Code、XCrawl 和 n8n 搭建自动化工作流的方法,旨在通过抓取英文 AI 圈的最新资讯并对比中文圈,挖掘“信息差”作为内容选题。文章详细拆解了从筛选信源(如 latent.space、Import AI 等)、配置爬虫策略到构建自动化日报系统的全过程,实现了从“手动刷屏”到“5分钟定题”的效率飞跃。

技术 › Agent 劳伦斯 2026-04-2719.7 KB 13.1K 109 84

公众号文章批量采集完全指南

文章详细介绍了5种批量采集微信公众号文章的方法,涵盖从淘宝代采、开源工具使用到API逆向工程。作者重点实战了通过逆向微信接口获取文章列表,并利用破解的API签名将内容批量转换为Markdown的技术方案,提供了完整的Python清洗脚本与防封控建议。

技术 › 工具与效率 百 百年 AI×SEO 2026-04-2610.6 KB 88

为了让 AI 管家学会交易,我直接爬取了 42万字投资大佬的文章喂给它

作者尝试通过向 AI 管家“贾维斯”投喂 42 万字 Web3 投资大佬的文章,来提升其投资分析能力。文章详细记录了使用爬虫工具 XCrawl 配合 OpenClaw,快速抓取 Chris Dixon 博客并清洗成 Markdown 格式喂给 AI 的全过程。最终,AI 成功学习并输出了具有专业框架的投资策略。文中还探讨了 XCrawl 在反爬、清洗和集成方面的技术优势。

技术 › Openclaw 我真的没有拼多多 2026-04-1510.7 KB 84.3K 334 72