Wiki 知识库

全部文档 / 作者: 花叔 / 标签: 模型评测

4 篇
清除

一夜之间!Opus5.5、GPT-6 Sol、GPT-6 Luna全来了

Anthropic发布Claude Opus 5.5,比Opus 5便宜40%、速度快30%,跑分全面超越Fable 5.1,并推出订阅用户一次性的额度reset功能。一个半小时后,OpenAI发布GPT-6 Sol和Luna,大幅降价,Luna价格杀入DeepSeek区间。作者实测对比了Opus 5.5、Opus 5和Fable 5.1在鹈鹕骑单车SVG、Blender建模宋代斗拱、机械蝴蝶等任务上的表现,发现Opus 5.5综合成本省29%-55%,agent能力强,但max档反而不如medium档。文章详细分析了各模型跑分、价格策略和Claude Code更新要点。

技术 › LLM 花叔 2026-09-2322.0 KB 41.5K 45 81

实测MiMo-V2.6:小米347万美元训出的开源模型深度评测

作者实测小米直播后训练的MiMo-V2.6模型。小米以直播方式公开后训练全过程,Flash和Pro合计花费347万美元,Pro在Artificial Analysis智能指数榜登上开源模型第一(46分)。作者通过五个真实任务测试:three.js程序化3D建模太和殿、高端旅行社官网前端审美、修复开源仓库真实bug、办公数据处理与核对、以及对发布仅七天的Jev模型做长程研究与幻觉控制。结果显示模型在agentic编程、审美、错误处理和事实核查上表现出色,且缓存命中率达95.7%、成本低廉,作者认为智能正走向普惠,计划将常用开源API迁移到MiMo-V2.6。

技术 › LLM 花叔 2026-09-2211.3 KB 14.5K 9 78

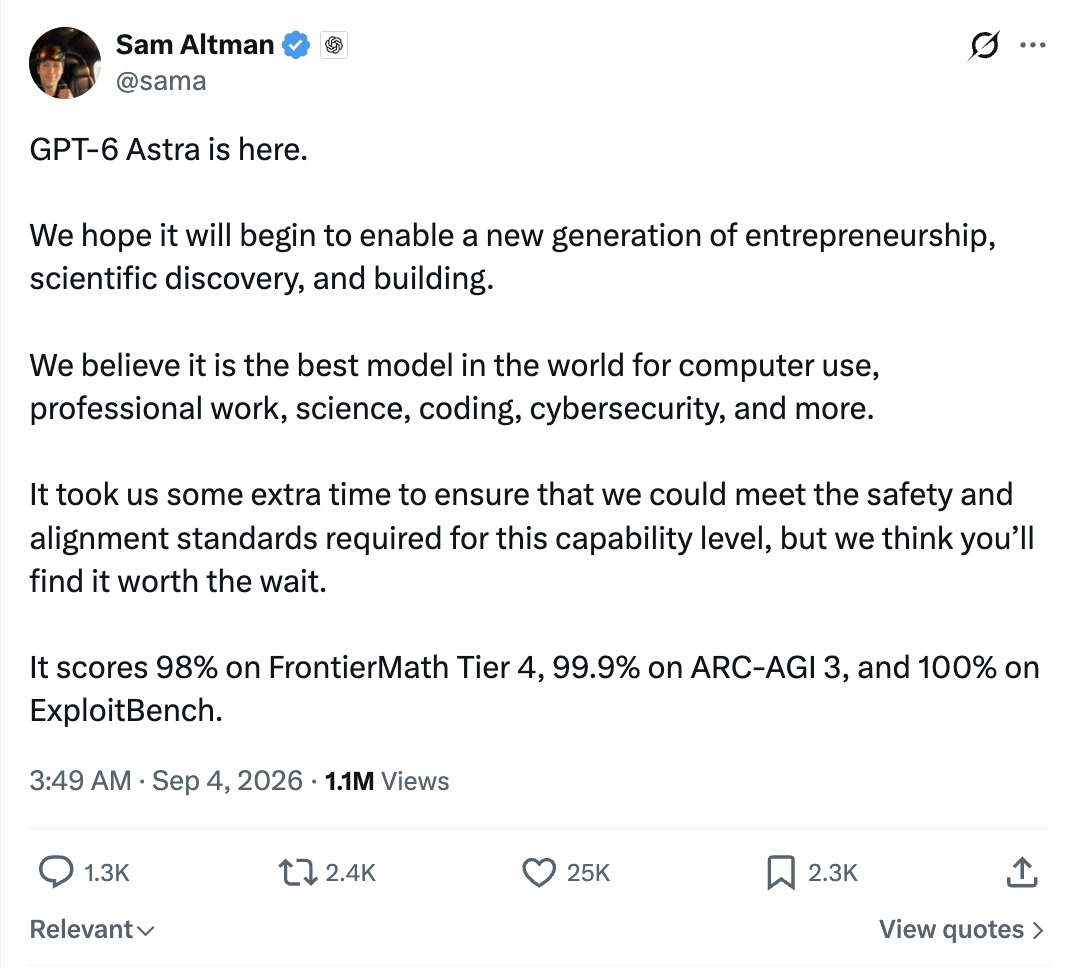
GPT-6发布,OpenAI说AGI时代来了

OpenAI于2026年9月4日发布GPT-6 Astra,与Anthropic的Claude Fable 5.1正面竞争。Astra在数学(FrontierMath 97.6%)、ARC-AGI-3(99.9%)、电脑操控(OSWorld 2.0)等评测上大幅领先,编程类任务则与Claude咬得较紧未全面胜出。文章分析了各项benchmark数据、定价(与Fable 5.1相同)、Codex跨上下文记笔记等新功能,指出Astra是首个触发Critical网络安全阈值的模型,因此漏洞利用能力被限制。作者认为AGI时代特征初显,电脑操控能力将碾压此前人机协作的苦力活。

技术 › OpenAI 花叔 2026-09-0415.2 KB 16.6K 15 80

WorkBuddy首发Hy4 preview实测:对手是Kimi K3和GLM-5.3

作者实测腾讯混元Hy4 preview模型,该模型在WorkBuddy中首发并限时免费。Arena代码榜1633分,与Grok-4.6、Claude等旗舰模型处于同一区间。作者通过Three.js体素游戏、HTML PPT制作、信息真实性核实及脏数据表分析等多维度实测,对比Kimi K3、GLM-5.3和上一代Hy3。结果显示Hy4 preview不仅规格完成度高,更在数据陷阱识别上以7/7胜出,能主动指出问题本身不成立、标注已知缺陷,展现出「敢质疑数据」的审计能力,作者认为腾讯的模型能力已真正赶上头部水平。

技术 › LLM 花叔 2026-08-2814.7 KB 13.7K 30 87