Wiki 知识库

全部文档 / 作者: Avi Chawla / 标签: Agent

5 篇
清除

The 2026 LLM Engineering Roadmap

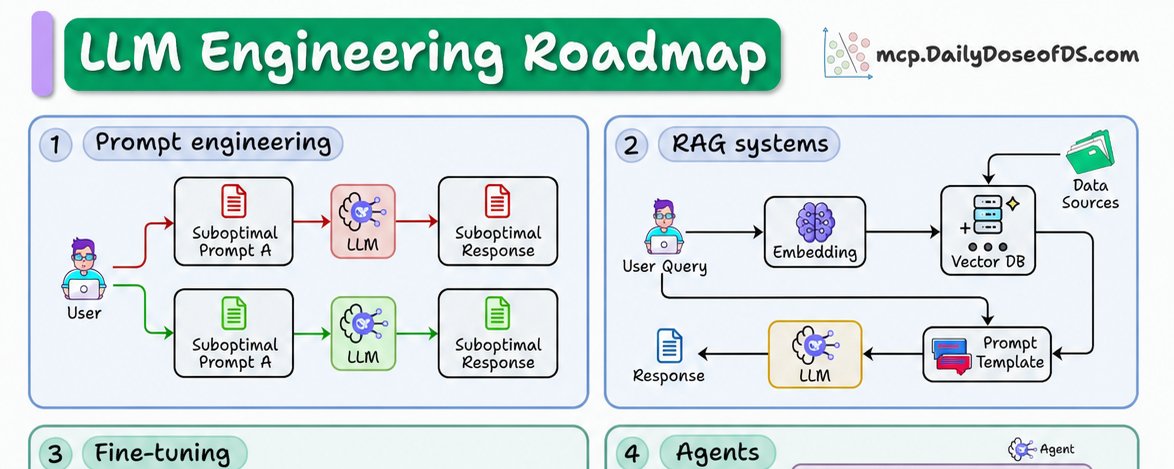
本文提出了2026年LLM工程路线图,指出与LLM工作不只是提示词,生产级系统需要对LLM的工程化、部署和优化有深入理解。文章总结八大支柱:提示工程(将prompt当作代码管理)、RAG系统(嵌入、检索、重排)、上下文工程(管理上下文窗口中各类信息的取舍)、微调(LoRA/QLoRA等技术)、Agent(工具调用循环与编排、状态管理、重试逻辑),并为每个领域提供了大量免费开源学习资源,如Anthropic、OpenAI官方指南及多个GitHub教程仓库。

技术 › LLM Avi Chawla 2026-10-0919.8 KB 403.3K 447 71

Your Agent Harness Should Repair Itself

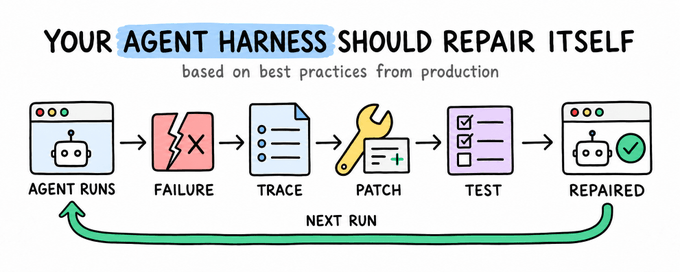
文章探讨 Agent 系统如何在不更新模型权重的情况下自我改进。作者阐述了两条反馈路径:成功运行产生可复用的程序性记忆(以 Hermes 的 SKILL.md 文件和 GEPA 离线优化为代表),失败运行则通过 Opik 的执行 trace 进行诊断,定位故障源头(模型、工具、配置或代码),提出修复方案,经人工审核后重跑并添加回归测试。文章强调失败必须被记录为可验证的预期行为和测试用例,才能转化为可复用的知识,并详细介绍了 trace 结构、失败检测与根因分析的工作流程。

技术 › Agent Avi Chawla 2026-09-1218.9 KB 53K 415 81

Grok Bot 大师课:理解、搭建与实际运用指南

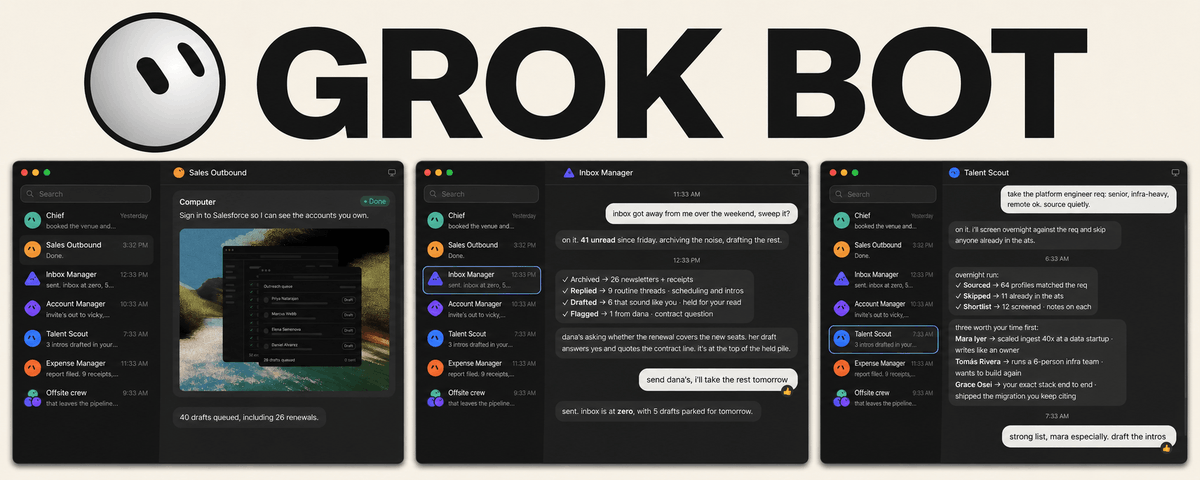
SpaceXAI 推出的 Grok Bot 采用“一人一机”模式:每个账户共享一台持久化云端计算机,所有 Bot(命名角色代理)共享浏览器、文件系统和终端凭证。文章解析了 Grok Bot 的架构——持久云端计算机、共享模型、连接器与浏览器操作层、takeover 认证流程,并与 Devin、Manus、ChatGPT Work 等托管代理的记忆与持久化方案进行对比,最后指导如何在 macOS 上搭建 Bot 名册并构建可后台运行的例行任务。

技术 › Agent Avi Chawla 2026-08-1821.6 KB 1M 1.1K 74

LLM 中的 Prompt Caching 技术详解:以 Claude 为例的高效缓存策略

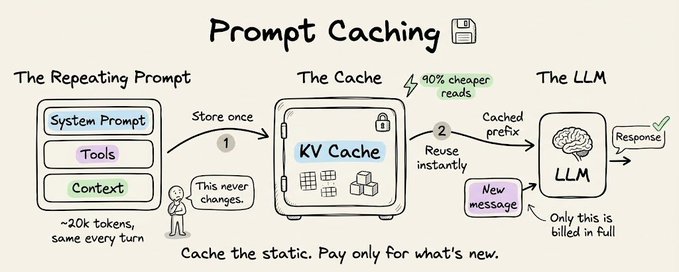
本文深入探讨了 LLM 中的 Prompt Caching 技术,解释了其背后的 KV Cache 机制及静态/动态上下文分离原理。文章通过 Claude Code 的案例分析,展示了如何通过保持 92% 的缓存命中率来将计算成本降低 81%,并总结了哈希敏感性和工程化落地的关键约束。

技术 › LLM Avi Chawla 2026-04-2021.1 KB 755.1K 1K 87

LLM 提示词缓存原理与实战应用

文章深入探讨了LLM中的提示词缓存技术。通过区分静态前缀(如系统指令)和动态后缀(如用户消息),利用KV Cache机制避免重复计算,大幅降低长上下文任务的成本。文章以Claude Code为例,展示了如何通过保持92%的缓存命中率将成本降低81%。同时,强调了Hash缓存的脆弱性,任何微小的前缀变动都会导致缓存失效,并给出了在开发Agent时维持缓存热度的具体工程建议。

技术 › LLM Avi Chawla 2026-04-1620.9 KB 87