预训练之后,为什么还要后训练?
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。
本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。
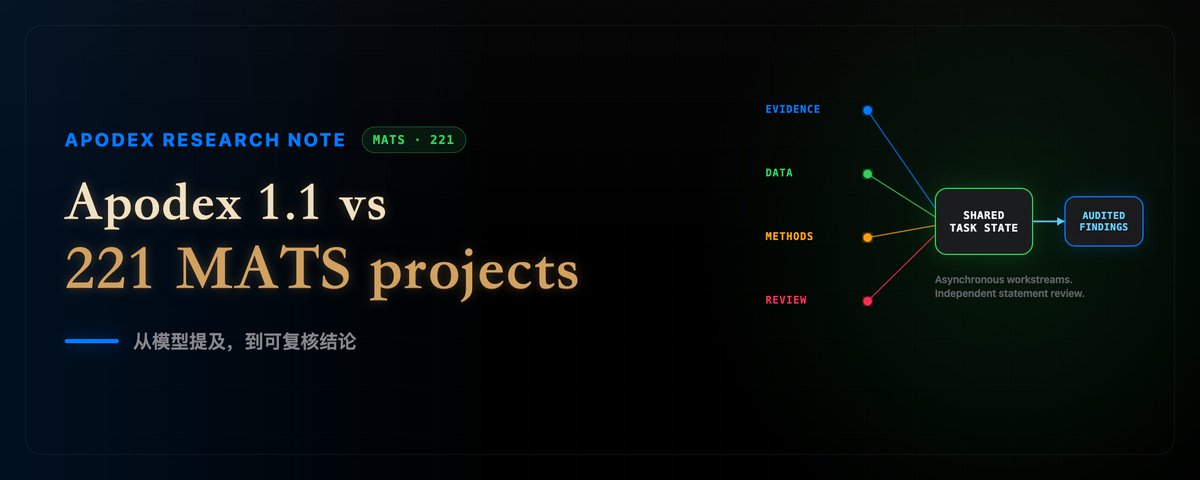
作者使用 Apodex 1.1(主模型+在线工作台的科研 Agent 产品)对 221 个 MATS 项目进行研究,分析中国模型尤其是开放权重模型在 AI 安全研究中的使用情况。系统区分原始提及与实质性采用,通过异步 Agent Team(10 个 Subagent 并行)处理 4,821 条证据摘录,支持运行中 Chime-in 调整任务范围,并用独立审查 Agent 核验结论。研究发现中国模型实质性采用率从 2023 年的 4.35% 升至 2025 年的 50.55%,80.9% 的使用在开放权重条件下发生,中国开放权重模型正成为安全研究的实验基础设施。
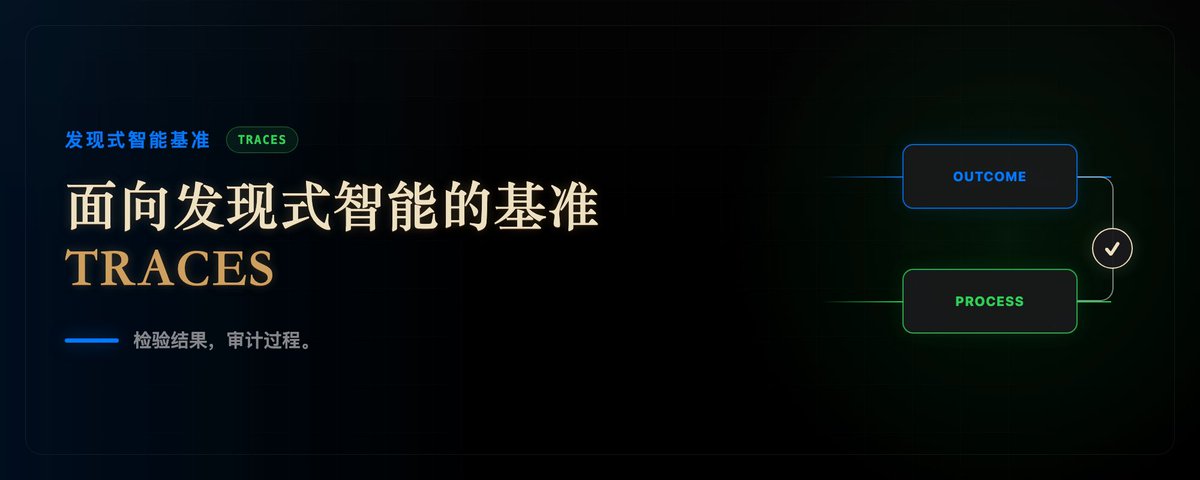
本文介绍 Apodex Discovery 提出的 TRACES 基准,用于评估 AI 系统能否通过证据充分、可审计、可修复的调查得到正确结果。与传统基准只衡量最终答案不同,TRACES 将评估单位扩展为完整调查过程,通过结果验证器与盲评的过程验证器(HDS6:工具、修复、备选解释、连贯性、证据、适用边界)双通道评价。基准提供 AAV 衣壳设计、药物再利用、临床试验、大模型工程四个可执行环境,实验显示过程诊断反馈可使结果得分平均提升 0.155。文章还比较了 TRACES 与 MMLU、SWE-bench 等基准的差异。