Wiki 知识库

全部文档 / 作者: yibie / 标签: 微调

4 篇
清除

Jeff:把 Jev 类决策模型压到 0.8B,跑在本地

Mathias Strasser(Scissero)基于 Qwen3.5 和 Gemma 4 微调出 Jeff 系列 0.8B/2B 决策模型,用于零样本分类:输入描述与选项,一次前向传播返回各选项校准概率。模型在 RTX PRO 6000 上约 22 毫秒、M4 Max 上 28 毫秒即可完成一次决策,0.8B 仅 1.7GB,可直接本地部署。整体基准分 Jeff-2B 达 83.1,几乎追平 Jev 的 83.0;Doom 零样本测试中 Jeff-0.8B 在无人提示规则下达到 6.55,追平 Jev 公布成绩。作者诚实列出局限:不能推理、最多 26 个选项、只支持英文文本等。代码 MIT、权重 Apache 2.0 开源。

技术 › LLM yibie 2026-09-3011.8 KB 8.5K 98 86

有人把 Jev 开源复刻了,还给出了「自己微调」的完整闭环

Jared Palmer(Cognition)开源了 Kev,一族建在 Qwen3.5/3.8 之上的 Jev 式小型决策模型(0.8B~27B,Apache-2.0)。文章介绍了 Kev 与 Jev 的对比数据:Kev-27B 在新数据源上与 Jev 相差一个点以内,但作者强调这不是受控比较。最有价值的部分是完整的微调闭环:通过 coding agent 的 skill,可自动从用户代码中找出问题、转换已有标签、在 Modal 上微调并部署,一次 Kev-4B 训练在 H100 上约 1 美元,示例中把准确率从 67.7% 提到 73.6%。文章还总结了校准温度、问题隔离设计等工程细节,以及作者诚实的自我限制态度。

技术 › LLM yibie 2026-09-289.8 KB 7.4K 78 88

如何用自己的数据微调一个小模型

本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。

技术 › LLM yibie 2026-09-2010.3 KB 213.6K 1.1K 86

训练小模型:2026 年最被低估的 AI 技能

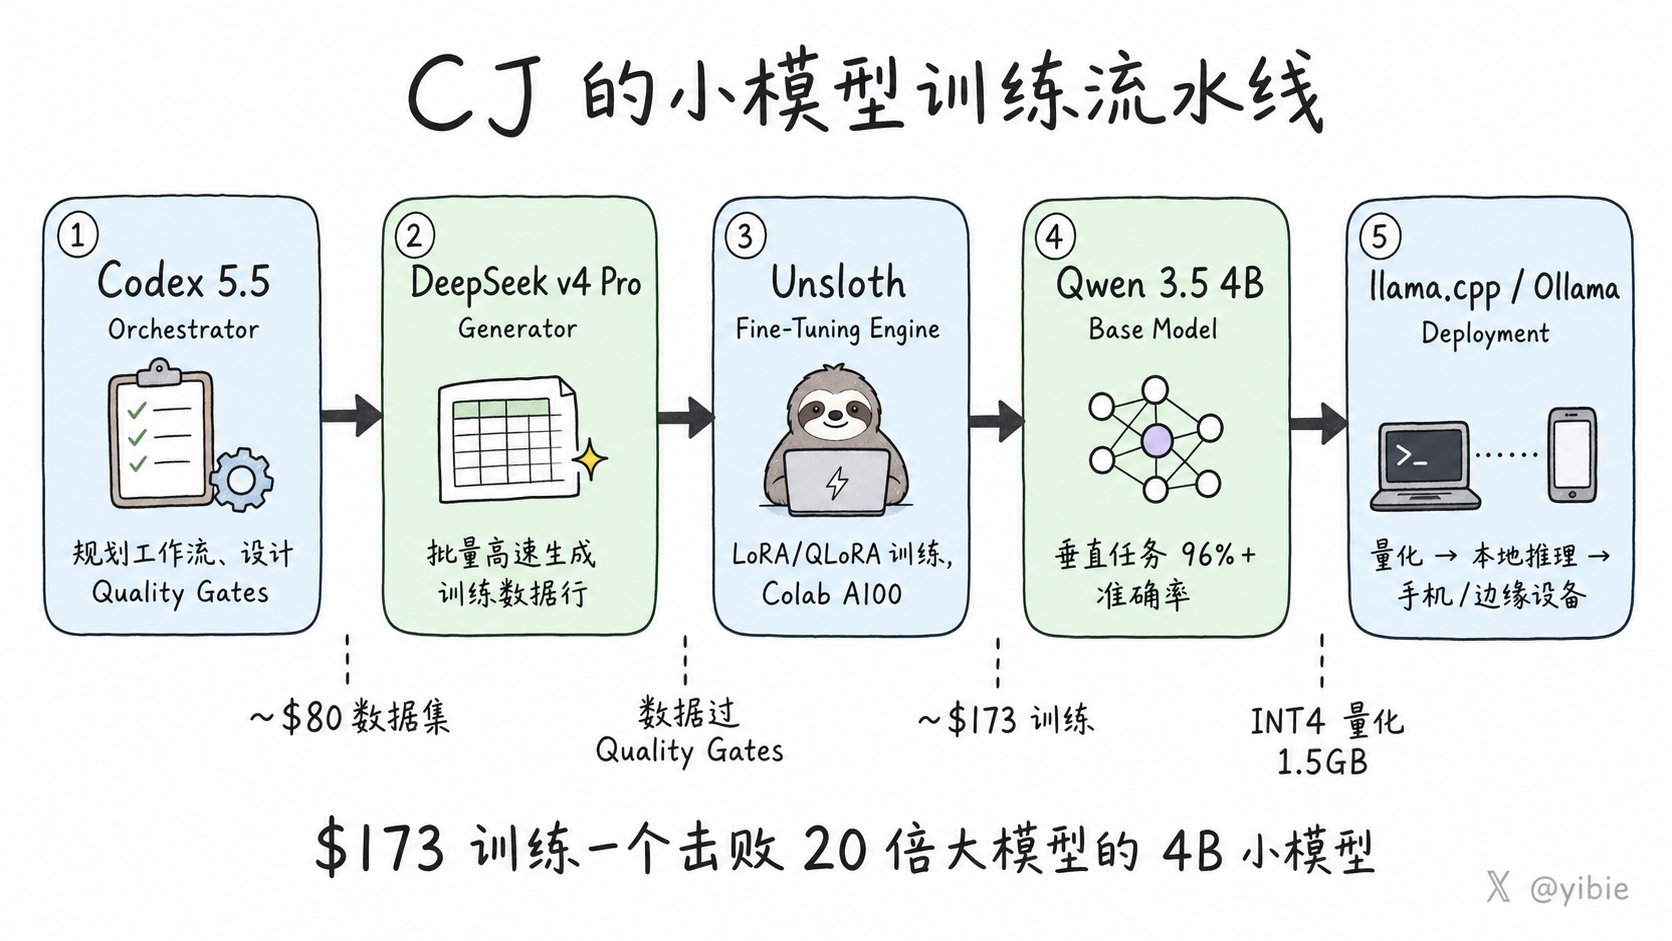
本文探讨了 2026 年 AI 领域的边缘趋势:个人开发者训练小模型(SLM)。文章详细介绍了 CJ Zafir 的方法论,即利用 Codex 和 DeepSeek 生成数据、Unsloth 进行训练、Qwen 作为基座,以极低成本(最低 11 美元)在垂直任务上超越大模型。文章指出,真正的护城河在于高质量数据集的生成工厂,而随着硬件门槛降低和工具成熟,模型微调正从企业军备竞赛转向个人技能。

技术 › LLM yibie 2026-06-028.1 KB 88