Wiki 知识库

全部文档 / 标签: 本地AI

10 篇
清除

Google 的本地笔记:你出题,它检索

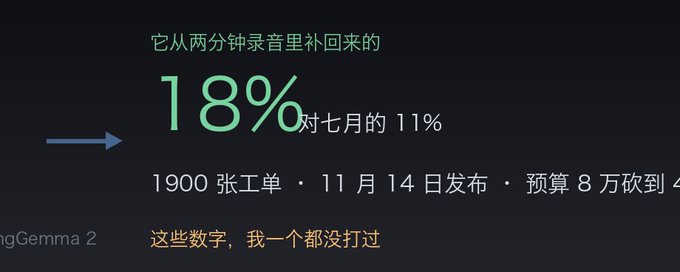
文章评测了 Google DeepMind 随 EmbeddingGemma 2 发布的 Mac 应用 Google AI Edge Foresight。该应用在会议中监听系统音频,用户手写简短笔记后,它基于本地嵌入检索实时补齐细节,全程离线运行。作者通过实测验证它能准确捕捉音频中的具体数字,且不覆盖用户原文,遵循 Jef Raskin '不剥夺用户决策权'的界面理念。文章同时指出其不足:Live Enhance 开关状态不可见、转写无法区分远端说话人身份。技术层面分析了 EmbeddingGemma 2 在短查询检索长文档上的优势(93.7% 命中率),说明'用户出题、模型检索'正是其强项所在。

技术 › LLM yibie 2026-10-117.5 KB 831 2 83

16.9 MB 的语音识别,和它不认识的语言

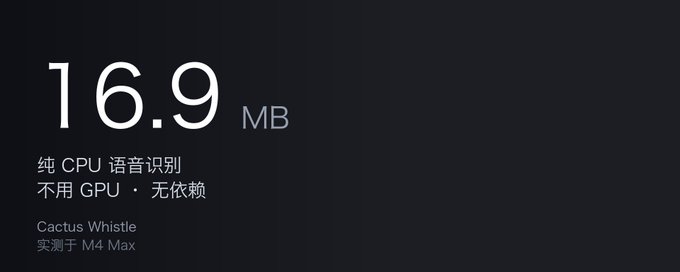
Cactus Compute 发布了 16.9 MB 的本地语音识别模型 Whistle,纯 CPU 运行、无依赖,与同公司的 Needle 模型共享引擎。作者实测发现:七种欧洲语言(英德法西意荷波)识别准确度高,首 token 仅 5-8 毫秒,解码速度约 1300 token/秒,官方性能数据基本可信。但关键缺陷在于:遇到不支持的语言(如中文、日文)时,模型不会报错也不会返回空,而是硬套进已知语种生成'假词',造成静默污染。文章指出该模型设计目标是端上语音自动化入口而非单纯转写,并提醒中文用户慎用。

技术 › TTS yibie 2026-10-116.2 KB 4.4K 36 83

读 2.83% 的 key 就够了

一位18岁大学生仅用iPhone 16e和Kaggle笔记本,开发出稀疏注意力机制ALHR(Adaptive Learnable Hierarchical Routing)。该方法通过给key矩阵构建静态二叉树,配合预算预测器、邻居搜索和树下降三步推理,让每个query只读取所需key。在1024 token的MQAR测试中,仅读取2.83%的key即可达到92.1%准确率(稠密基线94.9%),KV压缩35.3倍。训练分三段:先训稠密教师模型,再用其注意力矩阵标注top-k key训练树模块,最后无教师联合训练。目前因未做kernel优化比稠密注意力慢约10倍,代码由Claude Sonnet 5.5生成,Apache-2.0开源。

技术 › LLM yibie 2026-10-105.0 KB 1.3K 2 76

Jeff:把 Jev 类决策模型压到 0.8B,跑在本地

Mathias Strasser(Scissero)基于 Qwen3.5 和 Gemma 4 微调出 Jeff 系列 0.8B/2B 决策模型,用于零样本分类:输入描述与选项,一次前向传播返回各选项校准概率。模型在 RTX PRO 6000 上约 22 毫秒、M4 Max 上 28 毫秒即可完成一次决策,0.8B 仅 1.7GB,可直接本地部署。整体基准分 Jeff-2B 达 83.1,几乎追平 Jev 的 83.0;Doom 零样本测试中 Jeff-0.8B 在无人提示规则下达到 6.55,追平 Jev 公布成绩。作者诚实列出局限:不能推理、最多 26 个选项、只支持英文文本等。代码 MIT、权重 Apache 2.0 开源。

技术 › LLM yibie 2026-09-3011.8 KB 8.5K 98 86

告别混乱收藏夹!我用 Markdown + 本地 AI 搭建数字大脑

作者分享了自己搭建 AI 个人知识库的完整经验。文章指出收藏资料不等于拥有知识,知识库应帮助找回信息、形成判断并推动行动。作者以 Markdown、JSON 和原始文件为事实源,搭建了包含 raw、notes、wiki、briefs、logs 五层结构的系统,覆盖内容入库、索引检索、AI 引用问答、周报复盘等流程。文章还总结了搭建中的关键原则:原文、AI 总结与个人判断分开,回答必须带引用,先用简单检索验证需求,注意隐私与数据边界,并通过 14 天真实使用验证价值,最终实现从收集到判断的行动循环。

技术 › 工具与效率 浅水虾 2026-09-029.2 KB 2.6K 2 77

五大“未来科技”的商业化现状分析

本文探讨了五项被称为“未来”的技术及其商业化现状。其中,人形机器人已获千万订单;本地AI硬件以极低成本取代昂贵的云订阅;无屏AI Agent基础设施已成熟;高斯溅射(3D扫描)技术正为自由职业者带来丰厚收入;而脑机接口距离大众消费仍需数年。作者指出,技术的真正机会不在于盲目发明,而在于敏锐察觉哪些技术已跨过失败期、步入变现阶段,从而抢占先机。

技术 › Agent Future Memo 2026-08-064.7 KB 73

LLM 推理引擎与本地硬件指南 (2026 版)

文章阐述了选择 LLM 推理引擎的正确逻辑:先确定硬件策略、负载形态和服务模式,再选引擎。文章解析了推理引擎的核心功能(调度、内存管理、批处理)及性能瓶颈(显存带宽、KV Cache、互联),并详细对比了 llama.cpp、MLX、ExLlama、vLLM、TensorRT-LLM 等主流引擎的适用场景与优缺点。

技术 › LLM Ahmad 2026-05-2141.6 KB 1.3M 2K 91

Hugging Face 百大热门 AI 硬件配置分析

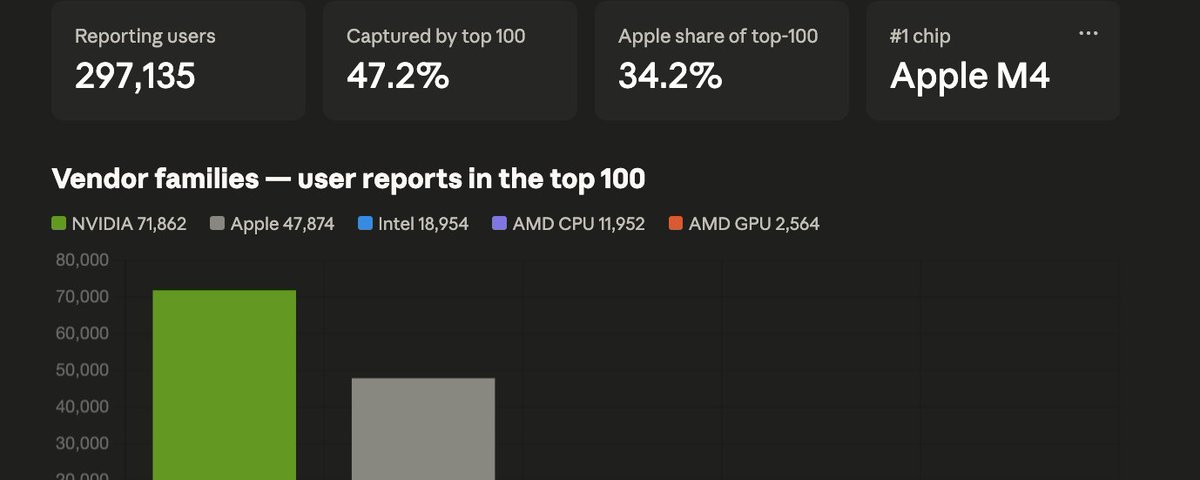
文章基于 Hugging Face 上近 30 万用户的硬件数据,分析了 AI 开发者的主流设备选择。关键发现包括:VRAM 容量比算力更重要(RTX 3060 12GB 最受欢迎);Apple 在 SoC 领域占主导,NVIDIA 统治独立显卡;AMD Ryzen 在 DIY 组装市场(尤其是 CPU+GPU 组合)超越 Intel;M4 芯片普及速度极快。数据揭示了本地 AI 硬件的高度碎片化特征。

技术 › 硬件 clem 2026-05-065.9 KB 115.6K 340 77

Windows 的 Hermes Web-UI 保姆级安装避坑指南

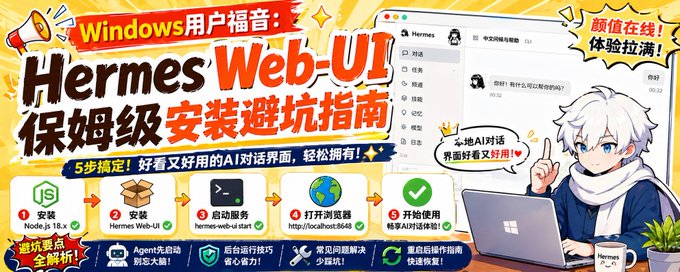
本文是一篇针对 Windows 环境下安装 Hermes Web-UI 的保姆级教程。作者针对现有教程步骤跳跃或过时的问题,详细记录了从配置 Node.js 环境、安装 Web-UI 到启动服务的全过程。文中重点分享了后台运行技巧、与 Hermes Agent 的联动注意事项,以及常见报错的排查方法(如端口占用、无反应等),旨在帮助用户在本地搭建美观好用的 AI 聊天界面。

技术 › Hermes Suu 2026-04-285.4 KB 19K 76 64