如何用自己的数据微调一个小模型
本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。
本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。
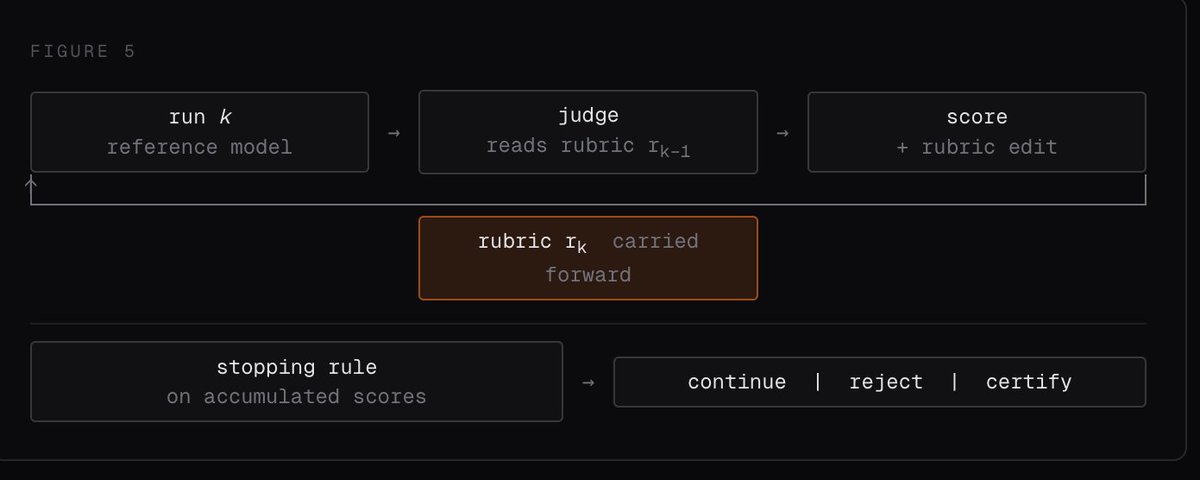
本文介绍如何从数亿条真实生产环境的浏览器代理任务流量中构建可扩展的强化学习环境。方法包括:去重与过滤不当任务、用对齐的标注代理(Gemini 3 Flash)筛选适合的任务、以标准虚拟身份替换个人数据、通过参考模型执行验证任务可行性与难度。文章还探讨了评判问题的核心思路:评分模型无需比代理更聪明,只需看到同一任务的大量尝试分布,从而构建公平稳定的奖励机制。