清华开源 PilotDeck:智能路由的 Agent OS
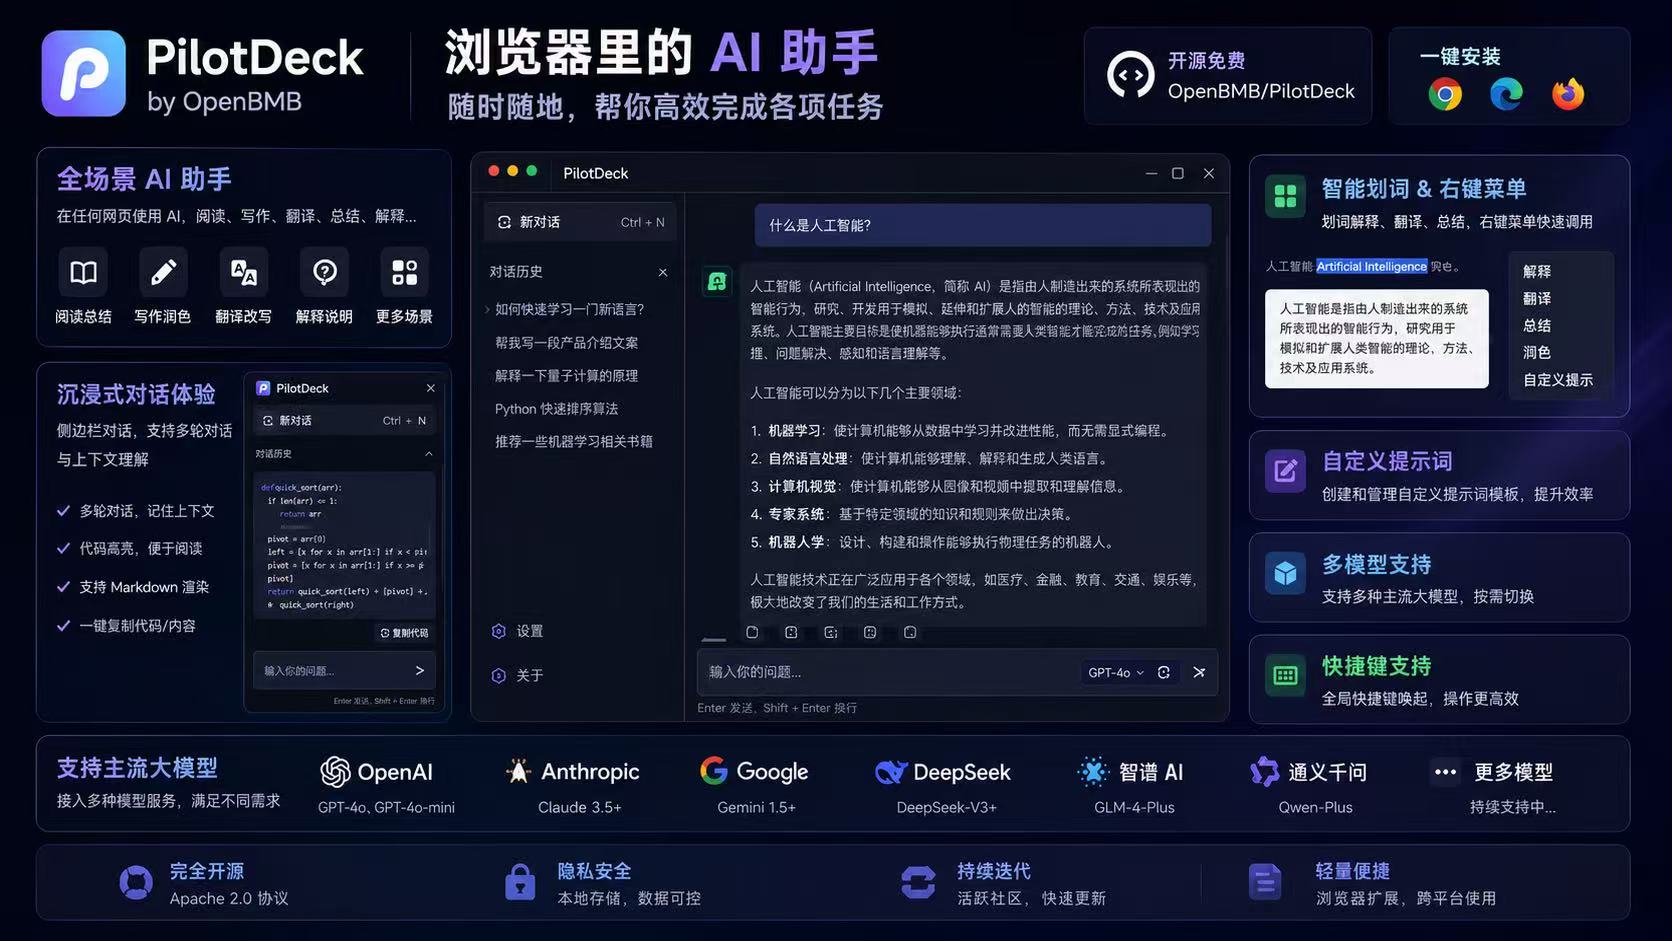
清华大学开源了名为 PilotDeck 的 Agent 操作系统。其核心亮点在于“智能路由”技术,通过自动判断任务难度来分配模型(如主模型搭配小模型),相比纯 Claude 方案大幅降低了成本($3.15 vs $18.36)并提升了分数。系统具备 WorkSpace 隔离、白盒记忆(可追溯、编辑)及 Always-on 后台持续运行三大功能。
清华大学开源了名为 PilotDeck 的 Agent 操作系统。其核心亮点在于“智能路由”技术,通过自动判断任务难度来分配模型(如主模型搭配小模型),相比纯 Claude 方案大幅降低了成本($3.15 vs $18.36)并提升了分数。系统具备 WorkSpace 隔离、白盒记忆(可追溯、编辑)及 Always-on 后台持续运行三大功能。
GitHub 上出现了一款名为 gemini-web2api 的工具,它是一个纯 Python 单文件脚本,无需第三方依赖。该工具能将 Gemini 网页版转化为 OpenAI 兼容的 API 接口,支持流式输出、Function Calling 以及 Flash Thinking 的 20k+ 长上下文。通过 Docker 一键部署,用户可在本地直接利用 OpenAI SDK 调用 Gemini 能力,旨在帮助开发者节省每月 20-50 美元的 API 费用。
文章深入解析了 pi-goal 这一长程目标自动循环工具的源码机制,并设计了高难度的 Karpathy 开源项目洞察任务,对 Gemini、Claude 和 DeepSeek 三款模型进行了同台实测。结果表明,DeepSeek V4 Pro 在成本上仅是 Gemini 的 1/31,质量却更优。文章还发现过度推理会增加幻觉,以及软预算机制可作为模型行为探针,并指出了 pi-goal 在审计验证上的盲区。
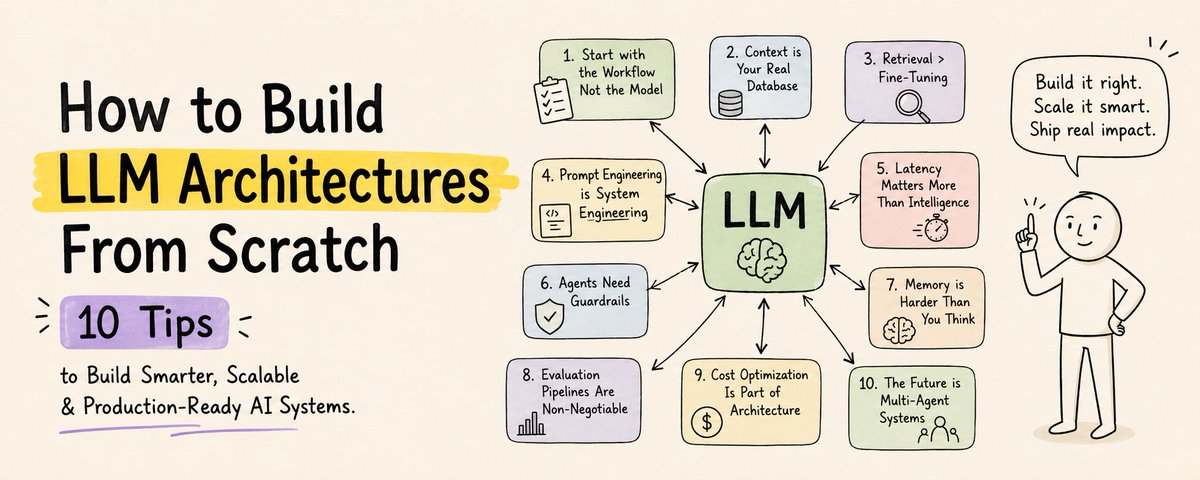
本文指出构建 AI 产品的核心不在于选择模型,而在于架构设计。作者分享了 10 个实用经验,强调从工作流而非模型入手、重视检索优于微调、将提示工程视为系统工程、关注延迟优化、为智能体设置护栏、妥善处理记忆、建立评估管道以及优化成本。最终,多智能体系统将是未来趋势。
本文介绍了如何利用 Kimi K2.6 模型配合 Hermes 系统,将原本使用 Claude Opus 的高昂开发成本(约 $2550/月)降低至 $85/月。文章详细分析了 Kimi K2.6 在 MoE 架构下的性能优势(如 SWE-Bench Pro 58.6%),展示了其在 12 小时自主编码和系统优化中的实战案例,并提出了“辅助模型模式”以进一步节省非关键任务的费用。作者还针对长上下文输出可能导致的成本陷阱提出了具体的优化策略。
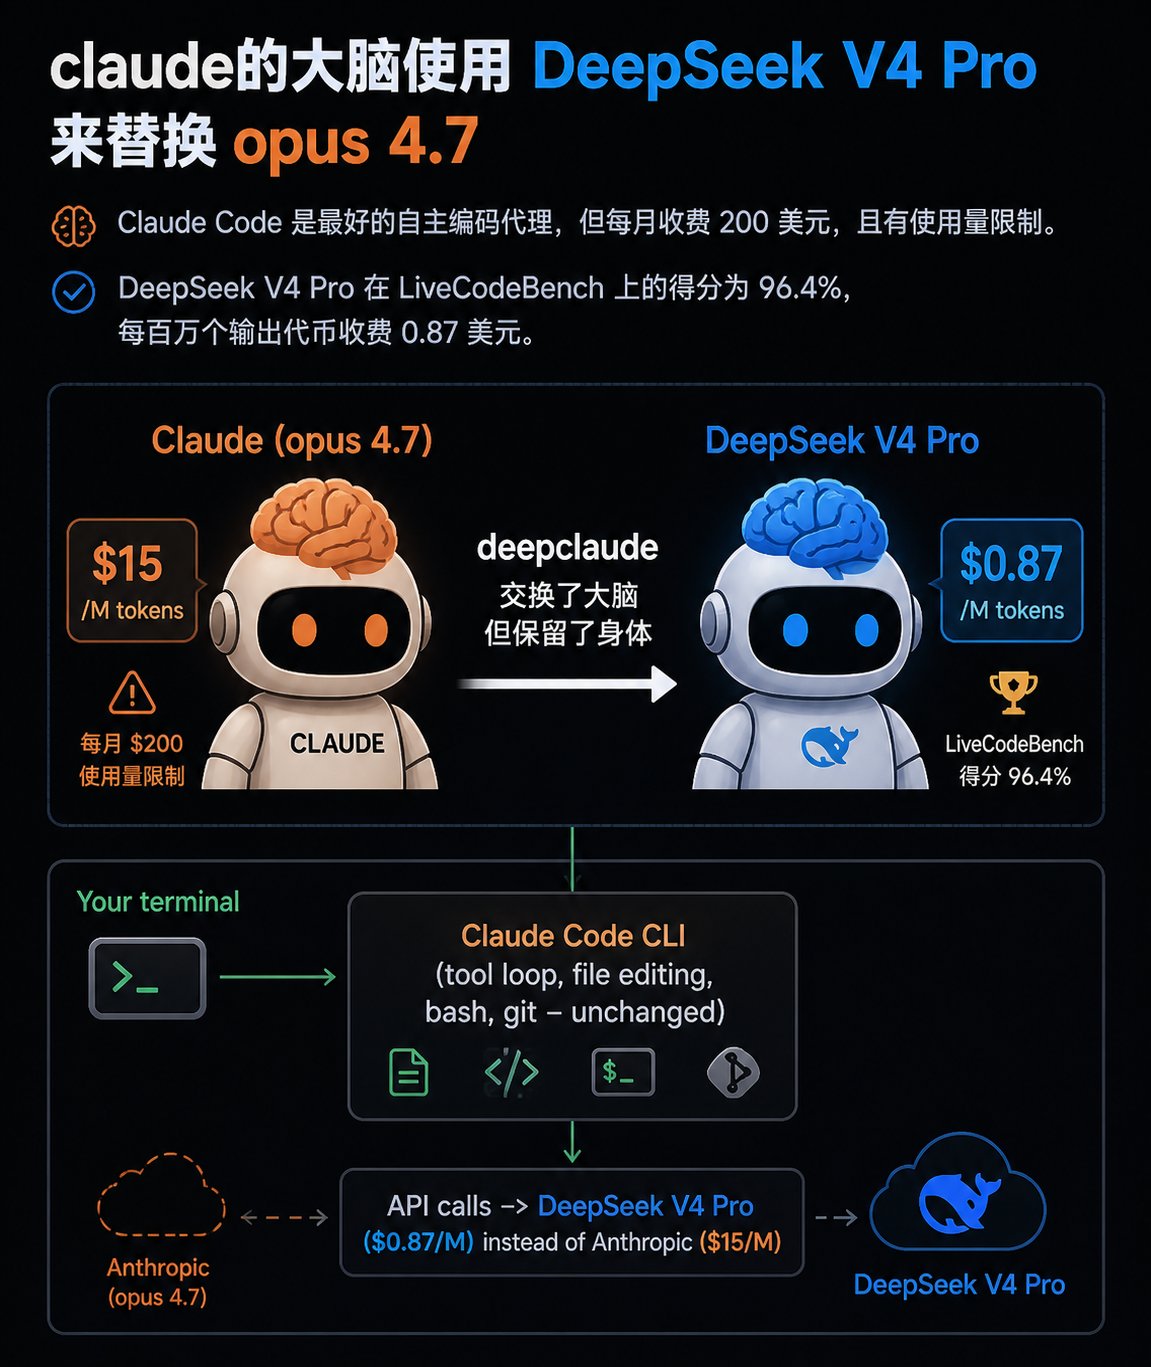
文章首先介绍了 GitHub 项目 deepclaude,通过将 Claude Code 的内核 API 替换为 DeepSeek V4 Pro,实现了在保持性能的同时将 API 成本降低至 1/17,并支持无缝切换后端。随后,文章详细测评了目前主流的 18 款 AI Agent 浏览器和数据采集工具,按功能分为王者派、Rust 派、MCP 派等,并提供了针对不同场景(如自动化、MCP 接入、社媒爬虫)的选型建议。
文章介绍了一种通过结合 NotebookLM 与 Claude 来大幅降低 Token 消耗的工作流。作者指出直接将海量数据(如 50 篇论文)塞进 Claude 对话极其昂贵且效率低下,而利用 NotebookLM 作为免费的“老师”进行语料存储和检索,让 Claude 仅负责推理与编排,可实现 17 倍以上的成本节省。文中详细解析了 RAG 与 Context 的成本差异、Prompt Cache 的局限性,并提供了针对学术论文、招股书阅读及个人知识库的具体操作指南。
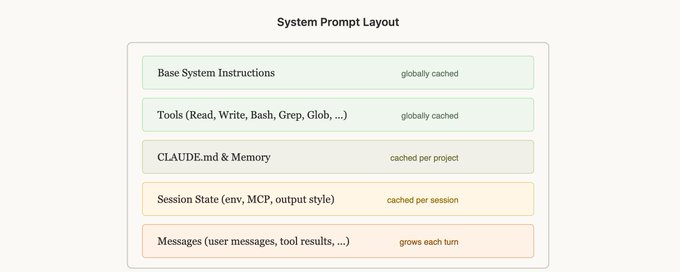
本文深入探讨了 LLM 中的 Prompt Caching 技术,解释了其背后的 KV Cache 机制及静态/动态上下文分离原理。文章通过 Claude Code 的案例分析,展示了如何通过保持 92% 的缓存命中率来将计算成本降低 81%,并总结了哈希敏感性和工程化落地的关键约束。
本文通过本地实验与源码分析,深入解析了大模型的 KV 缓存机制。作者从 Transformer 注意力机制讲起,解释了为何多轮对话会出现 100 倍的加速差异。通过逆向 Claude Code,揭示了 Anthropic 精密的缓存工程策略(前缀匹配、TTL 机制)。最后,给出了具体的 Claude Code 使用姿势(如保护缓存前缀、避免切换模型),帮助用户将 Token 消耗降低 80%,实现同样的套餐多干 3-5 倍的活。
本文列举了25个优秀的开源GitHub项目,可作为Notion、Adobe、Google、Slack等流行SaaS产品的替代方案。文章涵盖了生产力笔记、团队协作、设计、数据分析、开发运维等10个类别,强调自托管不仅能节省高昂的订阅费用,还能确保数据完全归用户所有,是2026年摆脱SaaS依赖的实用指南。
文章通过本地 Gemma4 实验发现大模型对话中存在 100 倍加速的现象,深入剖析了 Transformer 的 KV 缓存原理,并逆向分析了 Claude Code 的精密缓存工程。文章解释了为何连续对话比频繁开启新 Session 更省钱,指出破坏缓存的关键行为(如切换模型、修改 System Prompt),并提供了保护缓存以节省 80% Token 的具体使用姿势。
文章介绍了如何利用 OpenClaw 搭建一套多 Agent 协同工作流。通过设置“小龙虾”、“码力”、“笔锋”和“谋士”四个专精 Agent,并配合 MemOS 共享记忆系统,实现了各司其职、成本优化与质量提升的平衡。作者分享了架构设计、搭建过程、实战数据及踩坑经验,展示了多 Agent 协作在实际任务流转中的高效价值。
文章详细阐述了提示缓存在构建 Claude Code 等 AI 代理中的关键作用。核心经验包括:利用前缀匹配机制规划缓存、通过消息传递更新而非修改系统提示以保持缓存、避免中途切换模型或工具、以及利用“延迟加载”和“缓存安全分叉”等技术优化上下文管理。围绕缓存设计系统架构能显著降低延迟与成本。